go test 拟支持项目自定义静态分析器
Go 团队核心成员 Alan Donovan 提出 Proposal 82464,希望让
提案仍在讨论中,最终配置格式和执行机制可能调整;其方向是让项目级静态分析像普通测试一样进入默认开发流程。
万博体育,服务每一位用户, iman13.co
Go 团队核心成员 Alan Donovan 提出 Proposal 82464,希望让
go test 在运行测试和内置 go vet 检查之外,执行由工作区或模块声明的自定义静态分析器。项目可借此把资源配对、内部 API 约束、架构规则等检查纳入日常测试流程。• 配置方案从早期goanalysis.go注释声明,调整为独立的go.vet文件,支持目录级自治、启用/禁用分析器与范围控制;go test -debug-vetconfig可查看最终配置。
• 分析器继续基于golang.org/x/tools/go/analysis,可声明依赖关系并组成任务图,与单元测试并行执行,复用 Go 构建缓存。
• 提案明确三层定位:内置go vet负责全语言基础检查,go.vet承载模块自身强制规则,gopls面向开发者个人偏好。
• 相关 Proposal 82465 拟将go/analysis核心 API 纳入标准库;当前实现计划由GOEXPERIMENT=vetfiles控制,Alan 已申请 Go 1.28 的 freeze exception,但尚未获批。
提案仍在讨论中,最终配置格式和执行机制可能调整;其方向是让项目级静态分析像普通测试一样进入默认开发流程。
万博体育,服务每一位用户, iman13.co
Discord 用 Rust 重写客户端,弃 Electron 与 React Native
Discord CTO Stanislav Vishnevskiy 宣布以 Rust 重写桌面与移动客户端,项目代号 Phoenix,目标是去掉多余抽象层,直接使用设备 GPU 与原生移动视图,并以一套 Rust core 跨平台共享代码。
• 移动端放弃 React Native,直接使用 iOS 与 Android 原生视图,应用代码经 Rust core 与桌面端共享。浏览器客户端仍以 HTML 渲染,应用逻辑层编译为 WebAssembly;嵌入的网页内容(如 YouTube 视频与 Activities)改为调用系统 webview。
• 早期内部构建数据显示:桌面端两个账号同时登录时内存占用约 290 MB,冷启动近乎即时,而 Electron 版本为 5.5 秒;移动端加载时间低于 2 秒,旧版约 5 秒。官方将内存占用、启动时间与延迟下降列为主要动机。
• 代价是失去浏览器自带的诸多渲染与无障碍能力,包括文本排版、输入法集成、屏幕阅读器无障碍钩子与从右到左语言支持;Parley 等 Rust 库可覆盖部分问题,但需开发者自行整合为一致体验。
Vishnevskiy 表示,希望新客户端能尽快进入用户测试阶段。
Discord CTO Stanislav Vishnevskiy 宣布以 Rust 重写桌面与移动客户端,项目代号 Phoenix,目标是去掉多余抽象层,直接使用设备 GPU 与原生移动视图,并以一套 Rust core 跨平台共享代码。
• 桌面端不再打包 Chromium/Node.js,改用 GPUI:这是 Zed 团队为 Zed 编辑器打造的开源、GPU 加速 Rust UI 框架,而非 Tauri。Discord 自 2018 年起已在基础设施、语音技术及部分现有客户端中使用 Rust。
• 移动端放弃 React Native,直接使用 iOS 与 Android 原生视图,应用代码经 Rust core 与桌面端共享。浏览器客户端仍以 HTML 渲染,应用逻辑层编译为 WebAssembly;嵌入的网页内容(如 YouTube 视频与 Activities)改为调用系统 webview。
• 早期内部构建数据显示:桌面端两个账号同时登录时内存占用约 290 MB,冷启动近乎即时,而 Electron 版本为 5.5 秒;移动端加载时间低于 2 秒,旧版约 5 秒。官方将内存占用、启动时间与延迟下降列为主要动机。
• 代价是失去浏览器自带的诸多渲染与无障碍能力,包括文本排版、输入法集成、屏幕阅读器无障碍钩子与从右到左语言支持;Parley 等 Rust 库可覆盖部分问题,但需开发者自行整合为一致体验。
Vishnevskiy 表示,希望新客户端能尽快进入用户测试阶段。
Codex Sandbox:给 AI Agent 划出内核级安全边界
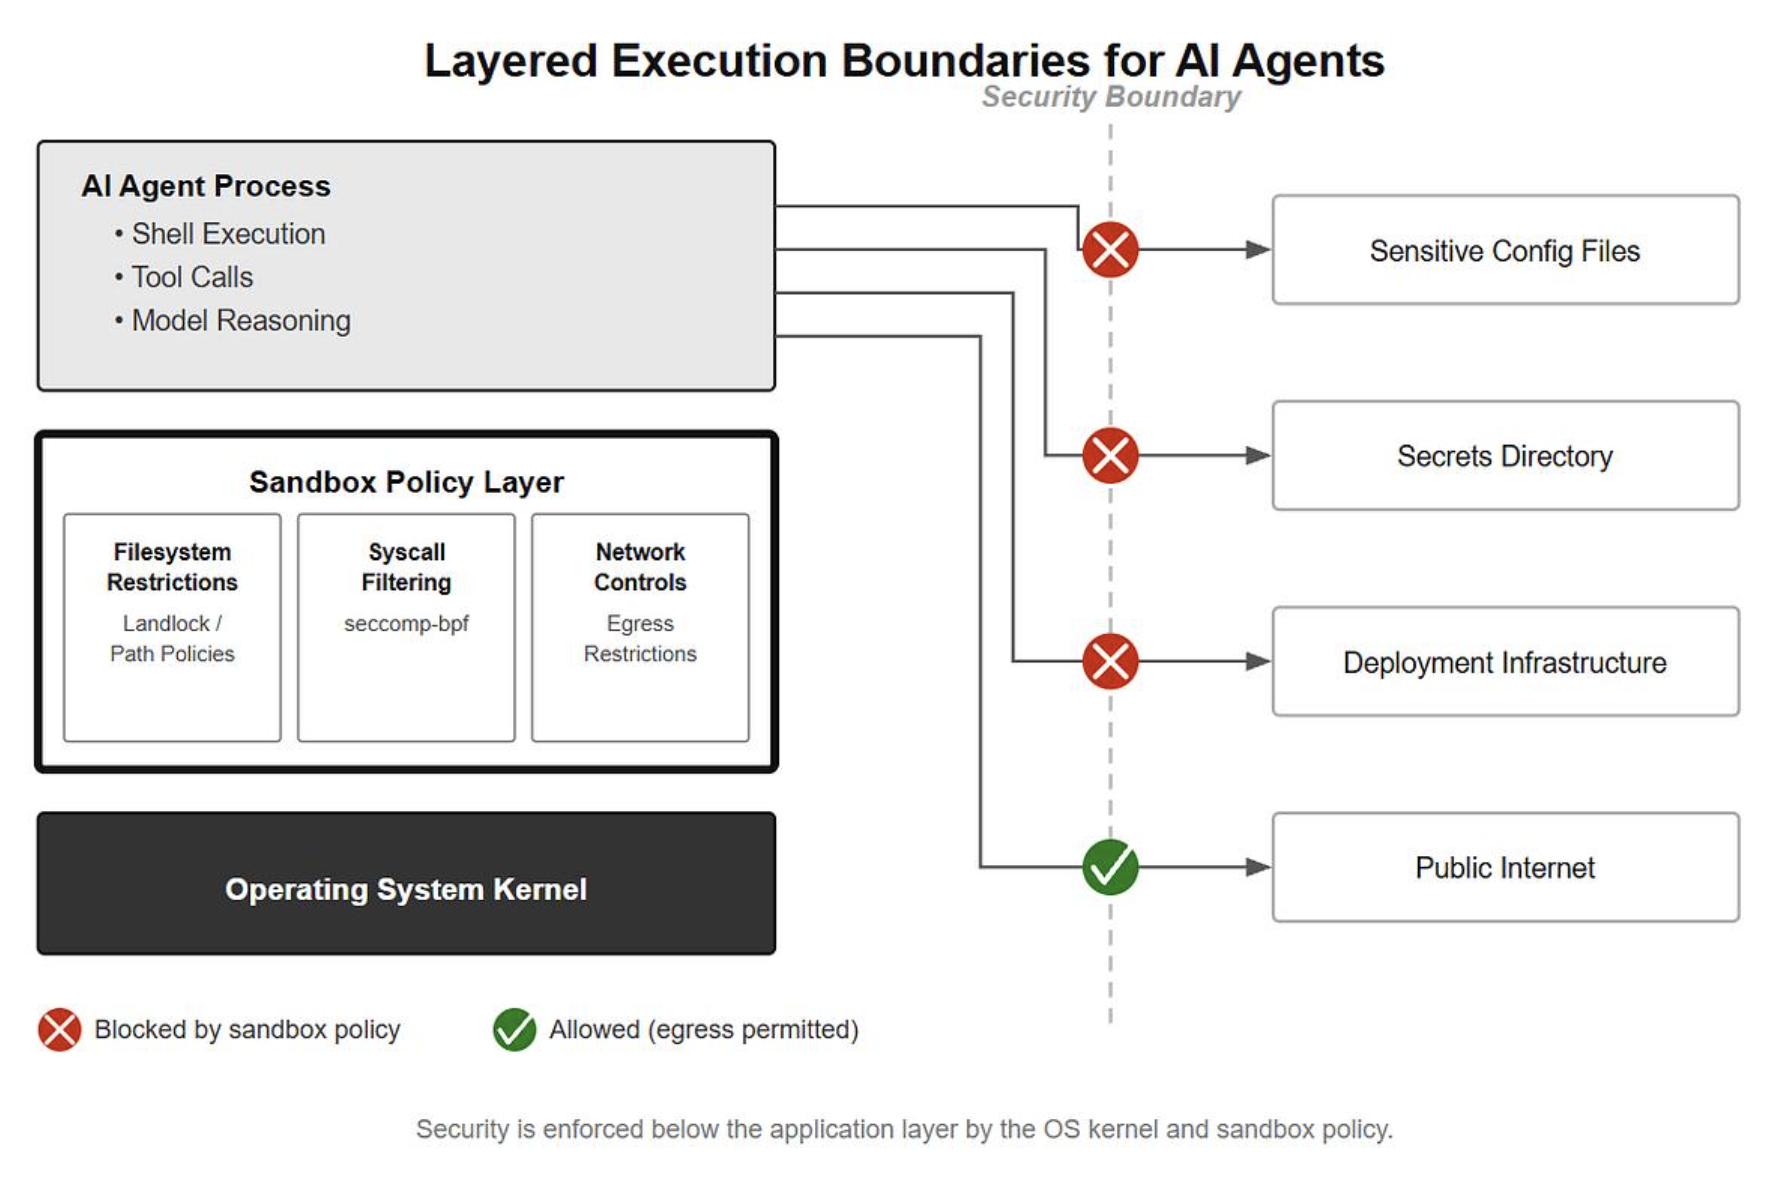
OpenAI 发布工程文章《Inside the Codex Sandbox》,介绍 Codex 背后的隔离设计:由 Harness 负责权限决策、由操作系统负责强制执行,通过文件系统与网络两条边界限制 Agent 的活动范围。
模型的能力决定它能做什么,沙箱决定它犯错时最多造成多大破坏。
万博体育,服务每一位用户, iman13.co
OpenAI 发布工程文章《Inside the Codex Sandbox》,介绍 Codex 背后的隔离设计:由 Harness 负责权限决策、由操作系统负责强制执行,通过文件系统与网络两条边界限制 Agent 的活动范围。
为防止提示词注入或恶意依赖导致私钥读取、凭证外传,Codex 没有把 Agent 塞进 Docker,而是保留开发者真实环境,跨平台封装 macOS Seatbelt、Linux Bubblewrap + seccomp 与 Windows MXC。上层只需提供命令与参数、工作目录、环境变量、权限配置与可选网络代理。
文件系统默认使用:workspace:允许在工作区改代码,但硬性保护.git与.codex,防止植入 Git Hooks 或篡改 Agent 自身策略;同时保留较广的读取范围,因为编译器和构建工具需要访问项目外的 SDK 与系统库。
网络权限分为禁止、完全开放与代理控制三种模式,默认关闭。代理模式按域名规则放行,明确 deny 优先于 allow:[permissions.dev.network]enabled = true[permissions.dev.network.domains]"*.openai.com" = "allow""localhost" = "allow""evil.example" = "deny"
读取权限与外发权限因此分开管理:能读到敏感配置,不等于能把它们发出去。
在执行链路上,Harness 不再直接Popen,而是把命令、permission_profile与network_proxy交给沙箱执行层,约束由整个子进程树继承,避免 Shell 逃逸。提权分为use_default、with_additional_permissions、require_escalated三种请求模式,模型只能申请,不能自行批准。
权限策略通过config.toml中的 Permission Profile 复用,extends = ":workspace"继承内置配置,表结构支持递归合并,团队与企业可维护公共安全基线。
模型的能力决定它能做什么,沙箱决定它犯错时最多造成多大破坏。
万博体育,服务每一位用户, iman13.co
NetWasm 0.10 让 C# Wasm 性能反超 Mono AOT
NetWasm 是把 C# 提前编译为小型独立 WebAssembly 文件的编译器与运行时,输入 Roslyn 生成的 IL,并使用自有运行时和从 .NET 移植的 CoreLib。0.10 系列(0.10.1–0.10.8)集中优化异常处理、数组边界检查、SIMD 与整数除法;基准对象是 WASI 上的 Mono AOT 构建。
NetWasm 0.10 已让 C#→Wasm 的常见路径耗时低于 Mono AOT,但向量、部分数学与复制路径仍有明显差距,迁移前需按目标环境复测。
NetWasm 是把 C# 提前编译为小型独立 WebAssembly 文件的编译器与运行时,输入 Roslyn 生成的 IL,并使用自有运行时和从 .NET 移植的 CoreLib。0.10 系列(0.10.1–0.10.8)集中优化异常处理、数组边界检查、SIMD 与整数除法;基准对象是 WASI 上的 Mono AOT 构建。
• 异常处理:0.10.1 让抛出经过共享函数,由捕获处理器释放栈帧,减少 Wasmtime 对可能抛出或捕获异常的函数的寄存器保存与恢复开销,UI churn 从 17.6 ms 降至 7.9 ms。0.10.2 内联循环中的小型直线方法(含元组交换),跳过同一数组和索引上已做过的检查,10 万个整数的快排从 77.2 ms 降至 54.0 ms。
• DoomSharp:值类型访问器编译为普通字段加载,O3 下循环内的小型分支辅助函数被内联,120 帧渲染从 3595 ms 降至 1934 ms。
• SIMD 与除法:0.10.7 将 Vector128、Vector\<T>、PackedSimd 下沉为 128 位 Wasm 指令,逐元素数组循环每轮处理 4 个及以上元素并保留标量回退;循环不变的 Math 调用外提后,Burgers 方程求解器首个测试从 497 ms 降至 71 ms(Mono AOT 186 ms,桌面 .NET 93 ms)。0.10.8 让除法后的取余复用商,跳过重复的除零与 int.MinValue / -1 检查,试除法测试从 1376 ms 降至 765 ms(Mono AOT 862 ms)。
• 基准与边界:2213 个用例中,0.10.8 在 O3 加 NetWasmGC 下的几何平均耗时是 Mono AOT 的 0.41 倍,排除 5 个 Mono LLVM 消除工作的用例;对桌面 .NET 11 RC3 JIT 为 0.87 倍,0.10.6 为 2.15 倍。按类别,对 Mono AOT 的耗时比从 intrinsics 的 0.34 到 math 的 0.81;DoomSharp 120 帧为 1623 ms,Mono AOT 2371 ms,桌面 .NET JIT 1053 ms。Wasm 仅限固定 128 位操作,桌面 .NET 在向量基准上约快 3.1 倍;Math.Pow 比 Mono AOT 慢 1.4 倍,CopyBlock64 慢 3.3 倍,NewtR 比 0.10.6 慢 1.9 倍,作者归因于 Wasmtime 寄存器分配器在循环周围把值留在栈槽。数据来自 Wasmtime 49.0.3 与 Apple M1 Max 单机自测,作者还发现相同循环在不同地址可差 15%,因此 A/B 测试将每个函数对齐到 4 KiB。
NetWasm 0.10 已让 C#→Wasm 的常见路径耗时低于 Mono AOT,但向量、部分数学与复制路径仍有明显差距,迁移前需按目标环境复测。

只按输入价挑 LLM,写作场景反贵 72%
给副业项目选最便宜的模型,常见做法是打开价目表、按输入价排序、取第一行。对多数项目这没错,但对以生成文本为主的项目,这样可能选错,成本会高出 70%。原因是每个模型都有两个价格,哪个起作用取决于你的调用形态。
先让候选模型在你的样例上过一遍质量关,再用交点公式在通过者之间挑价格。
万博体育,服务每一位用户, iman13.co
给副业项目选最便宜的模型,常见做法是打开价目表、按输入价排序、取第一行。对多数项目这没错,但对以生成文本为主的项目,这样可能选错,成本会高出 70%。原因是每个模型都有两个价格,哪个起作用取决于你的调用形态。
单次调用成本 = 输入 token × 输入价 + 输出 token × 输出价。若模型 A 两列都便宜,A 通吃;但当 A 输入便宜、B 输出便宜时,胜负就由“每输入一个 token 能换回多少输出 token”决定。
• 作者用其所在 LLM 网关目录中 55 个 chat 模型的官方标价(2026 年 11 月 19 日快照)做两两对比:1485 对里有 45 对会翻转,占 3%;在输入价不高于 $0.30/百万 token 的 11 个模型内,55 对中有 3 对翻转,其中一对正是榜首。
• 按输入价排,榜首是 claude-haiku-5.5($0.10 输入 / $0.50 输出),第二是 mimo-v2.6-flash($0.14 / $0.28):读贵 40%,写便宜 44%。
• 四种调用形态按每百万次计:分类工单(600/5)$62.50 对 $85.40,haiku 便宜 37%;RAG(3000/250)$425 对 $490,haiku 便宜 15%;一轮对话(1500/300)$300 与 $294 基本持平;写博客(200/1500)$770 对 $448,haiku 贵 72%。
• 交点可直接算:(a_out - b_out) / (b_in - a_in)。haiku-5.5 与 mimo-v2.6-flash 的交点是 5.5,即每输出 1 个 token 对应的输入 token 超过 5.5 时 haiku 更划算,低于则 mimo 更划算。gpt-5.6($2.00/$12)对 gpt-4o($2.50/$10)交点在 4.0,RAG 省 11%、博客贵 19%;gpt-5 对 grok-4.7 交点在 5.3。
自己的比例不必猜。每次 API 响应的 usage 字段都带输入与输出 token 数,抓一天真实流量,把两列分别求和再相除。长系统提示加历史的聊天机器人可能是 10:1,把要点扩写成邮件的工具可能是 1:5,这个数决定你该按价目表哪一列排序。
这是价格比较,不是模型比较。同价模型答案质量不同,便宜模型重试一次就翻倍;输出长度也不固定,某个模型对同一请求多写 30%,有效输出价就高 30%,交点随之移动。缓存、批量折扣与调价会同时改动两列,适用时需重算。另外 97% 的模型对里,一个模型两列都更便宜,按哪列排序结果都一样。
先让候选模型在你的样例上过一遍质量关,再用交点公式在通过者之间挑价格。
万博体育,服务每一位用户, iman13.co

视频压到 20MB:MB、MiB 与码率余量并非一回事
做「输出必须小于 20MB」的导出功能,看似只是一个上限判断,实际有三处会把结果顶出上限:单位口径、容器开销、码率控制误差。Discord 预设定为 19MB 而非 20MB,就是为了留出这三处差额。
平台上限会变化,预设应放在配置里而不是写死在代码中。
做「输出必须小于 20MB」的导出功能,看似只是一个上限判断,实际有三处会把结果顶出上限:单位口径、容器开销、码率控制误差。Discord 预设定为 19MB 而非 20MB,就是为了留出这三处差额。
• 单位口径:MB 为 1_000_000 字节,MiB 为 1_048_576 字节,同样写 20 时相差 4.9%。19 MiB 等于 19,922,944 字节,在两种口径下都不超过 20 MB 的上传限制;一个显示为 9.77 MB 的结果实际占盘 10,245,113 字节,用 SI 单位的文件管理器会显示约 10.2 MB。
• 容器开销:moov box 中的 per-sample 大小、时间戳、sync-sample 表与 chunk 偏移会随帧数增长,因此 60fps 长片携带的索引比 24fps 短片更多;再加上 ftyp、track header、元数据,以及每帧 AAC 各自的封装条目。通常只是一小部分百分点到几个百分点,但不为零,不预留就会超出码率预算。
• 码率控制不精确:即使 two-pass ABR 也只是接近目标,不会精确命中;VBV 的 -maxrate、-bufsize 允许局部突发,单遍模式漂移更大,上下浮动几个百分点是常态。预算公式为 usableBits = limitBytes × 8 ×(1 - overhead - drift),再除以时长并减去音频码率;1 分钟、19 MiB、overhead 2%、drift 3% 时约为 2397 kbps。这两项百分比是示例假设而非实测常数,需按自家编码器调整。
• 兜底校验:校验封装后的实际文件大小,而不是估算值;超标就按比例降码率重编,newKbps = oldKbps ×(limit / actual)× 0.97,最多重试三次,而不是直接失败或静默放行。
实测中,80.52MB 的 1 分钟 1080p 输入输出 18.64MB,耗时约 15 秒;39.91MB 的 40 秒 VP9 WebM 输出 12.77MB 的 H.264/AAC MP4,只用了约 67% 的预算,因为目标大小是上限而非必须用满。早期版本曾把 19MB 目标做成 20.58MB 的文件,问题出在自身的目标大小处理逻辑,现已修复。
平台上限会变化,预设应放在配置里而不是写死在代码中。

Lovable 网站转 App:先分清网站还是应用
Lovable 生成的网站能变成 App 吗?技术上一小时就能套壳,但 Apple 是否让上架是另一回事——对纯网站,答案通常是不让。审核指南 4.2 要求 App 在功能、内容与 UI 上超越“重新包装的网站”,4.2.2 进一步指出,App 不应以营销材料、广告、网页剪藏、内容聚合或链接集合为主体。带 waitlist 的落地页是营销材料,链接目录是链接集合,博客最多算内容聚合——这恰是多数 Lovable 项目第一天做出来的东西,也是被拒的原因。
结论很直接:别给网站硬加原生功能,而是找出网站里本来就是 App 的那部分,再给它原生能力。
万博体育,服务每一位用户, iman13.co
Lovable 生成的网站能变成 App 吗?技术上一小时就能套壳,但 Apple 是否让上架是另一回事——对纯网站,答案通常是不让。审核指南 4.2 要求 App 在功能、内容与 UI 上超越“重新包装的网站”,4.2.2 进一步指出,App 不应以营销材料、广告、网页剪藏、内容聚合或链接集合为主体。带 waitlist 的落地页是营销材料,链接目录是链接集合,博客最多算内容聚合——这恰是多数 Lovable 项目第一天做出来的东西,也是被拒的原因。
所以第一步要判断手里是网站还是 App,不是写代码。
四个自测问题:是否有人登录后看到属于自己的内容(预约、订单、看板、收藏)?用户是否每周打开一次以上?是否有手机更能发挥的事,如相机、通知、定位、离线?删掉所有营销页面后还剩什么?
两个及以上“是”,网站里就藏着一个 App;零或一个,那就是网站,该做的是把移动端网页做好,不必进商店。
三条路线可以选:
• 保持为可安装网站:iPhone 上可添加到主屏幕并全屏打开,iOS 16.4 起主屏 Web App 能接收 web push。无需审核、费用和等待,代价是几乎没有被发现的机会。
• 用 Capacitor 套壳并补原生能力:同一份代码放进真实 iOS 与 Android 工程,仍在原工具里迭代。但仅套壳在 4.2 下依旧算重新包装,能过审的是上层功能:真正有用的推送、原生分享面板、相机或文档扫描流程、通勤场景的离线存储、已接入 Google 登录时同步提供 Sign in with Apple(满足 4.8),以及 App 内删除账号。认真用上两三项一般就够了。
• 原生重写:React Native + Expo 或 Flutter,接同一套 Supabase 后端。适合信息流、聊天、地图、视频这类全天重度使用的 App,对每周打开两次的预约场景属于过度设计。
审核侧要点:在 App Review Information 中提供已含数据的演示账号,空账号的空列表看起来就像套壳;把原生功能放在第一分钟可见的位置,而不是藏在三层菜单里;有注册就必须有 App 内账号删除;来自开放网络的内容别放进主 tab。Apple 不会因为用 Capacitor 而拒,拒的是浏览器也能做到的事。
一个瑜伽馆项目的实测:课程表、教师介绍、联系表单、信息流,加上跳转第三方预约平台的按钮,套壳提交后约 30 小时被 4.2 拒;加个启动页再交,同条款、同措辞再拒。最终只做了一小块:会员登录查看自己的课程,课前 2 小时推送带“来不了”按钮释放名额,到店扫 QR 签到,营销页留在网站。这一版首次提交即通过。
结论很直接:别给网站硬加原生功能,而是找出网站里本来就是 App 的那部分,再给它原生能力。
万博体育,服务每一位用户, iman13.co

私有桶前缀加数据库元数据:多租户文档存储
多租户 SaaS 接收 PDF、DOCX 和发票时,推荐“私有桶 + 租户/用户前缀 + 每个文档一条数据库记录”。对象存储只存字节,保留与删除决策留在可查询的代码里。
• 每个环境一个私有桶,不按客户分桶。key 形如 tenant_id/user_id/document_id/original-name.pdf;前缀便于列出租户对象,但不是授权系统,API 在签发下载或接受删除前仍要检查数据库行。
• 数据库行是 tenant_id、user_id、document_id、原始文件名、MIME 类型、字节大小、状态和保留时间戳的事实来源。只存对象 key 和可校验的 checksum 或大小;不要把可搜索字段放进对象元数据,对象列表只支持前缀过滤,不支持元数据查询。
• 保留与删除靠可查询代码:定时任务选出 expires_at 已过的行,删除对象,再标记 deleted 或保留 tombstone 供审计。按 tenant_id 和 user_id 可选出用户删除范围;删除顺序与重试策略要显式,字节删除失败不能静默当作合规成功。
• 上传走普通 HTTP 接口,无需额外 SDK;Bearer 认证,创建桶后 PUT 对象,并用 Idempotency-Key,数据库插入放在同一应用流程并使用同一幂等键。下载先按数据库行授权,再生成短时 presigned URL;不要把公开 URL 当作授权替代。生产路径还应校验 MIME、在发第一字节前记录保留日期、记录 provider 请求 ID;对象写成功但数据库行失败时,用对账任务列出前缀并隔离未引用 key。
成本不只看每 GB 单价:对账脚本、客服检索和租户离开后的清理更耗工程时间。前缀减少枚举对象所需代码,数据库元数据避免为回答“哪些发票已过期”去下载对象头。生命周期规则最小粒度为一天,无法表达小时级过期;此处 multipart 碎片没有自动清理规则;若发票需 30 分钟后消失,应运行应用任务并记录每次尝试。没有 If-Match 条件写时,严格 compare-and-swap 要通过队列或数据库事务协调。
选型看你要操作的控制面:Amazon S3 生命周期、版本控制、对象锁和工具生态成熟,但 IAM/策略面更大,成本分散在多种请求类别;Cloudflare R2 兼容 S3 且出网流量友好,需确认保留策略所需的 S3 特性与复制保证;Supabase Storage 适合 Postgres 认证与元数据已在 Supabase 的场景,深度对象控制或独立数据面则较弱。Infrai storage 提供私有桶的普通 REST API 和可预测的前缀/列表流程,适合任何能发 HTTP 的服务用同一把 key 调用,减少安装存储 SDK 的集成依赖;其发现面发布请求 schema 和可运行示例,可缩短集成时间;但它没有公共读 ACL、版本控制、对象锁、跨区域复制或自助浏览器 CORS,覆盖厂商为 r2/s3/oss/cos。它不是专用对象平台的替代品。小型或中型 SaaS 文档桶若想用 REST-only 集成和单一控制面减少运维工作,可试 Infrai,并把元数据与保留策略留在数据库;法规不可变性、版本恢复或跨区域复制是硬要求时用 S3。浏览器直传是它的限制:没有独立 CORS 配置路由,浏览器流程应通过服务端上传。
多租户 SaaS 接收 PDF、DOCX 和发票时,推荐“私有桶 + 租户/用户前缀 + 每个文档一条数据库记录”。对象存储只存字节,保留与删除决策留在可查询的代码里。
• 每个环境一个私有桶,不按客户分桶。key 形如 tenant_id/user_id/document_id/original-name.pdf;前缀便于列出租户对象,但不是授权系统,API 在签发下载或接受删除前仍要检查数据库行。
• 数据库行是 tenant_id、user_id、document_id、原始文件名、MIME 类型、字节大小、状态和保留时间戳的事实来源。只存对象 key 和可校验的 checksum 或大小;不要把可搜索字段放进对象元数据,对象列表只支持前缀过滤,不支持元数据查询。
• 保留与删除靠可查询代码:定时任务选出 expires_at 已过的行,删除对象,再标记 deleted 或保留 tombstone 供审计。按 tenant_id 和 user_id 可选出用户删除范围;删除顺序与重试策略要显式,字节删除失败不能静默当作合规成功。
• 上传走普通 HTTP 接口,无需额外 SDK;Bearer 认证,创建桶后 PUT 对象,并用 Idempotency-Key,数据库插入放在同一应用流程并使用同一幂等键。下载先按数据库行授权,再生成短时 presigned URL;不要把公开 URL 当作授权替代。生产路径还应校验 MIME、在发第一字节前记录保留日期、记录 provider 请求 ID;对象写成功但数据库行失败时,用对账任务列出前缀并隔离未引用 key。
成本不只看每 GB 单价:对账脚本、客服检索和租户离开后的清理更耗工程时间。前缀减少枚举对象所需代码,数据库元数据避免为回答“哪些发票已过期”去下载对象头。生命周期规则最小粒度为一天,无法表达小时级过期;此处 multipart 碎片没有自动清理规则;若发票需 30 分钟后消失,应运行应用任务并记录每次尝试。没有 If-Match 条件写时,严格 compare-and-swap 要通过队列或数据库事务协调。
选型看你要操作的控制面:Amazon S3 生命周期、版本控制、对象锁和工具生态成熟,但 IAM/策略面更大,成本分散在多种请求类别;Cloudflare R2 兼容 S3 且出网流量友好,需确认保留策略所需的 S3 特性与复制保证;Supabase Storage 适合 Postgres 认证与元数据已在 Supabase 的场景,深度对象控制或独立数据面则较弱。Infrai storage 提供私有桶的普通 REST API 和可预测的前缀/列表流程,适合任何能发 HTTP 的服务用同一把 key 调用,减少安装存储 SDK 的集成依赖;其发现面发布请求 schema 和可运行示例,可缩短集成时间;但它没有公共读 ACL、版本控制、对象锁、跨区域复制或自助浏览器 CORS,覆盖厂商为 r2/s3/oss/cos。它不是专用对象平台的替代品。小型或中型 SaaS 文档桶若想用 REST-only 集成和单一控制面减少运维工作,可试 Infrai,并把元数据与保留策略留在数据库;法规不可变性、版本恢复或跨区域复制是硬要求时用 S3。浏览器直传是它的限制:没有独立 CORS 配置路由,浏览器流程应通过服务端上传。
AI 编程 Agent 放大复杂系统失效风险
1998 年 Richard I. Cook 的《How Complex Systems Fail》总结的 18 条原则,被文章纳入 AI 软件工程语境:代码生成成本在降低,但理解、验证和驾驭复杂系统的成本没有同步下降。复杂系统故障往往来自多个微小缺陷的组合;系统长期正常运行,也可能只是冗余和人工补救掩盖了潜在故障。
AI 时代真正要追求的是让构建、理解、验证和防御能力同步增长,而不是更快生成更多代码。
万博体育,服务每一位用户, iman13.co
1998 年 Richard I. Cook 的《How Complex Systems Fail》总结的 18 条原则,被文章纳入 AI 软件工程语境:代码生成成本在降低,但理解、验证和驾驭复杂系统的成本没有同步下降。复杂系统故障往往来自多个微小缺陷的组合;系统长期正常运行,也可能只是冗余和人工补救掩盖了潜在故障。
• 故障传播更快:多个 Agent 协同工作时,需求理解错误会进入任务规格,并被编码、测试等环节并行放大。
• 复杂度增长更快:N 个 Agent 的潜在两两交互为 E = N * (N-1) / 2,从 5 个增到 20 个时,交互关系从 10 增到 190;真实系统未必全连接。
• 可见性下降:一次任务可能包含多轮推理、多次工具调用、动态拆分、Agent 间消息传递和自动重试,缺少完整执行记录时只能看到结果。
• 新防御成为新风险源:AI Code Review 可能漏检,自动修复可能引入回归,自动重试可能放大外部服务压力。
文章主张用五道防线应对:限制自主性、做故障隔离与有限爆炸半径、建立独立验证、让系统可观察并保留审计链、保留人类紧急干预和全局停止机制。安全取决于整个系统持续运行、监测和防御的结果,而不是某个组件的属性。
AI 时代真正要追求的是让构建、理解、验证和防御能力同步增长,而不是更快生成更多代码。
万博体育,服务每一位用户, iman13.co
Oracle PPM 新增按任务产出量计量物理进度
Oracle Fusion Cloud Project Management Update 26D 引入 Track Progress with Task Output Quantities,让项目管理者在预算、实际成本和预测之外,用可计量的工作量衡量任务实际完成情况,而不只依赖手工填写的完成百分比。
该功能适用于交付物可量化的项目;具体的计算行为、校验规则与特殊条件仍需在配置和测试阶段确认。
Oracle Fusion Cloud Project Management Update 26D 引入 Track Progress with Task Output Quantities,让项目管理者在预算、实际成本和预测之外,用可计量的工作量衡量任务实际完成情况,而不只依赖手工填写的完成百分比。
产出量(output quantities / work quantities)指与项目活动绑定的可计量工作单位,例如已安装管道长度、混凝土体积等。它描述的是计划或完成的工作量,与描述资金消耗的财务指标回答的是两个不同问题。
关键配置与使用方式:
• 计划产出量只能维护在财务项目计划的最低层级任务上,并需指定对应单位(unit of measure),计划数量与后续录入的实际数量必须采用同一计量口径。
• 实际完成量通过 project progress entry 录入,作为计算物理完成率的依据。
• 要启用基于数量的进度计算,需在最低层级任务上把 Physical Percent Complete Calculation Method 设为 Output Units,物理完成率按「实际产出量 / 计划产出量 × 100」计算。
• 除物理进度外,功能还提供 Planned Productivity、Actual Productivity 与 Productivity Index 三项指标,用于对比已完成产出与相应资源投入,评估执行效率。
该功能适用于交付物可量化的项目;具体的计算行为、校验规则与特殊条件仍需在配置和测试阶段确认。
Meta 推出 TLX:为 Triton 补上 GPU 底层执行控制
Meta 发布 Triton Low-Level Extensions(TLX),用于填补 Triton 高层 GPU 编程抽象与现代 GPU 底层执行控制之间的空白。开发者仍可使用 Python、autotuning 与 blocked tensor 编程,同时直接控制决定性能的执行结构。
TLX 的定位,正是 Triton 的生产力与 CUDA 的控制力之间。
万博体育,服务每一位用户, iman13.co
Meta 发布 Triton Low-Level Extensions(TLX),用于填补 Triton 高层 GPU 编程抽象与现代 GPU 底层执行控制之间的空白。开发者仍可使用 Python、autotuning 与 blocked tensor 编程,同时直接控制决定性能的执行结构。
• TLX 引入 Multiple Instructions, Multiple Warps(MIMW)执行模型,衔接 CUDA 的线程级控制与 Triton 的块级抽象,覆盖 warp-group 编排、同步、内存编排、cluster 执行与可选 layout 五个方面。
• 现代 GPU 的 warp specialization、异步内存搬运、tensor memory 与 cluster 级执行偏离了 Triton 传统模型。例如 FlashAttention 中一个 warp group 发起 TMA 传输、另一个执行 tensor-core 计算;Blackwell GEMM 需同时协调多个 warp group、TMEM 分配与 cluster 资源。过去实现这些能力要写大量架构专用编排代码。
• 生产验证:GEM 模型训练在数千块 NVIDIA Blackwell GPU 上取得 20–25% 端到端 MFU,前向最高 2x 加速;推荐推理的 In-Kernel Broadcast Optimization 在 H100 上让线性压缩 kernel 提速 4x,计算密集型网络延迟最多降低三分之二;LLM 预训练的分布式 grouped GEMM 在大规模 GPU 集群长时间训练中提升了性能、可靠性与可维护性。
• 后续计划支持更多 NVIDIA、AMD 与自定义加速器架构,以更高层抽象自动完成 warp-group 编排,并接入 torch.compile。
TLX 的定位,正是 Triton 的生产力与 CUDA 的控制力之间。
万博体育,服务每一位用户, iman13.co
给 GPU 装操作系统:回收推理阶段的空闲算力
OpenInfer 的两位研究者在预印本论文中提出,GPU 需要自己的操作系统:像 CPU 操作系统调度前台应用与后台进程那样,让实时推理、训练、评估共享 GPU 的闲置资源,同时保证用户请求的响应时间不被拖慢。
当算力越来越贵,下一场基础设施竞争可能不在于买到更多 GPU,而在于让已有的 GPU 不再空转。
OpenInfer 的两位研究者在预印本论文中提出,GPU 需要自己的操作系统:像 CPU 操作系统调度前台应用与后台进程那样,让实时推理、训练、评估共享 GPU 的闲置资源,同时保证用户请求的响应时间不被拖慢。
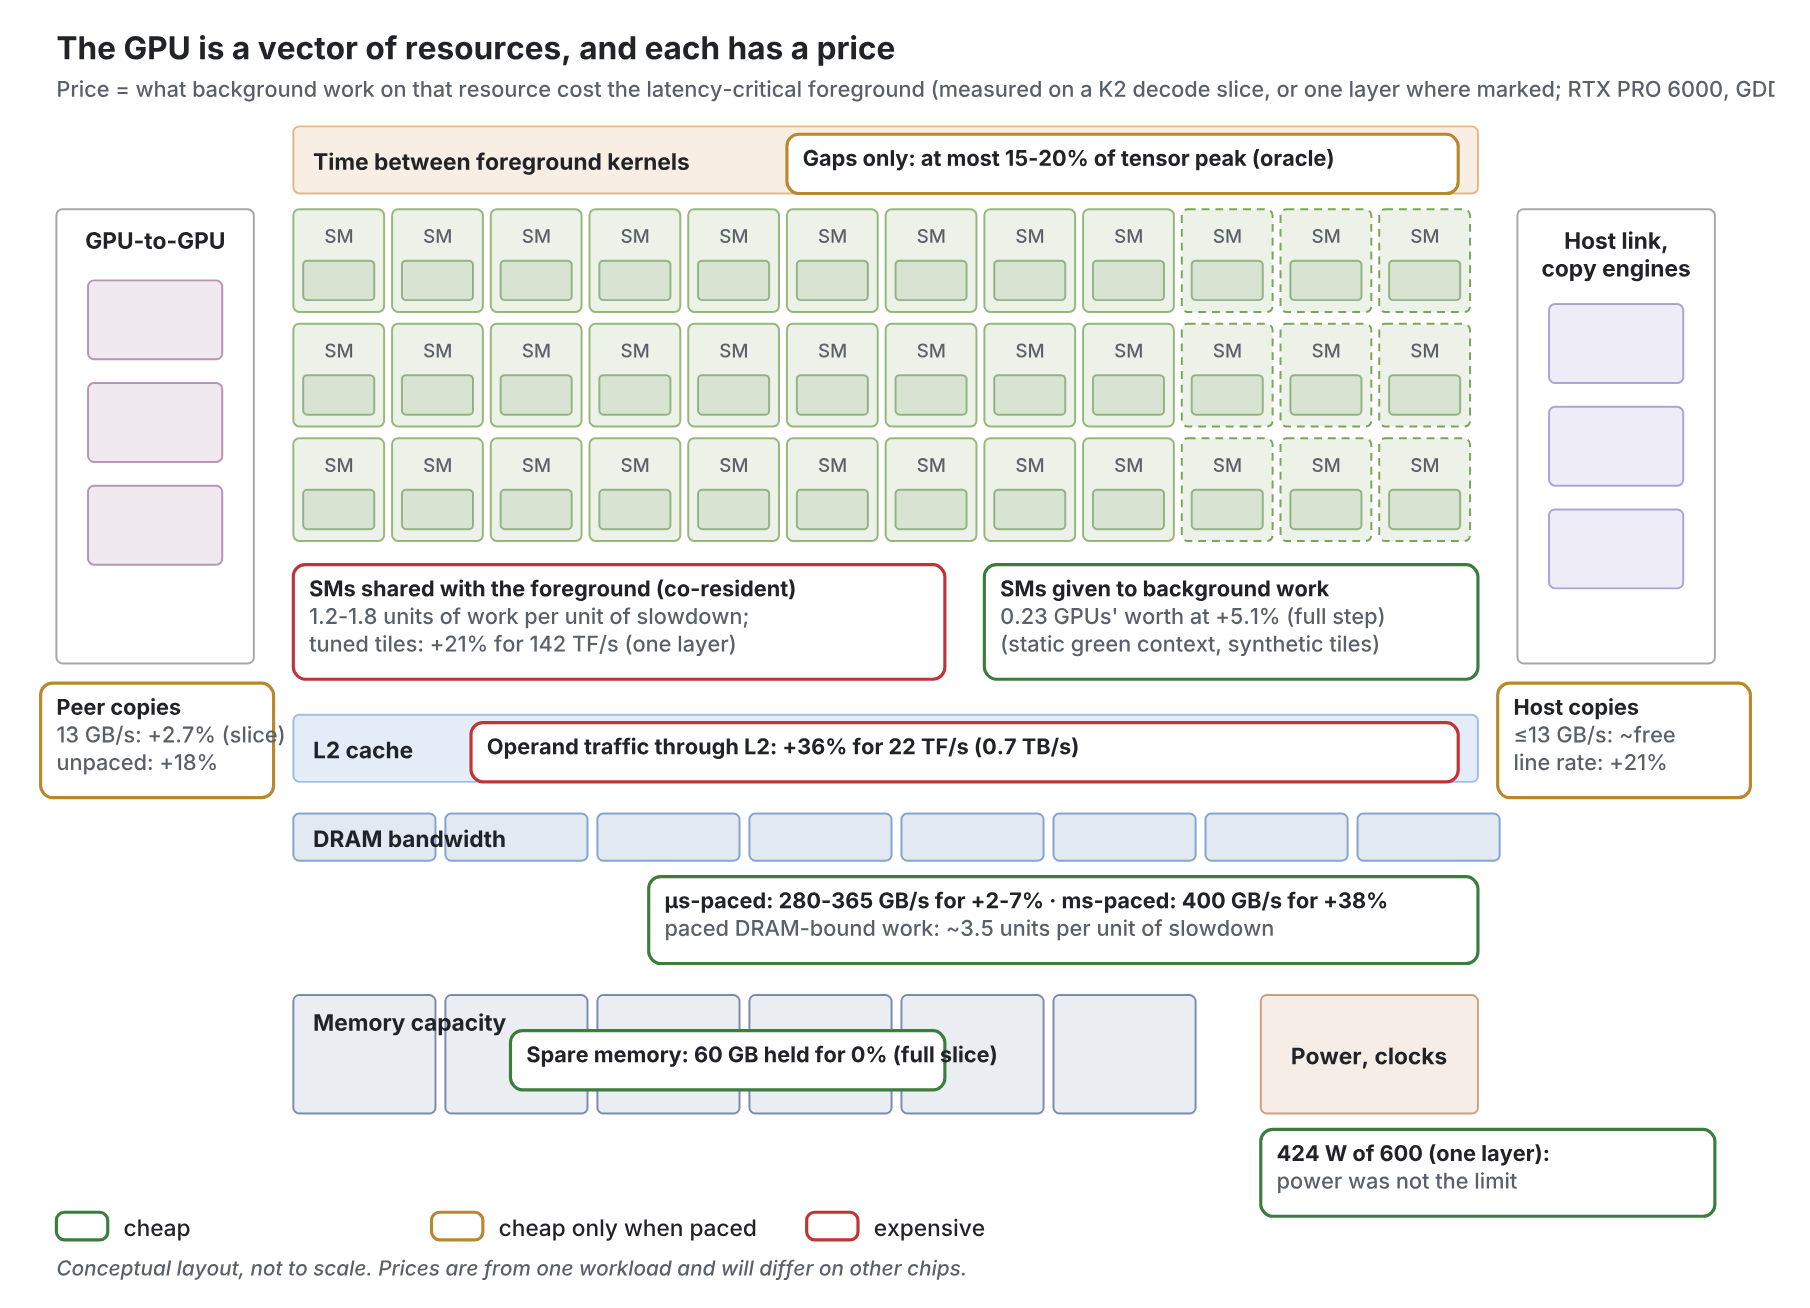
算力闲置是结构性问题。论文用标准 vLLM 部署测得,3970 亿参数的 Qwen3.5-397B,Tensor Core 平均活跃率约 7%;近万亿参数的 Kimi K2 约 6%~11%。原因是 Decode 阶段逐个生成 Token,需要反复读取模型权重,属于典型的 Memory-bound,此时计算单元只能等待显存。论文列出的计算访存比(Ridge)中,RTX PRO 6000 Blackwell 约 280 FLOP/Byte,AMD MI300X 约 250,Google TPU v5e 约 240、v6e 约 560。
• 现有机制不够用:CUDA Stream Priority 不会立即中断已在运行的低优先级 Kernel,论文实验中 1 毫秒的后台任务可让前台延迟放大 10 倍,在 MI300X 上甚至要等 200 毫秒的后台任务结束;MIG 分区固定,重新划分还需重置 GPU;Green Context 能限定 SM 数量,但解决不了显存带宽与缓存竞争。
• 六层架构:L0 芯片硬件能力、L1 可暂停可恢复的 Kernel 执行规范、L2 On-GPU Scheduler、L3 Resource Governor、L4 成本模型、L5 准入控制。调度预算用 Slack 衡量,例如 40 毫秒的任务允许 6% 延迟增长,预算即 42.4 毫秒,多出的 2.4 毫秒留给后台任务。
• 编译器要参与:Kernel 需被拆成几十微秒级、可在安全点暂停并恢复的执行片段,并声明所需资源,论文点名 Triton 与 CUTLASS 需从同一份源码生成适配不同资源分区的版本。
• 实验数据:在 RTX PRO 6000 Blackwell 上,Green Context 方案中合成计算任务回收约 23% 资源、前台延迟增长 5.1%,真实 FP8 GEMM 仅回收约 9%、延迟增长 4.7%;Resident Kernel 系统运行 Llama-3.1-8B,单请求回收 22% 而延迟仅增 0.3%,16 请求回收 24% 而延迟增 1.6%,其 Decode 单请求性能比同硬件调优后的 vLLM 快约 3%。
边界也要讲清楚:后台是寄存器驱动的合成矩阵计算任务,并非完整的训练或评估负载,真实任务还会带来额外的显存与缓存竞争;六层架构尚未全部实现,现有研究只覆盖 L1~L3 的部分能力,成本模型与准入控制仍属未来设计。论文同时向芯片厂商提出微秒级抢占(5~20 微秒内暂停)、显存与缓存优先级、动态硬件分区等需求。
当算力越来越贵,下一场基础设施竞争可能不在于买到更多 GPU,而在于让已有的 GPU 不再空转。

OpenSSH 反扫描机制让后量子探测结果失真
pqc-probe 系列第三篇记录了一个现象:同一台用于测试的 OpenSSH 10.2 服务器(Open Quantum Safe 构建,提供 71 种密钥交换算法),每次探测给出的答案都不同,后量子算法时而可用、时而不支持、时而返回
连接失败并不等于算法不支持,可信的探测需要「是、否、无法判断」三种答案,也需要像礼貌客户端那样约束自己的行为。
万博体育,服务每一位用户, iman13.co
pqc-probe 系列第三篇记录了一个现象:同一台用于测试的 OpenSSH 10.2 服务器(Open Quantum Safe 构建,提供 71 种密钥交换算法),每次探测给出的答案都不同,后量子算法时而可用、时而不支持、时而返回
?。服务器自身没有变化,它只是在按设计防御看起来像攻击的客户端。触发点是 OpenSSH 9.8 引入、默认开启的 PerSourcePenalties,用于减缓密码猜测与崩溃探测:
• 未尝试认证就断开(noauth)罚 1 秒,认证失败或使用无效用户(authfail、invaliduser)罚 5 秒,超出 LoginGraceTime 罚 10 秒,导致 sshd 崩溃罚 90 秒;累计满 15 秒(min)才开始执行,单地址最长封禁 10 分钟(max)。
• 默认按整个 IPv4 /32(IPv6 /128)生效,可用 PerSourceNetBlockSize 调整。
• 在 srclimit.c 中,首次违规只创建一条 deferred 记录,此时并不拒绝连接;此后每次违规把到期时间再推后一个 penalty,剩余时间超过 min 后记录转为 active,该地址的所有新连接在记录过期前一律被拒。
• 因此,它约束的是速率而非次数:每次 noauth 加 1 秒,每过 1 秒真实时间减 1 秒。约每秒一次不会累积,每秒 8 次则约 2 秒后被拒。手册也提示该惩罚可能波及 ssh-keyscan 这类合法扫描工具。
探针踩坑的原因很直接:pqc-probe 为验证某个算法,启动 ssh 时只允许该算法,收到 SSH2_MSG_NEWKEYS 后杀掉客户端,从不登录,对 sshd 而言就是标准的 noauth 断开。面对 71 个算法、两个客户端,并有多条并发连接,几秒内就积累了上百次 noauth 断开。服务端日志显示 penalty 从 deferred 1 秒升级为 activating ipv4 penalty of 16 seconds,随后是 additional 90 connections dropped,而探针把这些被拒连接如实记成了不支持或未知。
修正思路是先问、少测、慢测:ssh -Q kex在本地列出客户端实现的全部密钥交换算法,不产生任何网络流量;再与服务器首包提供的算法取交集,就已经能回答「两者能否协商 X」。真实握手只留给后量子算法,ML-KEM 优先、其次 sntrup,每个客户端最多 8 个(--ssh-verify,设为 0 关闭),经典算法直接标记为支持而不测试。测试串行执行,间隔 1.1 秒,使惩罚余额不会增长。结果分三态:完成交换为 ok(tested),明确报出「no matching key exchange method found」为 fails,超时、重置或连接被丢弃则在 300 ms 后重试一次,仍失败记为?并排除在对比之外,而不是当成否定。改造后 SSH 部分耗时约 20 秒,服务端日志只剩 deferred 1 秒,没有 activating,也没有 drop connection。
对外提供扫描服务时,需按目标服务器地址跨用户限流(6 个并发,之后每分钟 12 次),一分钟内对同一目标的重复请求直接返回先前结果,否则用户喜欢的服务器最终会拒绝你的服务。
运行 SSH 服务器时则应保留 PerSourcePenalties,用 PerSourcePenaltyExemptList 豁免自有监控、资产盘点与 ssh-keyscan 的地址;若扫描器报告后量子支持缺失或不一致,先查 sshd 日志里有没有 activating ... penalty。
连接失败并不等于算法不支持,可信的探测需要「是、否、无法判断」三种答案,也需要像礼貌客户端那样约束自己的行为。
万博体育,服务每一位用户, iman13.co

谷歌广告透明度中心抓取:批量列表请求成本低,获取单条详情受限流影响
谷歌 Ads Transparency Center 汇总经核验广告主在 Search、YouTube、Display、Shopping、Maps 与 Play 上投放的广告,但没有官方 API。作者用自建抓取器对单个域名做实测:以 domain nike.com、region US 为查询,按站点自身排序取前 250 条,间隔几分钟跑两次,结果完全一致。
它并非官方工具,依赖站点内部端点,接口变动就可能失效。
谷歌 Ads Transparency Center 汇总经核验广告主在 Search、YouTube、Display、Shopping、Maps 与 Play 上投放的广告,但没有官方 API。作者用自建抓取器对单个域名做实测:以 domain nike.com、region US 为查询,按站点自身排序取前 250 条,间隔几分钟跑两次,结果完全一致。
• 一个域名对应 8 个广告主账号:Nike, Inc. 193 条、Nike Retail BV 40 条、WPP Media Management 8 条、Nike Japan 4 条,另有 4 个各不超过 3 条。按广告主名称搜索只能命中其中一个,会漏掉代理与地区实体;要精确定位单一账号,用 advertiser ID(AR…)。
• 250 条全部在 11 月 20 日及之后仍有展示,但 232 条首次展示已超过一年,其中 196 条超过三年,近 30 天内首次展示的只有 2 条。关注竞品的新广告素材时,应重点看这几个新 ID;具体做法是定时运行同一查询并比对 creativeId。
• 格式上 235 条文字广告、8 条视频、7 条图片。文字广告的文案通常拿不到文本:此前对 shopify.com 开启详情抓取的 61 条里,44 条为文字广告,仅 1 条文案可直接读取,其余以广告图片形式返回,需 OCR 或视觉模型识别。
• 总量以区间给出:nike.com 美国全平台为 8,000–9,000,Platform 过滤设为 YouTube 后为 3,000–4,000;早晚两次运行结果一致。站点说明该过滤仅覆盖 2023 年 9 月 4 日之后展示的广告。
抓取列表数据本身成本很低:站点通过内部接口每次最多加载 100 条,250 条只需 3 次请求、耗时不到 4 秒,两次均如此。单条详情(全部地区、曝光区间、变体、YouTube 链接)则是一条广告一次请求,限制也集中在这里:单个无代理 IP 以每秒 1 次的速度拿到约 60 次详情后即被转入 “unusual traffic” 页面,42 分钟后仍未恢复;当晚第二轮测试在 11 分钟内约 180 次请求后被拦。需要大量详情时,可以按每 4 秒一次降低请求速度,或准备多个地址。
透明度中心不提供花费、点击与定向关键词;曝光仅以区间呈现,且只覆盖欧盟及少数受监管地区。
抓取器已发布在 Apify,支持输入域名、广告主名称、广告主 ID 或透明度中心 URL,并提供地区、日期、格式与平台过滤;按结果计费,每 1,000 条广告 1.50 美元、每 1,000 次详情查询 2.00 美元。
它并非官方工具,依赖站点内部端点,接口变动就可能失效。
Node.js 招聘检索三级回退架构:让候选搜索可审计
候选检索先解决检索问题,再谈生成。分阶段检索:先查租户私有索引,证据不足再逐级放宽,每条结论附文档标识或链接。
开发工具 Node.js
万博体育,服务每一位用户, iman13.co
候选检索先解决检索问题,再谈生成。分阶段检索:先查租户私有索引,证据不足再逐级放宽,每条结论附文档标识或链接。
• 第一阶段:租户精选候选人集合带硬过滤检索
• 第二阶段:首阶段合格命中过少时,检索策略批准的共享人才池
• 第三阶段:查询公开作品集证据,结果标记为外部、低可信
各阶段输出同一结果契约。回退基于证据而非异常:结果非空也可能因最低分、时效或引用阈值不达标继续回退;外部来源 429 仅重试一次后终止该阶段。
访问控制过滤两次:查询时与合并后再各过滤一次,防止适配器错误与过期 ACL 元数据;缺少租户映射的共享记录按隔离处理。
生成阶段将证据作为编号段落传入,输出 schema 强制引用,[3] 指向存储定位符而非模型编造链接;无段落支撑返回“证据不足”。每阶段设截止时间并记录延迟、命中数、最低分、引用数、超时与重试状态,超时返回已收集证据并标记部分结果。入库以租户、候选人、来源定位符与内容版本派生键做幂等 upsert,并显式删除源端已移除记录。
开发工具 Node.js
万博体育,服务每一位用户, iman13.co
支付回跳页不能当作付款确认
3DS 支付完成后跳转的 return URL 只说明浏览器回来了,不代表交易成功。有团队复盘发现,把
• 用户在验证过程中按返回键,之后又从浏览器历史重新打开回跳地址,订单被过期跳转改成已付款。
• 银行 ACS 确认了验证,但授权在发卡行被拒;回跳仍显示 3DS 成功,订单标记已付却没有资金到账。
• 查询串可被任意篡改,把
修复方式:回跳页只显示“正在核对付款”,不写订单状态。状态变更仅来自带签名的 webhook,或在 webhook 延迟时按 transaction id 发起服务端状态查询。页面轮询自有订单状态约 20 秒,随后提示用户将收到邮件。未付款先发货与已付款未履约的订单随之消失。
3DS 支付完成后跳转的 return URL 只说明浏览器回来了,不代表交易成功。有团队复盘发现,把
/return?status=success 当作已付款会引发三类线上问题。• 用户在验证过程中按返回键,之后又从浏览器历史重新打开回跳地址,订单被过期跳转改成已付款。
• 银行 ACS 确认了验证,但授权在发卡行被拒;回跳仍显示 3DS 成功,订单标记已付却没有资金到账。
• 查询串可被任意篡改,把
status=failed 改成 status=success 就能在测试订单上生效,因为处理逻辑从未校验签名。修复方式:回跳页只显示“正在核对付款”,不写订单状态。状态变更仅来自带签名的 webhook,或在 webhook 延迟时按 transaction id 发起服务端状态查询。页面轮询自有订单状态约 20 秒,随后提示用户将收到邮件。未付款先发货与已付款未履约的订单随之消失。
DataFusion 与 InfluxDB 3.0:数据库走向组件化
Apache DataFusion 主要贡献者、InfluxDB 3.0 核心开发者 Andrew Lamb 提出:数据库正从封闭产品走向可组合的基础设施,AI Coding Agent 正在加速这一趋势。
AI 生成代码也冲击开源协作:DataFusion 曾积压约 400 个未关闭 PR,社区已限制非 Draft PR 数量并将 CI 成本转移至贡献者 Fork。
万博体育,服务每一位用户, iman13.co
Apache DataFusion 主要贡献者、InfluxDB 3.0 核心开发者 Andrew Lamb 提出:数据库正从封闭产品走向可组合的基础设施,AI Coding Agent 正在加速这一趋势。
DataFusion 用 Rust 编写、基于 Apache Arrow 内存模型,定位类似数据库领域的 LLVM,提供 SQL Parser、逻辑/物理计划、优化器、执行引擎与 Extension API。InfluxDB 3.0 的 FDAP 栈即 Flight、DataFusion、Arrow、Parquet 的组合。
• 动态过滤:TopK 算子用 Heap 维护第 10 名边界值并回传 Scan,运行时跳过不可能命中的文件与 Row Group;Logfire 在特定查询模式下提升超过 10 倍。
• Parquet 扩展:Variant 类型支持 Shredding 提取常用字段为独立列;GEOMETRY/GEOGRAPHY 支持边界框空间剪枝;FINITE_VECTOR 面向定长向量,但存储高效不等于具备 ANN 检索能力。
• 分布式难点在 Shuffle:Ballista 与 DataFusion Distributed 分别提供完整框架与可组合扩展,核心权衡在物化中间结果与流式 Shuffle 之间。
AI 生成代码也冲击开源协作:DataFusion 曾积压约 400 个未关闭 PR,社区已限制非 Draft PR 数量并将 CI 成本转移至贡献者 Fork。
万博体育,服务每一位用户, iman13.co