
DeepSeek V4-Flash公测,百万token仅1元
7月31日,DeepSeek V4-Flash正式版API上线公测。每百万输入token定价1元,输出token每百万2元,缓存命中后输入成本降至每百万2分钱。模型支持100万上下文、思考模式、工具调用和Responses API,单账户并发连接上限2500。DeepSeek后续将采用峰谷定价,高峰时段价格翻倍。
DeepSeek把智能门槛降下来后,AI应用从模型竞赛重新变成产品生意。它没有替创业者把饭做好,只是把米价降了下来。
#Web3 #区块链 #DeepSeek #V4Flash #AI应用 #大模型 #Agent #API
@Web3TechTrend
7月31日,DeepSeek V4-Flash正式版API上线公测。每百万输入token定价1元,输出token每百万2元,缓存命中后输入成本降至每百万2分钱。模型支持100万上下文、思考模式、工具调用和Responses API,单账户并发连接上限2500。DeepSeek后续将采用峰谷定价,高峰时段价格翻倍。
按DeepSeek官方换算,1个中文字符约消耗0.6个token,一百万token可读入约167万个中文字符,账面输入成本仅1元。
4月发布预览版时,DeepSeek称其推理能力接近V4-Pro,在简单Agent任务上表现相近。7月31日更新的正式版未改变模型结构和规模,主要重新进行后训练,多项Agent基准成绩已超过V4-Pro预览版。
过去一年,大模型行业聚焦更长上下文、更复杂推理和更自主的Agent,讨论多围绕benchmark与AGI距离。对AI应用创业者而言,更现实的问题是单次任务成本。模型能力决定产品理论上能做什么,调用价格决定团队敢把多少能力放进产品。
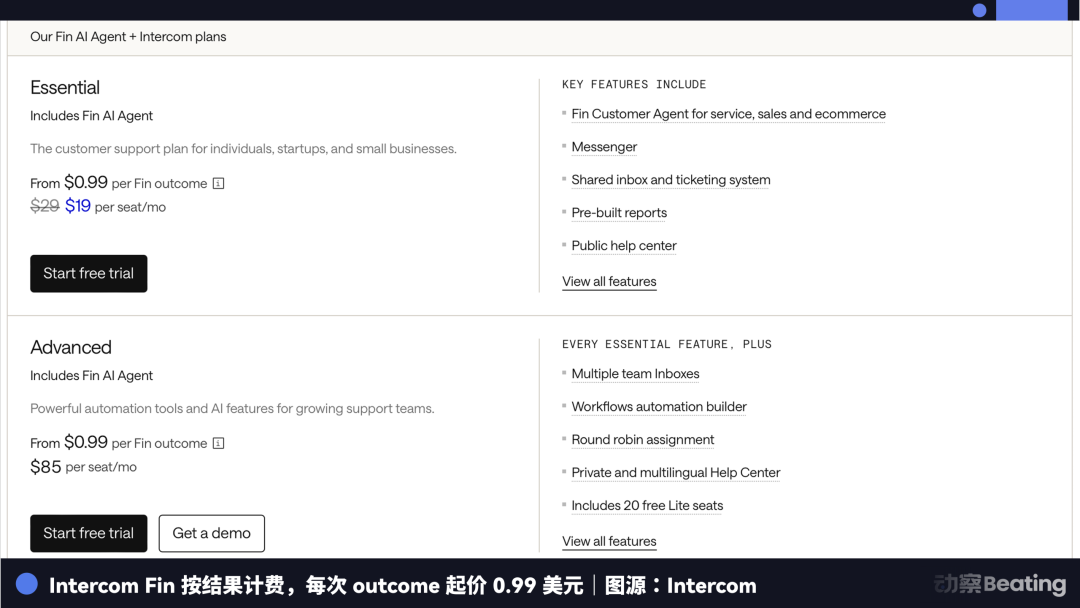
现阶段多数纯软件AI应用的基础商业模式,是从模型公司采购token,将通用能力包装成写作、编程、设计、客服或Agent产品,再通过会员、积分和按次收费卖给用户。Poe推出API时表示,附加点数定价目标即按底层模型供应商收取的价格收费。Intercom为AI客服Fin设计的价格是每完成一个结果收取0.99美元,背后依然要计算完成一次交付消耗的token。
这门生意的利润取决于三笔差价:采购差价,调用量大的团队可谈折扣,利用缓存、异步处理、峰谷调用和模型路由压低平均成本;使用差价,用户群平均消耗低于套餐预估时,未用额度形成利润空间;产品差价,同样消耗一万token,完成资料整理、内容生成、事实核验和格式导出的产品,用户愿意支付的价格远高于只输出草稿的产品。
成本问题也在反向塑造产品。Manus官方使用说明建议简单问题使用Chat模式,不必启动完整自主Agent;复杂任务先检查中间结果,避免Agent沿错误方向执行消耗更多积分。Agent会自行拆分任务、反复搜索、调用工具,用户下达一条指令背后可能发生几十次模型调用,产品公司难以预测成本。一些产品将效果更好的模型塞进高价套餐,普通用户拿到的是经过限流的版本。
DeepSeek的价值在于并非单纯降价的残血模型,而是拥有100万上下文、支持思考模式和工具调用,单位价格下提供尽可能稳定的智能。从公布的Agent和代码基准看,V4-Flash已跨过一批高频任务的够用线,价格低到团队敢于高频调用。它让高价模型变成需要向用户解释的事,击穿的是智能的价格心智。
底层模型稳定后,应用公司竞争的不再是谁先拿到模型,而是谁更懂一项工作,谁能把行业里写不进说明书的规矩变成产品的一部分。模型可以一夜之间变强,行业理解不能;API可被所有人接入,一套被用户接受的工作方式很难照搬。小团队可以先服务一小群人,把一件事情做透再往外走。模型不再是壁垒,真正稀缺的转向用户、数据、流程和信任。
DeepSeek把智能门槛降下来后,AI应用从模型竞赛重新变成产品生意。它没有替创业者把饭做好,只是把米价降了下来。
#Web3 #区块链 #DeepSeek #V4Flash #AI应用 #大模型 #Agent #API
@Web3TechTrend