
Forwarded from 🏆 AIeron | Data Feeling (Aleron Milenkin)
Если вам кажется, что ваша идея сервиса на основе GPT странная, то вот подборка разнообразных нейросетей для необычных целей:
➖ Slick помогает быстро создавать вирусные видео.
➖ FindGPTPrompts – это обширная коллекция промтов для ChatGPT.
➖ Bootstrap предлагает инструменты для управления финансами в стартапах.
➖ BuildTheKeyword помогает находить идеи для привлечения клиентов.
➖ Rapidbott позволяет разрабатывать чат-боты для бизнеса без необходимости программирования.
➖ Superhuman AI – это передовая система электронной почты с ИИ, способствующая командной работе и экономии времени.
➖ HeardLy предоставляет краткие 15-минутные аудиоконспекты книг для ежедневного обучения.
➖ BypassGPT – это инструмент для перефразирования, который помогает избежать обнаружения искусственным интеллектом.
➖ Flot AI интегрирует ChatGPT в различные платформы и инструменты.
➖ MyMap преобразует ваши идеи в визуальные нарративы.
Please open Telegram to view this post
VIEW IN TELEGRAM
Forwarded from Дневник Стьюдента
3 лучших доклада по аналитике
, которые я посмотрел за последнее время
Ранее мы уже говорили про насмотренность, в этот раз хочу посоветовать несколько интересных на мой взгляд докладов:
1. Ценообразование в Яндекс.Еде, Роман Халкечев
Эволюция аналитики в сервисе яндекс еды за последние несколько лет и ключевые улучшения, которые аналитики делали каждый год
2. Динамический минимальный чек в ультра-быстрой доставке продуктов, Никита Бобух
Никита рассказывает, как они находили баланс между спросом и предложением с помощью динамического чека, а также про оценку и улучшение точности прогнозирования курьеров. Очень емкий и структурный доклад
3. «Вечная» контрольная группа, Александр Купцов и Сергей Максимов
Как в Циане выделяли постоянную контрольную группу, чтобы оценивать суммарный эффект от всех фичей и отличать рост продукта от роста рынка. Рекомендую секцию вопросов тоже не пропускать. Сам рассказ начинается примерно с 01:00:00, в видео есть и другие выступления
Напишите в комментариях, какие доклады или статьи за последнее время понравились вам
и ставьте 🐳, если хочется чаще видеть подобные подборки в канале!
, которые я посмотрел за последнее время
Ранее мы уже говорили про насмотренность, в этот раз хочу посоветовать несколько интересных на мой взгляд докладов:
1. Ценообразование в Яндекс.Еде, Роман Халкечев
Эволюция аналитики в сервисе яндекс еды за последние несколько лет и ключевые улучшения, которые аналитики делали каждый год
2. Динамический минимальный чек в ультра-быстрой доставке продуктов, Никита Бобух
Никита рассказывает, как они находили баланс между спросом и предложением с помощью динамического чека, а также про оценку и улучшение точности прогнозирования курьеров. Очень емкий и структурный доклад
3. «Вечная» контрольная группа, Александр Купцов и Сергей Максимов
Как в Циане выделяли постоянную контрольную группу, чтобы оценивать суммарный эффект от всех фичей и отличать рост продукта от роста рынка. Рекомендую секцию вопросов тоже не пропускать. Сам рассказ начинается примерно с 01:00:00, в видео есть и другие выступления
Напишите в комментариях, какие доклады или статьи за последнее время понравились вам
и ставьте 🐳, если хочется чаще видеть подобные подборки в канале!
Forwarded from Лига Хруща // League of Hrusch
Q: Briefly describe two similarities and two dissimilarities of ConvNeXt architecture, compared to ResNet.
A:
Similarities:
1. They are both only utilizing convolution operations for feature extraction (no attention needed)
2. They both utilize residual skip connections in their building blocks
3. They have the same number of "stages", in which operations are performed on the same spatial size, followed by trainable down-sampling, implemented with Conv layer
Differences:
1. Inverted bottleneck - in ConvNext first spatial mixing is performed with depth-wise convolution, then channel mixing using 1x1 convolutions vs in ResNet first squeezing # of channels using 1x1 convolution and then performing combined channel-spatial mixing using 3x3 convolution.
2. Patchify stem - in its stem ConvNext utilizes approach similar to ViT architecture, splitting the images into 4x4 patches with stride 4, effectively converting each of these patches into independent embeddings using convolution vs ResNet uses 7x7 convolution with stride 2 and 2x2 maxpool with stride 2 to achieve 4x down-sampling of the features with respect to the original image, and each "pixel" of the feature map has information about neighboring pixels.
3. LayerNorm instead of BatchNorm - in BN, features are normalized across samples, leading to randomized behavior, and feature statistics are only measured during training, which leads to different behavior during inference, while LayerNorm has similar behavior across stages and does not depend on the input.
4. Less Normalizations and Activations - in ConvNext, normalization is only performed after non-unit-size convolutions (Stem, Inter-stage downsampling, inside Bottleneck blocks), while in ResNet normalization is performed after each convolution. Also, only 1 activation is used inside ConvNext block, between channel mixing stages, against the starnart convention of using activation after every convolution, mimicking the structure of Swin block
A:
Similarities:
1. They are both only utilizing convolution operations for feature extraction (no attention needed)
2. They both utilize residual skip connections in their building blocks
3. They have the same number of "stages", in which operations are performed on the same spatial size, followed by trainable down-sampling, implemented with Conv layer
Differences:
1. Inverted bottleneck - in ConvNext first spatial mixing is performed with depth-wise convolution, then channel mixing using 1x1 convolutions vs in ResNet first squeezing # of channels using 1x1 convolution and then performing combined channel-spatial mixing using 3x3 convolution.
2. Patchify stem - in its stem ConvNext utilizes approach similar to ViT architecture, splitting the images into 4x4 patches with stride 4, effectively converting each of these patches into independent embeddings using convolution vs ResNet uses 7x7 convolution with stride 2 and 2x2 maxpool with stride 2 to achieve 4x down-sampling of the features with respect to the original image, and each "pixel" of the feature map has information about neighboring pixels.
3. LayerNorm instead of BatchNorm - in BN, features are normalized across samples, leading to randomized behavior, and feature statistics are only measured during training, which leads to different behavior during inference, while LayerNorm has similar behavior across stages and does not depend on the input.
4. Less Normalizations and Activations - in ConvNext, normalization is only performed after non-unit-size convolutions (Stem, Inter-stage downsampling, inside Bottleneck blocks), while in ResNet normalization is performed after each convolution. Also, only 1 activation is used inside ConvNext block, between channel mixing stages, against the starnart convention of using activation after every convolution, mimicking the structure of Swin block
Forwarded from Start Career in DS
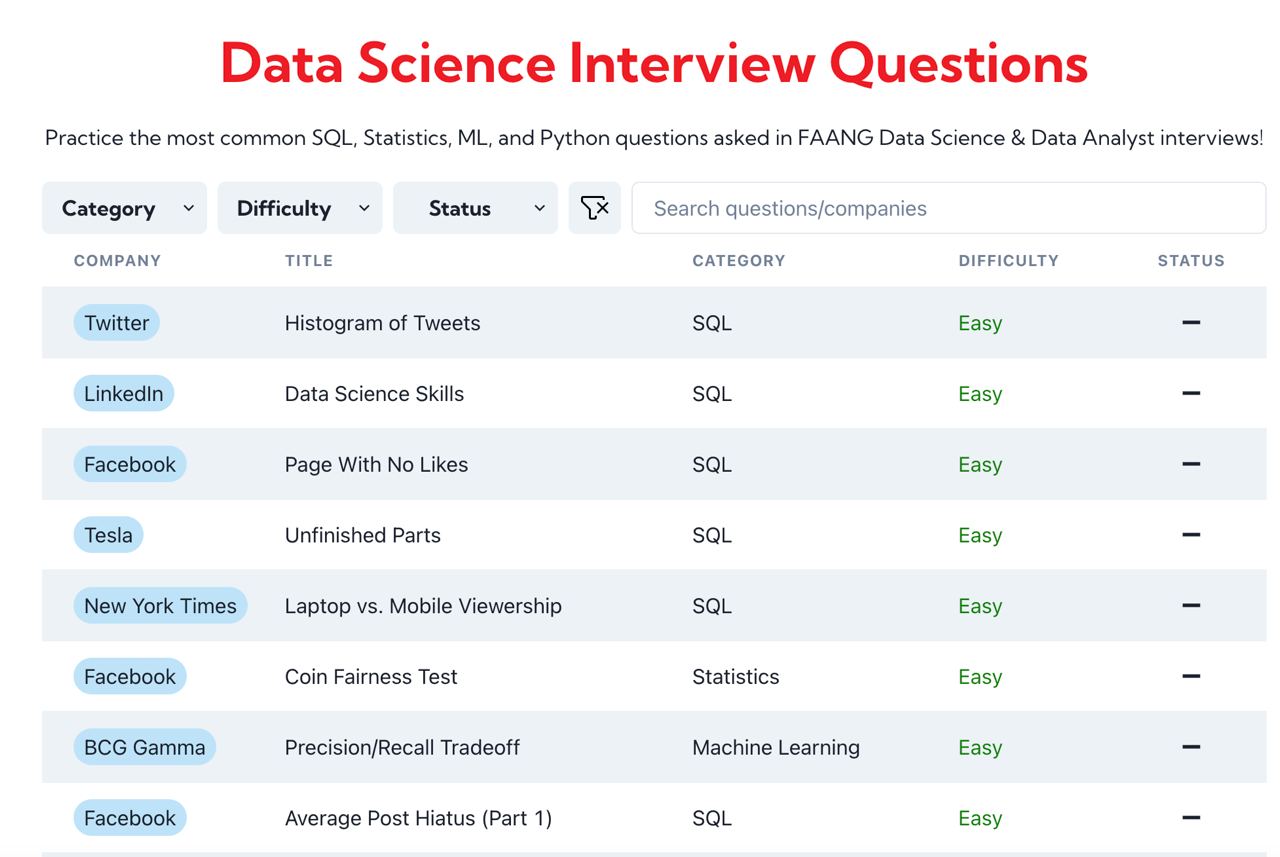
🧑🎓 Leetcode по ML/DS
Думаю, все знают про leetcode, с помощью которого можно отлично натаскаться на алгоритмические задачки.
Нашли аналогичный сервис по ML/DS задачкам, на котором можно попрактиковаться в решении задач по SQL, Python, Теории вероятностей и статистике. В нём собраны задачки, которые спрашивают топовых компаниях вроде Tesla/Twitter/Facebook/Linkedin и т.д.
Отличная штука для того, чтобы попрактиковаться перед собеседованием 🙂
https://datalemur.com/questions
Думаю, все знают про leetcode, с помощью которого можно отлично натаскаться на алгоритмические задачки.
Нашли аналогичный сервис по ML/DS задачкам, на котором можно попрактиковаться в решении задач по SQL, Python, Теории вероятностей и статистике. В нём собраны задачки, которые спрашивают топовых компаниях вроде Tesla/Twitter/Facebook/Linkedin и т.д.
Отличная штука для того, чтобы попрактиковаться перед собеседованием 🙂
https://datalemur.com/questions
Forwarded from Young&&Yandex
Спросили у выпускников Школы бэкенд-разработки, какие полезные материалы они могут порекомендовать для подготовки к вступительным испытаниям в Школу бэкенд-разработки.
Делимся с вами списком:
Регистрируйтесь на Летние школы 2024 по ссылке
Please open Telegram to view this post
VIEW IN TELEGRAM
Please open Telegram to view this post
VIEW IN TELEGRAM
Forwarded from Запрети мне псевдолейблить
Кстати о репостах:
Собрал из ретроспективы по Open Problems пост на хабр. Поддержите заливом лайков, пожалуйста
Собрал из ретроспективы по Open Problems пост на хабр. Поддержите заливом лайков, пожалуйста
Хабр
Как машинлернеры мерили экспрессию генов от воздействия лекарств
Привет! Меня зовут Дима и я веду канал про соревновательный МЛ . Недавно мы выиграли приз в довольно престижном соревновании и я сделал обзор всех лучших решений Хочу вам рассказать о Open Problems,...
Forwarded from Борис опять
Реально clip (BLIP, LiT? не знаю что сейчас сота) проще всего и работает супер.
Видел пару стартапов, которые делают clip as a service. Первая ссылка в гугле вот https://clip-as-service.jina.ai/index.html
Видел пару стартапов, которые делают clip as a service. Первая ссылка в гугле вот https://clip-as-service.jina.ai/index.html
CLIP-as-service 0.8.3 Documentation
Welcome to CLIP-as-service!
CLIP-as-service is a low-latency high-scalability embedding service for images and texts. It can be easily integrated as a microservice into neural search solutions.
Forwarded from Data Secrets
Да кто такая эта ваша LoRA? Разбираемся, кому не угодил классический файнтюнинг и что под капотом у хайповой LoRA. А еще оставляем ссылку на оригинальную статью.