
Forwarded from Мониторим ИТ
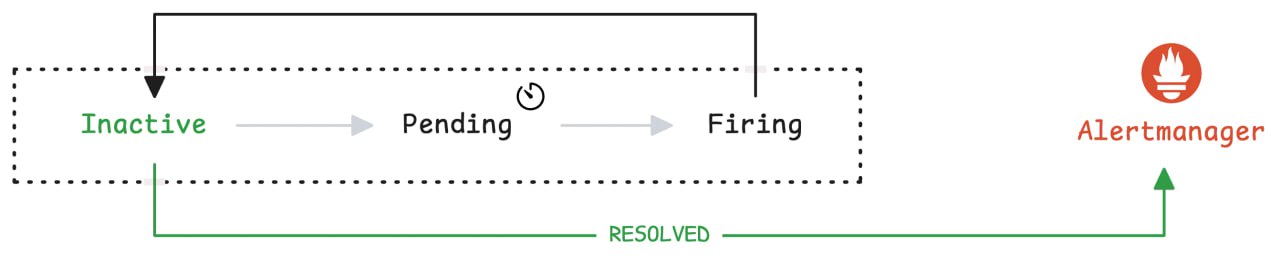
Prometheus Alerting 101: Rules, Recording Rules, and Alertmanager
Четвертая статья цикла в блоге VictoriaMetrics.
Первые три статьи:
🚀 Counters, Gauges, Histograms & Summaries
🚀 Instant Queries and Range Queries Explained
🚀 Functions, Subqueries, Operators, and Modifiers
Четвертая статья цикла в блоге VictoriaMetrics.
Первые три статьи:
🚀 Counters, Gauges, Histograms & Summaries
🚀 Instant Queries and Range Queries Explained
🚀 Functions, Subqueries, Operators, and Modifiers
Forwarded from linkmeup
Хороший заход на попытку объяснить, как работает DNS в линуксах. Но только это не та история, которой уже всем глаза натёрли, про кэши и то, как магия из имени делает циферки, а низкоуровневый заход в ядро, системные вызовы и библиотеки на С.
Начало одобряем, посмотрим, что будет дальше.
https://habr.com/ru/companies/k2tech/articles/919194/
Начало одобряем, посмотрим, что будет дальше.
https://habr.com/ru/companies/k2tech/articles/919194/
Forwarded from Programmer & IT Memes
Please open Telegram to view this post
VIEW IN TELEGRAM
1😁3❤1
Forwarded from ITTales :(){ :|:& };:
Вот вам небольшая пятничная история. Что делать когда Talos Linux сдох, и вот непонятно из-за чего.
Kubernetes API недоступен (не запускается CRI), у вас нет ничего, кроме доступа к Talos API.
Казалось бы всё. SSH нет, доступа на запись тоже нет. Только ребут или как предлагают сами разработчики Talos Linux:
<irony>нода сдохла, выкинь и заведи новую</irony>
Но не всё так просто, а как же отдебажить что там произошло. Собрать информацию, подготовить баг-репорт, отослать разработчикам containerd и Kubernetes.
Я не хочу чтобы такая ситуация повторялась в принципе когда-либо. Встаёт вопрос: как же нам войти в запущенную дефектную систему.
Здесь стоит немного уточнить что в логике Talos заложено запуск двух containerd.
Один - системный, он запускает контейнеры с талосовые демонами и экстеншенами, а так же etcd и kubelet.
Второй - прикладной, он запускает всё что в кубе, в том числе статик поды.
Сделано это намерено, чтобы кубовый ворклоад не мог заафектить систему. Т.к. чаще всего проблемы возникают именно со вторым ввиду активного пуллинга имаджей, а первый containerd остаётся живым. Но как же запустить контейнер для дебага без работающего Kubernetes API? Ответ - никак. Придётся хитрить.
Talos позволяет указать кастомные image для запуска kubelet и etcd. Этим мы и воспользуемся.
Для начала соберём кастомный образ kublet. Добаляем busybox в имадж и слегка модифицируем код:
https://github.com/kvaps/kubernetes/commit/3e45ecd4a2718bc50f2d951c344b4c439f79e3ae
Собираем Dockerfile, пушим его куда-то и заменяем путь до образа в конфиге Talos.
Вуаля, у нас появляется доступ к системе:
kubelet работает с полными административными правами, поэтому его привилегий должно быть достаточно для дебага всего что необходимо.
Kubernetes API недоступен (не запускается CRI), у вас нет ничего, кроме доступа к Talos API.
Казалось бы всё. SSH нет, доступа на запись тоже нет. Только ребут или как предлагают сами разработчики Talos Linux:
<irony>нода сдохла, выкинь и заведи новую</irony>
Но не всё так просто, а как же отдебажить что там произошло. Собрать информацию, подготовить баг-репорт, отослать разработчикам containerd и Kubernetes.
Я не хочу чтобы такая ситуация повторялась в принципе когда-либо. Встаёт вопрос: как же нам войти в запущенную дефектную систему.
Здесь стоит немного уточнить что в логике Talos заложено запуск двух containerd.
Один - системный, он запускает контейнеры с талосовые демонами и экстеншенами, а так же etcd и kubelet.
Второй - прикладной, он запускает всё что в кубе, в том числе статик поды.
Сделано это намерено, чтобы кубовый ворклоад не мог заафектить систему. Т.к. чаще всего проблемы возникают именно со вторым ввиду активного пуллинга имаджей, а первый containerd остаётся живым. Но как же запустить контейнер для дебага без работающего Kubernetes API? Ответ - никак. Придётся хитрить.
Talos позволяет указать кастомные image для запуска kubelet и etcd. Этим мы и воспользуемся.
Для начала соберём кастомный образ kublet. Добаляем busybox в имадж и слегка модифицируем код:
https://github.com/kvaps/kubernetes/commit/3e45ecd4a2718bc50f2d951c344b4c439f79e3ae
Собираем Dockerfile, пушим его куда-то и заменяем путь до образа в конфиге Talos.
Вуаля, у нас появляется доступ к системе:
echo 'uname -r' | nc 192.168.1.21 12345
6.12.18-talos
kubelet работает с полными административными правами, поэтому его привилегий должно быть достаточно для дебага всего что необходимо.
GitHub
Add busybox shell for Talos · kvaps/kubernetes@3e45ecd
Signed-off-by: Andrei Kvapil <kvapss@gmail.com>
👍1
Forwarded from Vadim Rutkovsky
Хвалюсь тулзой на основе VictoriaLogs: https://github.com/vrutkovs/audit-log-stats
Нам часто приходится анализировать audit log кубернетесовских аписерверов и вытягивать оттуда инфу о том какой юзер чаще всего достает ресурсы, сколько времени занимает ответ и разбивка этого времени на части - etcd / webhook / сериализация и т.д. В графане сразу сделан дашборд, который позволяет быстро найти виновника тормозов.
Сами аудит логи это простой jsonl, но зато их очень много и кардинальность улетает в небеса. После долгого мучения с перфомансом локи переделал на VLogs и теперь всё 🚀быстро🚀
cc @valyala
GitHub
GitHub - vrutkovs/audit-log-stats: Build grafana dashboards from k8s audit logs
Build grafana dashboards from k8s audit logs. Contribute to vrutkovs/audit-log-stats development by creating an account on GitHub.
👍1
Сложность метастабильных состояний отказа на примере Такси
Хороший доклад про то как даже при незначительных сбоях системы могут попадать в состояния из которых сложно выбраться и что с этим можно поделать.
https://vk.com/video-17796776_456240927?to=L3ZpZGVvLTE3Nzk2Nzc2XzQ1NjI0MDkyNz8-
#SRE #video #metastable
Хороший доклад про то как даже при незначительных сбоях системы могут попадать в состояния из которых сложно выбраться и что с этим можно поделать.
https://vk.com/video-17796776_456240927?to=L3ZpZGVvLTE3Nzk2Nzc2XzQ1NjI0MDkyNz8-
#SRE #video #metastable
VK Видео
Сложность метастабильных состояний отказа на примере Такси, Алексей Быков
Митап про отказоустойчивость от команды Яндекс Такси Присоединяйтесь к нам в https://t.me/yandexgoinfa — телеграм-сообщество, в котором специалисты обмениватся опытом работы с инфраструктурами, делятся анонсами митапов и полезными материалами. Сайт мероприятия:…
Forwarded from Мониторим ИТ
Kubernetes Monitoring — полное руководство
Это цикл из 10 статей, который объясняет принципы мониторинга кубера по всем канонам наблюдаемости.
Part 1: Architecture
Part 2: Instrumentation, Telemetry, Dashboarding, and Alerting
Part 3: Metrics using the victoria-metrics-k8s-stack
Part 4: Automatically extracting etcd certificates into a secret in Talos with VictoriaMetrics
Part 5: VictoriaMetrics Operator
Part 6: Visualizing with Grafana
Part 7: Alerting
Part 8: Logging with VictoriaLogs
Part 9: Talos Linux System Logs with VictoriaLogs and Vector
Part 10: Kubernetes Event Logging to VictoriaLogs
Сохраняйте в закладки!
❗️Цикл статей опубликован на платформе medium.com
@monitorim_it
Forwarded from DevOps&SRE Library
kubernetes-controller-sharding
Make Kubernetes controllers horizontally scalable by distributing reconciliation of API objects across multiple controller instances. Remove the limitation to have only a single active replica (leader) per controller.
https://github.com/timebertt/kubernetes-controller-sharding
Make Kubernetes controllers horizontally scalable by distributing reconciliation of API objects across multiple controller instances. Remove the limitation to have only a single active replica (leader) per controller.
https://github.com/timebertt/kubernetes-controller-sharding
Forwarded from DevOps&SRE Library
ctrlplane
https://github.com/ctrlplanedev/ctrlplane
A deployment orchestration tool that simplifies multi-cloud, multi-region, and multi-service deployments.
https://github.com/ctrlplanedev/ctrlplane
Forwarded from Виталий
#release Собрал и выложил версию 2.3.0
Новые фичи:
- Поддержан новый метод монтирования ядерных блочных устройств - ublk. Самый быстрый по iops, не всегда самый быстрый по МБ/с (vduse иногда быстрее)
- На ядрах, которые это умеют (6.15+), OSD теперь не будут помечаться как поедающие 100% cpu iowait.
- Добавлена возможнось проверки привилегий на стороне VitastorFS NFS-сервера (по умолчанию клиент Linux NFS их не проверяет).
- Добавлена опция qemu_file_mirror_path для обмана Veeam (собрана пока что в версиях для proxmox 8 и 9).
- Ускорен расчёт CRC32C на стороне OSD сначала исправлением многократного вызова cpuid, а потом вообще задействованием версии из ISA-L с поддержкой AVX512. IOPS-ы записи выросли на ~20%. 😊
- Убрана повторная перезапись одних и тех же блоков - без этого, по отчёту с github, происходило повреждение данных на одной специфической модели SSD: Memblaze PBlaze5 910 (#79)
- Добавлена поддержка QEMU 10, Debian 13 Trixie и Proxmox 9.0
- Ликвидирована зависимость от системного liburing, он теперь по умолчанию собирается статически
Исправления тоже прикольные:
- Контрольные суммы, судя по всему, никогда не включались в vitastor-disk, даже когда это запрашивалось явно. Просто не пробрасывалась опция 😊
- Теперь vitastor-nfs использует uid и gid из заголовка NFS AUTH_SYS - до этого при создании файла/каталога под каким-то пользователем он создавался под root и, например, в случае реэкспорта через samba, пользователь не мог его потом поменять
- Исправлена теоретическая возможность повреждения bitmap-ов объектов в редких случаях при использовании EC N+2+ (т.е. N+K где K >= 2)
- Исправлен баг в antietcd, из-за которого при перезапуске всех osd и мониторов в antietcd оставались старые ключи /osd/state (lease не удаляли истекшие ключи корректно)
- Исправлена cookie записи ".." в NFS - она должна быть 1, а не 0
- Снимки не удалялись при удалении ВМ в Proxmox (тоже PR с гитхаба, #85)
- Исправлена некорректная фильтрация OSD для пула по размеру блока монитором
https://git.yourcmc.ru/vitalif/vitastor/releases/tag/v2.3.0
GitHub
[vitastor-osd] data inconsistency using certain hardware · Issue #79 · vitalif/vitastor
hi, @vitalif We ran into a weird case testing with vitastor-cli dd command, the image data becomes inconsistent after restarting osd. Vitastor Version 2.2.2 OS Version linux 5.10.0-19.el7 Device In...
👍1🔥1
Forwarded from Записки админа
🔓 SystemD Service Hardending - несколько слов о безопасности systemd сервисов.
#systemd #security #hardened
#systemd #security #hardened
Forwarded from Технологический Болт Генона
FlowExporter is a sidecar that runs alongside all Netflix workloads in the AWS Cloud. It uses eBPF and TCP tracepoints to monitor TCP socket state changes. When a TCP socket closes, FlowExporter generates a flow log record that includes the IP addresses, ports, timestamps, and additional socket statistics. On average, 5 million records are produced per second.
. . .

FlowCollector, a backend service, collects flow logs from FlowExporter instances across the fleet, attributes the IP addresses, and sends these attributed flows to Netflix’s Data Mesh for subsequent stream and batch processing.
. . .
As noted in our previous blog post, our initial attribution approach relied on Sonar, an internal IP address tracking service that emits an event whenever an IP address in Netflix’s AWS VPCs is assigned or unassigned to a workload.
. . .
Attributing local IP addresses for container workloads running on Netflix’s container platform, Titus, is more challenging. FlowExporter runs at the container host level, where each host manages multiple container workloads with different identities. When FlowExporter’s eBPF programs receive a socket event from TCP tracepoints in the kernel, the socket may have been created by one of the container workloads or by the host itself. Therefore, FlowExporter must determine which workload to attribute the socket’s local IP address to. To solve this problem, we leveraged IPMan, Netflix’s container IP address assignment service.
How Netflix Accurately Attributes eBPF Flow Logs
https://netflixtechblog.com/how-netflix-accurately-attributes-ebpf-flow-logs-afe6d644a3bc
Предыдущий пост из этой серии
How Netflix uses eBPF flow logs at scale for network insight
https://netflixtechblog.com/how-netflix-uses-ebpf-flow-logs-at-scale-for-network-insight-e3ea997dca96
Спасибо подписчику за наводку
Forwarded from Безумный кот
https://t.me/bezumniy_kot_work/10
🚀 Kubernetes The Hard Way — по-настоящему
Почти два года, тысячи перезапусков, багов, а также сотни пересобранных кластеров и море мата (в голове 😅) — и всё это вылилось в одну, но очень насыщенную статью.
Kubernetes вручную, от и до, без kubeadm и прочих поблажек.
Я собрал: — полный пошаговый гайд по сборке Kuberentes.
— удобные alias’ы, функции и обёртки
— десятки скриптов, которые реально работают в бою
— важные моменты, о которых молчат в туториалах
🔥 Всё это оформлено в удобной документации на MDX структуре, с фокусом на читаемость и практику.
Полную статью можно почитать здесь 👉 Ссылка Тут
Фидбек и звездочки Github приветствуется 🙌
Выложили на Хабр статью с результатами тестирования Angie, HAProxy, Envoy, Caddy, Traefik и расшифровкой стрима с Колей Лавлинским: https://habr.com/ru/articles/946294/
Forwarded from Мониторим ИТ
Forwarded from Человек и машина
#машины_aws
Пожалуй, лучший инцидент, что я когда либо видел.
Если вкратце:
1. Управление DNS записями для DynamoDB отвалилось, в итоге:
2. Эндпоинты DynamoDB (в том числе для внутреннего пользования) отвалились, в итоге:
3. Storage backend, которым выступала DynamoDB, одного из компонентов control plane EC2 отвалился, в итоге:
4. Отвалился NLB, который не мог следить за событиями EC2.
Очень радует, что AWS решил минимальными усилиями решить конкретную проблему, а не сделать отдельный внутренний Kinesis как тогда с инцидентом CloudWatch и Cognito.
Да и не пользуйтесь us-east-1, сколько еще повторять. Новые фичи раньше всех того не стоят.