
Forwarded from эйай ньюз
This media is not supported in your browser
VIEW IN TELEGRAM
OWL-ViT by GoogleAI
Давно не говорили о детекции, друзья.
Гугел сделал уверенный шаг в сторону open-vocabulary detection. Это когда у модели нет набора фиксированных классов, но она умеет реагировать на текстовые запросы. Вы вводите в промпт названия нужных объектов, и модель их находит. Попробовать демку можно на хагинфейсе.
По сути, это предобученный CLIP, где к картиночному энкодеру присобачили голову для предсказания координат баундинг боксов. То есть для каждому токена, полученного из картинки, мы предсказываем координаты и эмбеддинг. Далее этот эмбеддинг сравнивает с эмбеддингом заданного имени класса, и мы получаем similarity для класса. Дополнительные головы файнтюнятся лоссом в стиле DETR. Все подробности в статье.
Внизу схема архитектуры и минимальный код для инференса.
@ai_newz
Forwarded from Habr For Dev
#python #javascript
Языковая модель GPT-3 умеет объяснять код — рассказываем, как это можно использовать
Рейтинг: 45
Читать
Языковая модель GPT-3 умеет объяснять код — рассказываем, как это можно использовать
Рейтинг: 45
Читать
Forwarded from Мишин Лернинг
🧙♂️ Blizzard, увольняйте ваших иллюстраторов
Stable Diffusion разрывает DALL•E 2! Такого арта я ещё нигде не видел! Мне кажется, что время когда, нейронными сетями можно делать полноценные иллюстрации настало.
Представляю: Коллекцию генеративного арта «Blizzard WarCraft». Более 50 артов, сгенерированных нейронной сетью.
Иллюстраторам уже стоит начинать бояться..
🫵 Коллекция Blizzard WarCraft
Forwarded from Denis Sexy IT 🤖
Media is too big
VIEW IN TELEGRAM
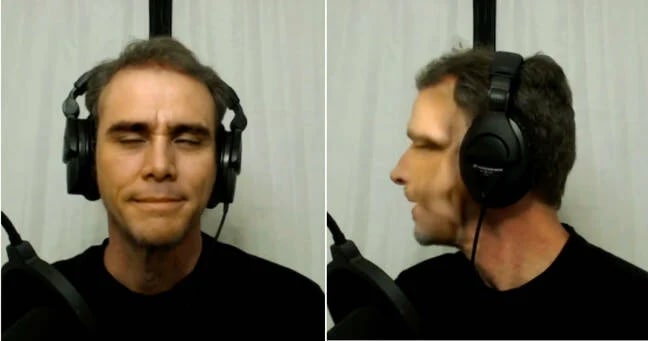
Современные проблемы требуют современных навыков – если вам позвонили с видео, и вы думаете, что вам звонит не настоящий Николас Кейдж человек, а дипфейк – то просто попросите его повернуть голову боком, как на видео – тут маска и слетит.
Тут целый блог пост почему это происходит, но самое главное я пересказал.
Если вы думаете, что технология таких дипфейк-звонков сложная и вы вряд ли встретите, то на самом деле нет – еще пару лет назад звонил коллегам по слаку ради фана, облачаясь в их же лицо, сейчас это еще проще стало ¯\_(ツ)_/¯
@Denis
Forwarded from Neural Shit
И в чём он не прав?
Обновил чуть-чуть нейронку для бота, который генерит мудрости с волками.
Понажимать, как и раньше можно тут: @neural_wise_wolf_bot
Обновил чуть-чуть нейронку для бота, который генерит мудрости с волками.
Понажимать, как и раньше можно тут: @neural_wise_wolf_bot
Forwarded from Python Academy
Находим опечатки в тексте
Полезный пакет
Под капотом модуль использует алгоритм расстояния Левенштейна. А сам код основан на статье, написанной в блоге Питера Норвига. Короче, реализация интересная, советую поизучать.
Но даже если не вникать в подробности, то пакет использовать крайне легко. Примеры использования класса
Пакет поддерживает 6 языков, включая русский. Но за подробностями отправляю вас читать документацию.
#spellchecker
Полезный пакет
spellchecker позволяет находить опечатки в тексте и даже дает возможные варианты исправлений. Под капотом модуль использует алгоритм расстояния Левенштейна. А сам код основан на статье, написанной в блоге Питера Норвига. Короче, реализация интересная, советую поизучать.
Но даже если не вникать в подробности, то пакет использовать крайне легко. Примеры использования класса
SpellChecker и его методов correction и candidates показаны на картинке. Пакет поддерживает 6 языков, включая русский. Но за подробностями отправляю вас читать документацию.
#spellchecker
Forwarded from Чёрный Треугольник
Чтобы раскрыть Deepfake видеозвонок, попросите звонящего повернуться боком🤔
Всего за несколько лет дипфейки продвинулись от способности накладывать лица на изображения до полной замены лица в режиме реального времени, что привело к увеличению количества дипфейков, используемых в онлайн-мошенничестве и киберпреступности.
🔻В июне ФБР предупредило о мошенниках, использующих технологию дипфейка во время удаленных собеседований.
🔻По данным стартапа Sensity AI, занимающегося борьбой с онлайн-мошенничеством, дипфейковые видео также использовались для обмана программного обеспечения для распознавания лиц в реальном времени.
🔻Европейский союз принял законы, налагающие штрафы на компании, которые не в состоянии в достаточной мере бороться с дипфейками.
🔻Китай также разработал законы о дипфейках, которые угрожают юридическим наказанием за неправомерное использование технологии, а также требуют предоставления разрешения на любое законное использование дипфейков.
Все это открывают новую эру интернет-неуверенности, что ваш онлайн-собеседник на самом деле настоящий.
☝🏻Однако, новые исследования компании Metaphysic.ai обнаружили у большинства популярных Deepfake-программ один и тот же недостаток: 90-градусный поворот головы в сторону делает очевидным, что человек на экране не тот, кем он казался.
Не имея возможности видеть достаточное количество контрольных точек, программное обеспечение просто не знает, как спроецировать свое фальшивое лицо.
«До тех пор, пока мы не узнаем, что дипфейкеры не нашли способ обойти этот недостаток, хорошей идеей будет придерживаться политики — попросить человека на другом конце видеозвонка показать вам его лицо сбоку» — отмечают исследователи.😉
Forwarded from Python - Советы, библиотеки, гайды
FastPhotoStyle – инструмент на основе нейронной сети позволяющая объединять изображения в нечто новое.
Детали алгоритма, лежащего в основе кода, задокументированы в статье arxiv.
При наличии фотографии содержимого и фотографии стиля код может передать стиль фотографии стиля фотографии содержимого.
Проект находится здесь :3
Детали алгоритма, лежащего в основе кода, задокументированы в статье arxiv.
При наличии фотографии содержимого и фотографии стиля код может передать стиль фотографии стиля фотографии содержимого.
Проект находится здесь :3
Forwarded from Мишин Лернинг
This media is not supported in your browser
VIEW IN TELEGRAM
✨ Вышел StableDiffusion — Разбираем подробно что нас ждет дальше и что это такое!
📇 Начнем с новостей:
StableDiffusion вышел в Stage I: ресерчеры смогут получить доступ к модели уже сегодня! Для этого веса нужно будет запросить. Но не стоит расстраиваться.
Публичный релиз состоится в ближайшее время, как только будут завершены последние этапы подготовки модели к "публичной жизни". А еще сегодня ожидается последняя волна инвайтов на закрытое бета тестирование в котором уже приняли участие 10,000 юзеров, генерируя около 1,7M изображений за сутки.
🌬 Что такое StableDiffusion?
StableDiffusion — это диффузионный Text2Image (как и DALL-E 2) и очень удачный гибрид Latent Diffusion и Imagen:
> Latent Diffusion (LDM) позволяет в производить диффузию на в пространстве пикселей, а в латенщине. Вместо разрешения 64х64 — выходит сразу 512, благодаря Encoder-Decoder подходу. Если короче: деталей больше, а вычислений меньше.
> От LDM StableDiffusion отличает тот факт, что интформация от текста течет с frozen LM (а именно CLIP), как в случае с T5 в Imagen. SD это модуляр, состоящий из 3х модулей:
1. Frozen CLIP Text Tower (как LM)
2. U-Net (из diffusion beat gan )
3. VQ decoder из 64х64х4 в 512х512х3
> Оказалось что CLIP вектора куда лучше шарят изображения и они выходят прям очень-очень крутыми (все же клип учился на изображениях и LM косвенно тоже)! И хотя понимание отношений объектов (кто слева, кто справа, и тд) чуть лучше и T5, но качество картинки у CLIP лучше на порядок!
Модель сделали ребята из StabilityAI и CompVis, обучая SD 0.8B на супер компьютере Ezra-1 AI UltraCluster, состоящим из 4,000 A100, используя для трейна 2B пар изображение-текст из датасета LAION 5B, файнтюня модель на LAION-Aesthetics (сабсете).
✨ Для генерации нативного 512x512 изобрадения хватит 10 GB VRAM. Так что все от 2080ti до 3090ti кажется хорошим вариантом для дома! Ну и в Colab модель конечно же тоже влезет, даже в бесплатный!
📇 Blog Post
💻 Code StableDiffusion
👁 Веса Модели model card
🤖 Мишин Лернинг ✖️ Н е й р о э с т е т и к а
Forwarded from Мишин Лернинг
🧲 Бэкбоны на трансформерах уже Detectron 2 от Facebook AI Research
Трансформеры (ViT, Swin) для задач компьютерного зрения уже стали новой нормой. Вот и претрененные бэкбоны для Mask R-CNN и Cascade Mask R-CNN завезли!
Я по-прежнему считаю, что ViT — одна из самых гениальных архитектур современности! Вы просто посмотрите на эти метрики:
📣 ViTDet — ViT-H Cascade (multiscale) 53.1 в задаче Instance Segmentation on COCO без обучения на дополнительных данных!
Новость взял у эйай ньюз
📑 Paper: Exploring Plain Vision Transformer Backbones for Object Detection
🗃 ViTDetот Facebook AI Research (код и веса моделей)
Forwarded from эйай ньюз
Опачки! Яндекс запустил потоковый перевод трансляций в своем Браузере в открытую бету.
Ранее Яндекс писал о своей технологии перевода обычных YouTube-видео, и уже тогда перевод и озвучка трансляций заявлялись как следующий шаг – круто, что от идеи до открытой беты прошло меньше года. Только задумайтесь: уже доступен автоматический голосовой перевод в реальном времени! Интересно, куда инженерная мысль полетит дальше.
В отличие от уже загруженного целиком видео, где нейросеть получает сразу весь текст и может оперативно его обработать и озвучить, трансляции нужно переводить в режиме реального времени – примерно так, как работают синхронные переводчики. В итоге команда браузера разработала новую архитектуру перевода, за него отвечают аж 5 нейросетей:
1. Одна нейросеть распознает аудиодорожку и превращает её в текст.
2. Вторая нейросеть по биометрии понимает пол спикера.
3. Третья нарезает текст на предложения — расставляет знаки препинания и выделяет из текста части, содержащие законченную мысль. Это помогает делать правильную интонацию при озвучке и переводить быстро, близко к режиму синхронного перевода
4. Четвертая нейросеть переводит полученные куски текста с исходного языка на русский,
5. A пятая синтезирует речь на русском языке
Конечно, происходит это все равно с задержкой, пока она составляет от 30 до 50 секунд. В будущем команда планирует работать над ее уменьшением.
Чтобы протестить бету, нужно через Яндекс браузер на компьютере, например, эту трансляцию, которая идет постоянно. Технология сейчас работает для перевода стримов не на всех YouTube-каналах. Далее планируют добавлять новые языки и расширять список доступных для перевода трансляций.
Хабр
Как Яндекс помогает преодолеть языковой барьер: нейросетевой перевод видео, картинок и текста
Недавно мы впервые показали прототип переводчика видео в Яндекс.Браузере. Прототип работал с ограниченным числом роликов, но даже в таком виде вызвал интерес у пользователей. Теперь мы переходим к...
Forwarded from эйай ньюз
🔥Stable Diffusion - топовая генеративная модель, да еще с открытым кодом (выкуси OpenAI)
Мои одногруппники по PhD из научной лабы CompVis выкатили обновленную версию Latent Diffusion Model (LDM), которую назвали Stable Diffusion.
Это модель, которую можно использовать для создания и изменения изображений на основе текстовых запросов. В этой версии они по аналогии с Imagen, вместо BERT-like языкового энкодера используют фиксированный предварительно обученный текстовый энкодер CLIP ViT-L/14. Сама диффузионная модель обучена на огромном датасете LAION-2B на 256 вдеокартах A100 примерно в течение месяца.
Результаты же этой модели на уровне с DALLE-2, если не лучше! А требует она в разы меньше ресурсов для инференса. Когда веса появятся в общем доступе (пока только по запросу), то можно будет её довольно быстро гонять даже в бесплатном коллабе.
❱❱ https://github.com/CompVis/stable-diffusion