
Forwarded from Мишин Лернинг
😉 Stable Diffusion Beta Access
Помните писал про то, что скоро будет моделька (фото с огромным зайкой на улице)
Модель представляет из себя смесь Latent Diffusion Model и DALL•E 2 на CLIP векторах и в 'стабильном 'CLIP-Guided режиме. Отсюда и имя: Stable Diffusion
Подробнее в следующем посте
> заявка на бету
Помните писал про то, что скоро будет моделька (фото с огромным зайкой на улице)
Модель представляет из себя смесь Latent Diffusion Model и DALL•E 2 на CLIP векторах и в 'стабильном 'CLIP-Guided режиме. Отсюда и имя: Stable Diffusion
Подробнее в следующем посте
> заявка на бету
Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса
Меня регулярно спрашивают, как я отношусь к проекту No Language Left Behind (машинный перевод для кучи языков; последний релиз покрыл 202).
Сразу оговорюсь, что скоро я буду относиться к нему непосредственно, поэтому моя позиция может быть не совсем объективной. Но я таки выскажусь.
Исследователи из Меты всерьёз заморочились с "продуктовым" подходом, проведя перед началом исследования кастдев носителей малоресурсных языков, потенциальных пользователей их машинного перевода. А для создания тестового датасета (FLORES) они наняли профессиональных переводчиков, чтобы метрики качества были более надёжными и осмысленными. Плюс, уже с готовой моделью, ещё раз сделали для всех языков человеческую оценку качества. По-моему, такая ориентация на полезный результат очень круто смотрится по сравнению с "делаем исследование, чтобы опубликоваться" или "инжинирим, чтобы обновить SOTA на 1%".
При этом, в отличие от Google, недавно замахнувшегося на 1000 языков, или от эпически неоткрытых OpenAI, Meta честно публикует свои наработки в открытый доступ. И код, и кучу параллельных корпусов, и модель для перевода, и модели для эмбеддингов предложений и идентификации языков. По-моему, ресёч таким и должен быть.
Модели для перевода уже доступны на HF, включая дистиллированную относительно небольшую (2.5 GB) версию. Я поигрался с ней чуть-чуть, оказалось, что для примерно 90% языков перевод с русского на другой язык и назад вполне сохраняет смысл и читабельно выглядит. То есть да, модель не просто что-то там генерирует, а в целом вполне себе всерьёз переводит. А ещё я потестировал модель на своей любимой задаче перефразирования, и с ней она тоже вроде вполне справляется, причём даже в один проход, без перевода на промежуточные языки.
Одна из проблем, которую разработчики постарались забороть – это разновидность катастрафических ошибок перевода, когда модель ни с того ни с сего генерирует токсичные тексты. Решить её попытались удалением из обучающих корпусов таких пар предложений, где во втором предложении больше токсичных фраз, чем в первом. Списки фраз для всех 200 языков составляли вручную. Я проглядел список для русского: там 1.5К слов; часть в разных склонениях, часть нет, и вперемешку разные виды "токсичности": однозначно грубая лексика, грубоватые выражения типа "офигенный", потенциальные оскорбления типа "глупый", связанные с сексом слова типа "голый" или "анус", "экстремальные" слова типа "нацист". И очень много слов с переносным значением типа "днище" или "петушок", или неоднозначных (без контекста) типа "попа", "сучки", или "фиговый". В общем, полнота списка довольно высокая, но интуитивно показалось, что и ложных срабатываний должно быть много. Проверил на датасете Одноклассников: токсичные слова нашлись в 53% токсичных комментариев, и в 1.7% нетоксичных комментариев (или в 66% и 2.9%, если сравнивать все леммы; что сопоставимо со Сколтеховским списком токсичных слов). Это вполне бьётся с результатами Меты, которые нашли 0.7% токсичных фраз в Библии. Но насколько вся эта фильтрация действительно решает проблемы токсичных переводов, ни мне, ни авторам NLLB до конца пока не понятно.
Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса
Теперь про политику. Мета, помимо прочего, дистиллировала на данных Википедии свою модель в ~30 моделек для отдельных языковых направлений (типа русский-башкирский, английский-исландский, франзцузский-окситанский) и отдали редакторам Википедии, чтобы упростить её наполнение на малоресурсных языках. @snakers4 подозревает, что благодаря этому теперь Википедия перестала быть свободной и стала оружием гибридной войны: теперь её будут наполнять фейками, переведёнными сразу на все языки. Мне эта логическая цепочка кажется надуманной, но если в неё кто-то верит, это может быть даже хорошо: это может мотивировать кого-нибудь ещё создавать свои переводчики, независимые от Меты. А в делах научных конкуренция – это здорово и относительно безопасно, так что если кому-то хочется заниматься гонкой вооружений, пусть занимаются этим на лингвистическом фронте. А то действительно чуть стыдно, что русско-башкирский переводчик разрабатывает французское подразделение американской компании 🤷♂️
А вообще, языков народов РФ в NLLB пока покрыто не очень много: русский, башкирский, татарский, да вроде и всё. Это даже меньше, чем в Helsinki-NLP/opus-mt-mul-en, где ещё есть чеченский (но она переводит только с или на английский), и сильно меньше, чем поддержано в Яндексе, хотя и он покрывает сильно меньше половины государственных языков субъектов РФ. Так что нам, обитателям северной Евразии, ещё есть над чем работать. Ну и вообще, в мире насчитывается около 7000 языков, так что работы ещё много. И Мета, судя по всему, на 200 языках останавливаться не собирается.
А вообще, языков народов РФ в NLLB пока покрыто не очень много: русский, башкирский, татарский, да вроде и всё. Это даже меньше, чем в Helsinki-NLP/opus-mt-mul-en, где ещё есть чеченский (но она переводит только с или на английский), и сильно меньше, чем поддержано в Яндексе, хотя и он покрывает сильно меньше половины государственных языков субъектов РФ. Так что нам, обитателям северной Евразии, ещё есть над чем работать. Ну и вообще, в мире насчитывается около 7000 языков, так что работы ещё много. И Мета, судя по всему, на 200 языках останавливаться не собирается.
Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса
Ещё про энкодеры предложений.
FAIR в 2017 году (ещё до USE и BERT) опубликовал LASER, мультиязычный энкодер предложений. Дальше его активно использовали для майнинга параллельных предложений из Википедии и Common Crawl. В 2020 году появился LaBSE, который давал эмбеддинги получше, специально обученные именно на задаче подбора пар переводов. А в ходе проекта NLLB в LASER добавили энкодеры для сотни новых языков, дистиллировав их из имеющегося энкодера. Я их пока не успел попробовать, но судя по получившимся в итоге майнинга параллельных корпусам, качество там нормальное. Надеюсь, их скоро добавят в какую-нибудь удобную обёртку типа laserembeddings, или даже вообще на HF выложат.
Какие вообще выводы можно сделать из всей этой истории про энкодеры предложений? Я недавно их сравнивал на десятке задачи из русского языка, но ещё несколько обобщающих выводов хочу озвучить.
1) Мультиязычные энкодеры рулят: LASER, mUSE, LaBSE, и новые мультиязычные sentence-transformers на многих русских задачах обгоняют или дышат в спину моделям от Сбера и DeepPavlov, обученным специально для русского языка.
2) Обучать энкодер предложений можно по-разному:
- можно (как LASER) учить пару энкодер+декодер, заставляя декодер восстанавливать предложение из вектора;
- можно (как sentence-BERT) дообучать би-энкодер на задачах попарного сравнения предложений, типа NLI;
- можно (как LaBSE) сразу учить модель на задаче идентификации пар предложений с одинаковым смыслом;
- можно (как USE) обучаться сразу на массе разнообразных задач, чтобы создать максимально универсальную модель.
Есть ли среди этих подходов какой-то наилучший, неочевидно. Кажется, все четыре – вполне рабочие.
3) Если есть хороший энкодер предложений для одного языка, и есть параллельные датасеты, не очень сложно дистиллировать модель в мультиязычный энкодер (типа этого, см. статью) или в кучу энкодеров для отдельных новых языков (как, собственно, LASER-3, или как недавно сделали наши энтузиасты для башкирского и чувашского).
А поскольку энкодеры предложений – это основа для кучи полезных приложений (самое очевидное – классификация текстов, поиск, но вообще можно даже доучить к энкодеру декодер и использовать эту пару моделей для seq2seq задач), то доступность этих энкодеров для кучи малоресурсных языков означает, что разнообразное NLP с этими языками теперь стало более доступным.
Forwarded from Kali Novskaya (Tatiana Shavrina)
Ситуация с LаMBA дошла до того, что журнал Scientific American выпустил научно-популярную статью, в которой рассказывает общественности о тесте Тьюринга и берет интервью у нейробиолога, чтобы он объяснил, что у нейросетей не может быть (пока) сознания.
В интересное время живём!
В интересное время живём!
Scientific American
Google Engineer Claims AI Chatbot Is Sentient: Why That Matters
Is it possible for an artificial intelligence to be sentient?
Forwarded from Big Data Science
👍🏻TOP 4 dbt tips for data analyst and data engineer
dbt (data build tool) is an open source code framework for executing, testing and documenting SQL queries, which allows you to process data analysis machine, including structuring and description of arrivals, their search, nested calls, rule triggering, documentation and testing. For example, you can use the dbt CLI or dbt Cloud to work with data collection to consume, transform, and load data into storage by computing a dynamic database on a schedule. To increase the efficiency of using dbt for the selection of schemas, sources and models, it is possible to use data:
• The Schema.yml file can only be found in the dbt models folder. The tool allows you to create a unit test that counts the duration of a column for nulls.
• dbt data tests have a strict rule that they must return null rows in order to pass the test. Instead of looking for a value such as the number of a particular set of rows, the data test should be written to expect to find null rows if the results do not match the correct set of sums. Therefore, when developing test data, you need to think about how to return 0 rows in the expected key, but at the same time you need to check the number. You can use the != or <= operators to validate data.
• To increase the speed of testing increase the number of threads in the project profile, in the profiles.yml file. For example, if there are 30 tests, then there are 40 threads, indicate in the profiles.yml file. Probably 30 data and schema tests in 4 seconds.
• The history test needs a meaningful name. Although dbt automatically learns the test names, it is recommended that you label them yourself. dbt doesn't have much control over running small test suites, it needs to be able to see all running projects. In the same way that developers are encouraged to use functions and variables with semantic name definitions, testing should be given tests for meaningful names. Otherwise, it will be difficult to determine which test passes or fails during test execution. When a test error is found in dbt, all schema and data tests are run together. It's not easy to use a single directory in the data tests folder, but you can name them "dbt test - schema" or "dbt test - data" to quickly determine which tests to use.
https://corissa-haury.medium.com/4-quick-facts-about-dbt-testing-5c32b487b8cd
Medium
4 Quick Facts About dbt Testing
You may be using dbt CLI or dbt Cloud for your data pipeline work to Extract, Transform, and Load data into a warehouse by creating…
Forwarded from Open Source
This media is not supported in your browser
VIEW IN TELEGRAM
RePaint
Нейросетевая модель «RePaint: Inpainting с использованием вероятностных моделей диффузии с шумоподавлением»
Простыми словави, она может восстановить недостающую часть изображения или даже например снять с вас маску на фотографии.😷
https://github.com/andreas128/RePaint
Нейросетевая модель «RePaint: Inpainting с использованием вероятностных моделей диффузии с шумоподавлением»
Простыми словави, она может восстановить недостающую часть изображения или даже например снять с вас маску на фотографии.😷
https://github.com/andreas128/RePaint
Forwarded from эйай ньюз
This media is not supported in your browser
VIEW IN TELEGRAM
Тут челик в твиттере сделал просто божественный ролик с помощью DALLE-2. Делая интерполяцию и последовательно подавая 57 текстовых запросов в нейросеть, он производит зум-аут от масштаба протонов, до масштаба галактики.
И качество картинки поразительное. Обалденно!
Нейросети прогрессируют у нас на глазах.
@ai_newz
И качество картинки поразительное. Обалденно!
Нейросети прогрессируют у нас на глазах.
@ai_newz
Forwarded from Big Data Science
🔥PyMLPipe: A lightweight MLOps Python Package
PyMLPipe is a lightweight Python package for MLOps processes. It helps to automate:
• Monitoring of models and data schemas
• Versioning of ML models and data
• Model performance comparison
• API deployment in one click
This source library supports Scikit-Learn, XGBoost, LightGBM and Pytorch. It has a modular structure, represented by a set of Python functions combined into an API and a visual graphical interface. PyMLPipe is great for working with tabular data.
https://neelindresh.github.io/pymlpipe.documentation.io/
neelindresh.github.io
PyMLPipe
None
Forwarded from ЗаТелеком 🌐
Очень страшное видео:
https://youtu.be/xAXvfVTgqr0
Что там происходит: исследовательская группа из университета Беркли разработала новый алгоритм, основанный на обучении с подкреплением (RL - reinforcement learning), для обучения роботов без моделирования или демонстрации.
На видео робот-собака за чуть больше чем час научается ходить. Причем, делает это из положения «на спине». Сначала она учится просто двигать лапками, потом переворачиваться, потом ходит. Через 70 минут она уже не просто ходит, но и умудряется противостоять тычкам.
Теперь становится страшно? А что если это будет огромный человекоподобный робот с руками-бензопилами?
YouTube
Learning to Walk in the Real World in 1 Hour (No Simulator)
We trained a quadruped robot to learn how to walk directly in the physical world without simulators. Learning from scratch in only 1 hour was possible by using the Dreamer algorithm to continuously learn a world model and plan inside of it. https://danij…
👎1
Forwarded from Мишин Лернинг
👾 А у нас NextGen Text2Image: Retrieval-Augmented Diffusion Models от CompVis
Я не мог писать об этом раньше, но теперь все выложили. Хотя написать очень и очень хотелось..
Идея лежала на поверхности: DALL•E 2 💦 RETRO = ❤️
Подробнее разберём на примере:
> Нужно сгенерировать «Мадагаскарская руконожка на скейтборде». Я вот не помню как она выглядит)
❕DALL•E 1/2, Imagen принимали текст, и на основе него генерировали изображения. А что если имеет возможность подглядывать в реальную базу данных?
❗️Для этого нам поможет CLIP и kNN: Ищем в датасете ближайшие изображения и подаём их (или их эмбеддинги) в качестве кондишн для генерации.
Новый LDM, натренированный в таком режиме, что можно использовать:
> Unconditional генерацию
> Class и Retrieval кондишн
То есть: Сожно использовать только текстовое описание, а можно и помочь сети, похожими реальными примерами (найдя похожие картинки, из которых можно взять что-то, как с референсов)
Ну не круто ли?
📰 paper
🔬 Code
@Mishin Learning
Forwarded from GitHub Community
translatepy – универсальная библиотека и CLI, написанная на Python, для перевода, транслитерации, проверки орфографии, озвучивания текста в речь и поиск слов в словарях
Библиотека использует разные лазейки в чужих API для того чтобы бесплатно делать запросы, соответственно не требуются API ключи для работы сервисов перевода
⤷ Ссылка на проект
GitHub | #Python #Translation
Библиотека использует разные лазейки в чужих API для того чтобы бесплатно делать запросы, соответственно не требуются API ключи для работы сервисов перевода
⤷ Ссылка на проект
GitHub | #Python #Translation

Forwarded from Кладовка Pavlu
Делаем DeepFake видео
1. DeepFaceLive — софт для замены лица в режиме реального времени для потоковой передачи на ПК или видеозвонков. От создателей популярной библиотеки DeepFaceLab. Прилагаю неплохую инструкцию.
2. Round DeepFake — записываем Deep Fake "кружочки" в Telegram. Больше побаловаться.
3. DeepFakes Web — платный сайт, где можно сделать видео за 2$.
4. FaceSwap — похож на DeepFaceLab, но предоставляет больше возможностей, лучшую документацию и лучшую онлайн-поддержку. И да, он также доступен на Mac и Linux
Определяем DeepFake на видео:
1. https://deepware.ai/ — бесплатный сервис для проверки видео на подлинность. Также доступно в Google Play.
2. DFSpot-Deepfake-Recognition — нейросетевая модель, которая определяет, является ли входное видео/изображение реальным или Deepfake.
#софт #приватность

Forwarded from Open Source
TableNet
TableNet — модель глубокого обучения для обнаружения таблиц и извлечения табличных данных из отсканированных изображений документов и их фотографий.
https://github.com/jainammm/TableNet
Мануалы: https://asagar60.medium.com/tablenet-deep-learning-model-for-end-to-end-table-detection-and-tabular-data-extraction-from-a49ac4cbffd4

Forwarded from Python Academy
Хитрости Data Science
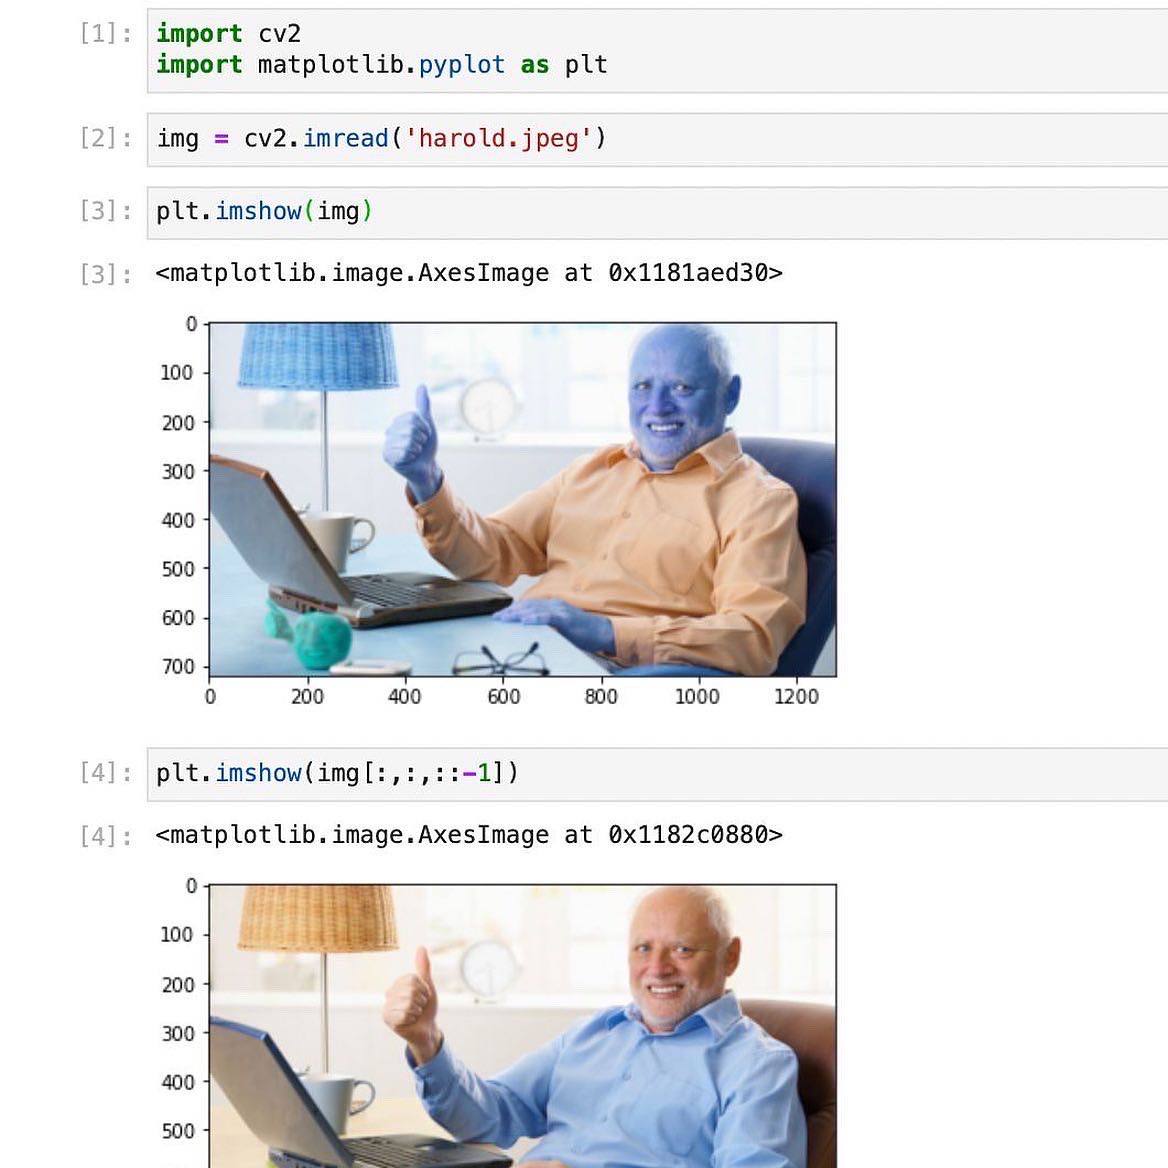
При обучении нейросетей (например, детекции объектов или распознаванию лиц) часто необходимо проверить фотографию, посмотреть, правильно ли расположил разные классы объектов по папкам.
И если для просмотра можно использовать привычный matplotlib, то «прочитать» фото часто удобно через opencv. И тут нюанс: библиотека opencv использует цветовую модель BGR, а matplotlib — всем привычную RGB. Поэтому загружать картинки через opencv, но отображать через matplotlib – это путь к криповым картинкам.
Решение простое: чтобы получить нормальную картинку, используйте обратный порядок в массиве вашей картинки, например, через суши-оператор с шагом -1.
Умение работать с большими данными может пригодится не только в науке и бизнесе, но и повседневной жизни. Приходите на мастер-класс по Python в Data Science для начинающих 30 июля, чтобы освоить базовый синтаксис языка, разобрать теорию, начать решать задачи и задать свои вопросы ментору.
📍 Мероприятие проходит в кампусе в Москве. Еще больше событий школы и информации о профессиях в IT можно найти в телеграме Elbrus Bootcamp.
*обучение на курсе Data Science проходит очно в кампусе в Москве
Forwarded from Библиотека программиста