
Forwarded from Open Source
TargetCLIP
Передача сущности на основе изображений с помощью CLIP
Если упрощенно, это нейросетевая модель которой вы скармливаете на вход два разных лица, а на выходе получаете третье, которое собирает стилистические особенности первого наложенные на второе.
https://github.com/hila-chefer/TargetCLIP
Передача сущности на основе изображений с помощью CLIP
Если упрощенно, это нейросетевая модель которой вы скармливаете на вход два разных лица, а на выходе получаете третье, которое собирает стилистические особенности первого наложенные на второе.
https://github.com/hila-chefer/TargetCLIP

Forwarded from Kali Novskaya (Tatiana Shavrina)
Сделала для вас подборку литературы:
С чего начать в NLP
Пункт номер 0. Учебник со всеми классическими методами от Daniel Jurafsky ссылка
Бессмертная классика, и постоянно выходят обновления.
Пункт номер 1. Стенфордский видеокурс "CS224n: Natural Language Processing with Deep Learning" - есть материалы за прошлые годы, смотрите самый последний (зима 2021) ссылка
Пункт номер 2 и далее. Практика-практика. Делайте своих ботов, классификаторы, микросервисные архитектуры с модельками. Много туториалов на Medium, плюс новые модели на https://paperswithcode.com/sota
◽️Много полезного собрано в учебных материалах DeepPavlov - курс уже прошел, но материалы доступны на Github - тут есть и план обучения, и идеи проектов. Во многом пересекается по материалам со стенфордским курсом.
Дополнительно:
◽️Учебник по NLP от Jacob Eisenstein - 2018 года, но большинство глав up-to-date ссылка
◽️Учебник "A Primer on Neural Network Models for Natural Language Processing" (2015 года, тоже староват, но все основные подходы вам все еще понадобятся) ссылка
На русском:
◽️Бесплатный курс Павла Бралавского "Введение в обработку естественного языка" на stepic: ссылка
Мне он показался сложноватым для совсем новичков, но зато у вас сразу будет несколько Jupyter-проектов на выходе.
◽️Виктор Захаров, учебник "КОРПУСНАЯ ЛИНГВИСТИКА" ссылка
Отличный учебник, написанный для лингвистов. Читать легко и приятно, поймете все про выборки для обучения.
Почти для всех курсов и учебников пререквизиты одинаковые: Python, матстат, основы ML
huggingface.co
Trending Papers - Hugging Face
Your daily dose of AI research from AK
Forwarded from эйай ньюз
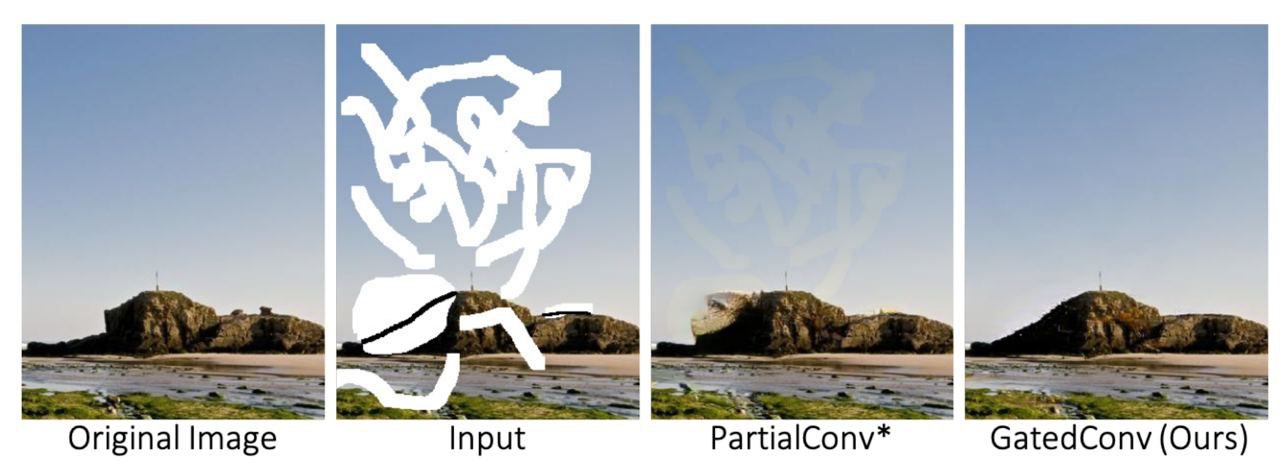
Image Inpainting: Partial Convolution vs Gated convolution
Продолжая рубрику #fundamentals,
поговорим о конволюциях, используемых в нейронных сетях для инпейнтинга. В модели для инпейнтинга изображений на вход обычно подается поврежденное изображение (с некоторыми замаскированными частями). Однако, мы не хотим, чтобы свёртки полагались на пустые области при вычислении фичей. У этой проблемы есть простое решение (Partial convolution) и более элегантное (Gated convolution).
🔻Partial Convolutions делают свертки зависимыми только от валидных пикселей. Они похожи на обычные свертки, где к каждой выходной feature-map применяется умножение на жесткую маску. Первая маска вычисляется непосредственно из покоцанного изображения или предоставляется пользователем в качестве входных данных. Маски для каждой следующей частичной свертки вычисляются путем нахождения ненулевых элементов в промежуточных feature-мапах.
- Для частичной свертки недопустимые пиксели будут постепенно исчезать в глубоких слоях, постепенно преобразовывая все значения маски в единицы.
- частичная свертка несовместима с дополнительным вводом пользователя. Однако мы хотели бы иметь возможность использовать дополнительные пользовательские инпуты для условной генерации (например, скетч внутри маски).
- Все каналы в каждом слое используют одну и ту же маску, что ограничивает гибкость. По сути, частичную свертку можно рассматривать как необучаемое одноканальное зануление фичей по маске.
🔻Gated convolutions. Вместо жесткой маски, обновляемой с помощью жестких правил, закрытые свертки автоматически учат soft маску из данных. Дополнительная конволюция берет входную feature-map и предсказывает соответствующую soft маску, которая применяется к выходу оригинальной свертки.
- Gated convolution может принимать любой дополнительный инпут пользователя (например, маску, эскиз) в качестве входных данных. Все они могут быть склеены с поврежденным изображением и скормлены в сеть.
- Gated convolution динамически учит механизм выбора признаков для каждого канала и каждого пространственного расположения.
- Интересно, что визуализация промежуточных значений предсказанных масок показывает, что gated convolution учится выбирать фичи не только по фону, маске, эскизу, но и с учетом семантической сегментации в некоторых каналах.
- Даже в глубоких слоях gated convolution учится выделять именно маскированные области и информацию о входном скетче в отдельных каналах, что позволяет более качественно генерировать восстановленную картинку.
@ai_newz
Forwarded from Big Data Science
🗣7 speech recognition tools
To develop your own ML speech recognition system, you can use the following frameworks and libraries:
• wav2letter - an open-course open source toolkit from Facebook AI Research merged with a larger library called Flashlight https://github.com/flashlight/wav2letter
• DeepSpeech powered by Baidu DeepSpeech, which will help you decode an audio file using pre-trained models or set up/train a custom dataset https://deepspeech.readthedocs.io/en/r0.9/?badge=latest
• TensorFlowASR - Open source package from Tensorflow implements some reference models trained using RNN with CTC https://github.com/TensorSpeech/TensorFlowASR
• OpenSeq2Seq - research project by NVIDIA on the problems of converting sequences to sequences https://github.com/NVIDIA/OpenSeq2Seq/blob/master/Streaming-ASR.ipynb
• SpeechRecognition - the project provides access to several automatic speech recognition models, including speech API wrappers from Google, Microsoft Azure and IBM https://github.com/Uberi/speech_recognition
We also note 2 ready-made services that provide an API for accessing the capabilities of services, from speech recognition to generating "natural" voice data:
• SmartSpeech by SberDevices https://sberdevices.ru/smartspeech/
• Yandex SpeechKit by Yandex https://cloud.yandex.ru/services/speechkit
GitHub
GitHub - flashlight/wav2letter: Facebook AI Research's Automatic Speech Recognition Toolkit
Facebook AI Research's Automatic Speech Recognition Toolkit - flashlight/wav2letter
Forwarded from Denis Sexy IT 🤖
The-DALL·E-2-prompt-book-v1.01.pdf
21.5 MB
Умные люди стараются не делать публично предсказаний, поэтому вот мое:
— Dalle 2 / Imagen и многие другие нейронки «текст в картинку» станут повседневным инструментов для всех, кто работает с визуальным контентом.
— Те кто не будет противится прогрессу (а такие всегда будут), возьмут этот инструмент на вооружение и он будет им экономить время и деньги.
— Пройдет лет 5 и в требованиях к вакансиям всяких там дизайнеров, будут добавлять «Знание промпт инженеринга» (промпт — это текстовый запрос, что подается нейронке на вход, у Dalle 2 до 400 символов).
— Ну и люди знающие как это работает, будут добавлять себе «промпт инженеринг» как скилл в резюме.
Я явно не один так думаю, потому что вот вам PDF новой бесплатной книги, где все 80 страниц про — «Prompt engineering» и то, как получить разные клевые результаты от этих нейронок.
А вот ссылка на страницу запроса доступа к Dalle 2, вдруг вы еще не подались туда.
Буквально на наших глаза зарождается новый навык владения профессиональным инструментом, не часто такое встретишь.
👍1
Forwarded from Big Data Science
🙌🏼7 Platforms of Federated ML
Federated learning is also referred to as collaborative because ML models are trained on multiple decentralized edge devices or servers containing local data samples without exchanging them. This approach differs from traditional centralized ML methods, where all local datasets are uploaded to a single server, and from more classical decentralized approaches with the same distribution of local data. Today, federated learning is actively used in the defense industry, telecommunications, pharmaceuticals and IoT platforms.
Federated Machine Learning ideas were first introduced by Google in 2017 to improve mobile keyboard text prediction using machine learning models trained on data from multiple devices. In federated ML, models are trained on multiple local datasets on local nodes without explicit data exchange, but with periodic exchange of parameters, such as deep neural network weights and biases, between local nodes to create a common global model. Unlike distributed learning, which was originally aimed at parallelizing computations, federated learning is aimed at learning heterogeneous data sets. In federated ML, datasets are usually highly heterogeneous in size. And clients, i.e. end devices where local models are trained can be unreliable and more prone to failure than in distributed learning systems where the nodes are data centers with powerful computing capabilities. Therefore, in order to provide distributed computing and synchronization of its results, federated ML requires frequent data exchange between nodes.
Due to its architectural features, federated ML has a number of disadvantages:
• heterogeneity between different local datasets - each node has an error in relation to the general population, and sample sizes can vary significantly;
• temporal heterogeneity - the distribution of each local dataset changes over time;
• it is necessary to ensure the compatibility of the data set on all nodes;
• hiding training datasets is fraught with the risk of introducing vulnerabilities into the global model;
• lack of access to global training data makes it difficult to identify unwanted biases in training inputs;
• there is a risk of losing updates to local ML models due to failures at individual nodes, which may affect the global model.
Today, federated ML is supported by the following platforms:
• FATE (Federated AI Technology Enabler) https://fate.fedai.org/
• Substra https://www.substra.ai/
• Python libraries PySyft and PyGrid https://github.com/OpenMined/PySyft, https://github.com/OpenMined/PyGrid, https://github.com/OpenMined/pygrid-admin
• Open FL https://github.com/intel/openfl
• TensorFlow Federated (TFF) https://www.tensorflow.org/federated
• IBM Federated Learning https://ibmfl.mybluemix.net/
• NVIDIA CLARA https://developer.nvidia.com/clara
Fate
HOME
An Industrial Grade
Federated Learning Framework
support federated learning architectures and secure computation of any machine learning algorithms
Federated Learning Framework
support federated learning architectures and secure computation of any machine learning algorithms
Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса
На прошлой неделе меня дважды спрашивали, как восстановить текст предложения из его LaBSE эмбеддинга. Я дважды отвечал, что никак.
Но на самом деле, конечно, можно обучить декодер генерировать текст по его эмбеддингу. Я попробовал, и примерно получилось.
Зачем это делать? Например, чтобы:
- переводить со 100 разных языков на русский;
- суммаризовать много похожих предложений одним;
- реалистично заменять фразы в составе предложений;
- менять смысл предложений.
Модель для восстановления предложений из эмбеддингов опубликована как cointegrated/rut5-base-labse-decoder, а подробности – на Хабре.
Forwarded from Habr For Dev
Forwarded from Big Data Science
🙌🏼Computational complexity of ML algorithms
When the amount of data is low, almost any ML algorithm gives acceptable accuracy and is suitable for solving the tasks. But when the volume and size of the data become large, it is necessary to choose an algorithm for training the ML model that does not require too many computing resources. It is better to choose a simple or less expensive algorithm in terms of computation than an algorithm that requires large computational resources, when the accuracy of prediction and evaluation of results is similar or even slightly worse.
The choice of algorithm depends on the following consequences:
• the order of time (complexity of time) required to calculate the algorithm - functions associated with the data of the algorithm itself, the volume and number of features
• set of computational space (spatial complexity) - the order of the space required during the calculation of the algorithm - a function associated with the algorithm, such as the number of features, coefficients, hidden layers of neural networks. Space complexity includes both the size of the input data and the ancillary space (auxiliary space) used by the algorithm during execution;
For example, Mergesort has an ancillary space 𝑂(𝑛) and volume complexity 𝑂(𝑛), while Quicksort has an ancillary space 𝑂(1) and volume complexity 𝑂(𝑛). As a result, both merge sort and quick sort have time stability 𝑂(𝑛log𝑛).
https://medium.com/datadailyread/computational-complexity-of-machine-learning-algorithms-16e7ffcafa7d
Medium
Computational Complexity of Machine Learning Algorithms
Pick the right algorithm for your data
Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса
Оказывается, есть проект https://panlex.org по сбору общего словаря для всех языков мира (сейчас там представлены 6 тысяч языков).
Так что (как советуют Artexte et al, 2020), не говорите, что для вашего малоресурсного языка совсем нет параллельных данных в открытом доступе. Скорее всего, хотя бы несколько сотен лексем с переводом на другие языки у вас найдётся.
Так что (как советуют Artexte et al, 2020), не говорите, что для вашего малоресурсного языка совсем нет параллельных данных в открытом доступе. Скорее всего, хотя бы несколько сотен лексем с переводом на другие языки у вас найдётся.
Forwarded from Pythonist.ru - образование по питону
Топ-5 книг по машинному обучению для питонистов
Уже даже на позицию Python-разработчика уровня Junior часто задают базовые вопросы по машинному обучению. Чтобы помочь вам войти в эту тему и разобраться с основами ML (Machine learning), мы собрали для вас подборку из пяти книг.
#книги #ml
Книги по ML - @maschinelearning
Уже даже на позицию Python-разработчика уровня Junior часто задают базовые вопросы по машинному обучению. Чтобы помочь вам войти в эту тему и разобраться с основами ML (Machine learning), мы собрали для вас подборку из пяти книг.
#книги #ml
Книги по ML - @maschinelearning

Forwarded from эйай ньюз
This media is not supported in your browser
VIEW IN TELEGRAM
NUWA-Infinity: новая авторегресионная модель для генерации картинок большого размера
Микромягкие выкатили новую модельку, улучшение NUWA. По сравнению с DALL·E, Imagen и Parti, микрософтовсккая модель генерит в высоком разрешении длинные картинки произвольного размера, да ещё в image-2-video умеет.
Модель авторегресионная, без диффузии. Результаты на видео. Кода пока нет,но, кажется, планируют выкатить.
📜 Статья
🌐 Сайт проекта (там есть интерактивные визуализации)
@ai_newz
Forwarded from Библиотека программиста
🔥 Вместо кофе — раскаленное железо, а вместо чашки — огромный ковш. Data Science на службе у сталеваров
Рассказ о том, как аналитическая подсистема, состоящая из двух математических моделей, снижает потребление электроэнергии и износ графитовых электродов, экономя сталеварам до полумиллиона рублей в месяц.
https://proglib.io/sh/ovNyI1LZGW
Рассказ о том, как аналитическая подсистема, состоящая из двух математических моделей, снижает потребление электроэнергии и износ графитовых электродов, экономя сталеварам до полумиллиона рублей в месяц.
https://proglib.io/sh/ovNyI1LZGW

Forwarded from Мишин Лернинг
😉 Stable Diffusion Beta Access
Помните писал про то, что скоро будет моделька (фото с огромным зайкой на улице)
Модель представляет из себя смесь Latent Diffusion Model и DALL•E 2 на CLIP векторах и в 'стабильном 'CLIP-Guided режиме. Отсюда и имя: Stable Diffusion
Подробнее в следующем посте
> заявка на бету
Помните писал про то, что скоро будет моделька (фото с огромным зайкой на улице)
Модель представляет из себя смесь Latent Diffusion Model и DALL•E 2 на CLIP векторах и в 'стабильном 'CLIP-Guided режиме. Отсюда и имя: Stable Diffusion
Подробнее в следующем посте
> заявка на бету
Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса
Меня регулярно спрашивают, как я отношусь к проекту No Language Left Behind (машинный перевод для кучи языков; последний релиз покрыл 202).
Сразу оговорюсь, что скоро я буду относиться к нему непосредственно, поэтому моя позиция может быть не совсем объективной. Но я таки выскажусь.
Исследователи из Меты всерьёз заморочились с "продуктовым" подходом, проведя перед началом исследования кастдев носителей малоресурсных языков, потенциальных пользователей их машинного перевода. А для создания тестового датасета (FLORES) они наняли профессиональных переводчиков, чтобы метрики качества были более надёжными и осмысленными. Плюс, уже с готовой моделью, ещё раз сделали для всех языков человеческую оценку качества. По-моему, такая ориентация на полезный результат очень круто смотрится по сравнению с "делаем исследование, чтобы опубликоваться" или "инжинирим, чтобы обновить SOTA на 1%".
При этом, в отличие от Google, недавно замахнувшегося на 1000 языков, или от эпически неоткрытых OpenAI, Meta честно публикует свои наработки в открытый доступ. И код, и кучу параллельных корпусов, и модель для перевода, и модели для эмбеддингов предложений и идентификации языков. По-моему, ресёч таким и должен быть.
Модели для перевода уже доступны на HF, включая дистиллированную относительно небольшую (2.5 GB) версию. Я поигрался с ней чуть-чуть, оказалось, что для примерно 90% языков перевод с русского на другой язык и назад вполне сохраняет смысл и читабельно выглядит. То есть да, модель не просто что-то там генерирует, а в целом вполне себе всерьёз переводит. А ещё я потестировал модель на своей любимой задаче перефразирования, и с ней она тоже вроде вполне справляется, причём даже в один проход, без перевода на промежуточные языки.
Одна из проблем, которую разработчики постарались забороть – это разновидность катастрафических ошибок перевода, когда модель ни с того ни с сего генерирует токсичные тексты. Решить её попытались удалением из обучающих корпусов таких пар предложений, где во втором предложении больше токсичных фраз, чем в первом. Списки фраз для всех 200 языков составляли вручную. Я проглядел список для русского: там 1.5К слов; часть в разных склонениях, часть нет, и вперемешку разные виды "токсичности": однозначно грубая лексика, грубоватые выражения типа "офигенный", потенциальные оскорбления типа "глупый", связанные с сексом слова типа "голый" или "анус", "экстремальные" слова типа "нацист". И очень много слов с переносным значением типа "днище" или "петушок", или неоднозначных (без контекста) типа "попа", "сучки", или "фиговый". В общем, полнота списка довольно высокая, но интуитивно показалось, что и ложных срабатываний должно быть много. Проверил на датасете Одноклассников: токсичные слова нашлись в 53% токсичных комментариев, и в 1.7% нетоксичных комментариев (или в 66% и 2.9%, если сравнивать все леммы; что сопоставимо со Сколтеховским списком токсичных слов). Это вполне бьётся с результатами Меты, которые нашли 0.7% токсичных фраз в Библии. Но насколько вся эта фильтрация действительно решает проблемы токсичных переводов, ни мне, ни авторам NLLB до конца пока не понятно.