
Forwarded from эйай ньюз
Привет, друзья!
Собрал для вас список лекций и туториалов про 3D Human Understanding от топовых ученых из этой сферы.
Рекомендасион для всех, кто хочет основательно погрузиться в тему.
1. Andreas Geiger. Diverse Topics in Computer Vision: Human Body Models [video]
2. Michael Black. SMPL made Simple -- Introduction [video]
3. Dimitris Tzionas. SMPL from Images via Optimization [video]
4. Michael Black. SMPL: Frequently Asked Questions [video]
2. Angjoo Kanazawa. Perceiving Humans in the 3D World [video]
3. Iasonas Kokkinos. Humans, hands, and horses [video]
4. Michael Black. Meta-commerce in the Age of Avatars [video]
5. Ahmed Osman. Problems with SMPL and fixing them with STAR [video]
6. Gerard Pons-Moll. Clothing SMPL [video]
7. Siyu Tang. Putting SMPL into Scenes [video]
8. Joachim Tesch. SMPL-X Application Integrations. Using SMPL-X in Blender, Unity and Unreal [video]
9. Datasets of and for SMPL and related models [video]
10. SMPLpix: Combining SMPL and Neural Rendering [video]
@Artem
👌TOP-5 MLOps frameworks
The MLOps topic is in hype today: ML systems are getting more complex, and their development and support includes not only computational algorithms and other data science, but also the best software developments with the intricacies of deploying in production. At the same time, it is necessary to constantly monitor the drift of the input data and the reaction of ML models to them, with the accuracy of correcting the code with its versioning. Establish such a continuous chain of response to complex MLOps frameworks, the most important of which are possible:
• MLflow is an open source platform for managing the end-to-end machine learning lifecycle. https://www.mlflow.org/
• Kubeflow is an open-source machine learning platform designed to enable using machine learning pipelines to orchestrate complicated workflows running on Kubernetes (e.g. doing data processing then using TensorFlow or PyTorch to train a model, and deploying to TensorFlow Serving or Seldon). Kubeflow is built based on Google’s internal method to deploy TensorFlow models called TensorFlow Extended. https://www.kubeflow.org/
• FastAPI is a modern, fast (high-performance), web framework for building APIs with Python 3.6+ based on standard Python type hints. It fully supports asynchronous programming and can run with Uvicorn and Gunicorn. https://fastapi.tiangolo.com/
• ZenML is an open-source MLOps framework built for ML teams. It provides the abstraction layer to bring Machine Learning Models from research to production as easily as possible. Data scientists don’t need to know the details behind the deployment but gain full control and ownership over the whole pipeline process. ZenML standardizes writing ML pipelines across different MLOps stacks, agnostic of cloud providers, third-party vendors, and underlying infrastructure. https://zenml.io/
• Seldon Core is an open-source framework, makes it easier and faster to deploy our machine learning models and experiments at scale on Kubernetes. Seldon Core serves models built in any open-source or commercial model building framework. You can make use of powerful Kubernetes features like custom resource definitions to manage model graphs. And then connect your continuous integration and deployment (CI/CD) tools to scale and update your deployment. Seldon handles scaling to thousands of production machine learning models and provides advanced machine learning capabilities out of the box including Advanced Metrics, Request Logging, Explainers, Outlier Detectors, A/B Tests, Canaries, and more. https://www.seldon.io/solutions/open-source-projects/core
Forwarded from [PYTHON:TODAY]
Шпаргалка_по_всем_видам_нейронных_сетей.pdf
3 MB
Forwarded from Журнал «Код»
Подборка о том, как сгенерировать много текста, который будет похож на настоящий:
• Что такое цепи Маркова и как они работают: https://v.thecode.media/ma60b
• Простейший генератор текста на цепях Маркова: https://v.thecode.media/8ggu5
• Пишем Чехова на цепях Маркова: готовая библиотека: https://v.thecode.media/2faq6
• Генератор статей для Кода: https://v.thecode.media/am81v
• Абсолютня: генератор новых слов на Python: https://v.thecode.media/23q96
Forwarded from Мишин Лернинг
🤖👄 Ни один язык не останется без внимания — машинный перевод на 200 языков❗️от MetaAI, который мы заслужили
Ни один язык не останется без внимания — так называется пейпер и новый подход от MetaAI. No Language Left Behind или сокращенно NLLB.
Основные поинты:
▫️ SOTA Машинного перевода на 200 языков!
▫️ Основная MoE модель — 54.5B
▫️ Dense модели — 3.3B и 1.3B
▫️ Distilled Dense модели — 1.3B и 600M
Цель исследования — качественный автоматический машинный перевод для себя (Instagram & Facebook) и для мира — все модели в опенсорс!
Кроме самих моделей MetaAI опенсорснули:
- Код трейна/инференса моделей
- Код дистилляции моделей
- Код файнтюна моделей ❤️
Последнее вообще топ, так как можно малыми усилиями получить кастомный машинный переводчик под свой домен и нужные языки!
p.s.: в пейпере очень много полезных идей: от пайплайна обучения, регуляризации и дистилляции до тех. деталей типа сравнения MoE Expert Output Masking с Gating Dropout, для NLPшников — маст хэв!
📄 paper 💻 code
@mishin_leaning
Forwarded from Codeby
Перевод текста в переводчике DeepL с использованием Selenium в Python
Когда вы собираетесь читать книгу на иностранном языке, вы либо учите этот язык, для того, чтобы можно было читать тексты в оригинале, либо пользуетесь услугами машинного перевода. Если, конечно, книга уже не переведена на ваш язык опытным переводчиком. И, несомненно, лидерами в области машинного перевода долгое время были программы, которые устанавливались на компьютер, имели собственную базу в соответствии, с которой и переводили с одного языка на другой. Но, появился интернет и все большую популярность стали набирать онлайн переводчики, такие как Google Translate или Яндекс Переводчик. Но, речь сейчас не о них, а об онлайн переводчике, который в области машинного перевода гораздо лучше, чем упомянутые выше гиганты. Речь о DeepL Translate. И все бы хорошо, если бы не одно «но». И вот об этом «но» я и расскажу, как я автоматизировал его с помощью Python.
📌 Читать далее
#python #parsing

Forwarded from Open Source
Media is too big
VIEW IN TELEGRAM
Machine Learning Visualization Tools
Python библиотека для визуализации процесса машинного обучения в терминале.
https://github.com/bwasti/mlvt
Python библиотека для визуализации процесса машинного обучения в терминале.
https://github.com/bwasti/mlvt
Forwarded from Библиотека программиста
Коллекция пошаговых руководств для изучения и создания проектов в различных областях Computer Science.
https://proglib.io/w/12fd9d68
https://proglib.io/w/12fd9d68
GitHub
GitHub - codecrafters-io/build-your-own-x: Master programming by recreating your favorite technologies from scratch.
Master programming by recreating your favorite technologies from scratch. - codecrafters-io/build-your-own-x
Forwarded from Open Source
TargetCLIP
Передача сущности на основе изображений с помощью CLIP
Если упрощенно, это нейросетевая модель которой вы скармливаете на вход два разных лица, а на выходе получаете третье, которое собирает стилистические особенности первого наложенные на второе.
https://github.com/hila-chefer/TargetCLIP
Передача сущности на основе изображений с помощью CLIP
Если упрощенно, это нейросетевая модель которой вы скармливаете на вход два разных лица, а на выходе получаете третье, которое собирает стилистические особенности первого наложенные на второе.
https://github.com/hila-chefer/TargetCLIP

Forwarded from Kali Novskaya (Tatiana Shavrina)
Сделала для вас подборку литературы:
С чего начать в NLP
Пункт номер 0. Учебник со всеми классическими методами от Daniel Jurafsky ссылка
Бессмертная классика, и постоянно выходят обновления.
Пункт номер 1. Стенфордский видеокурс "CS224n: Natural Language Processing with Deep Learning" - есть материалы за прошлые годы, смотрите самый последний (зима 2021) ссылка
Пункт номер 2 и далее. Практика-практика. Делайте своих ботов, классификаторы, микросервисные архитектуры с модельками. Много туториалов на Medium, плюс новые модели на https://paperswithcode.com/sota
◽️Много полезного собрано в учебных материалах DeepPavlov - курс уже прошел, но материалы доступны на Github - тут есть и план обучения, и идеи проектов. Во многом пересекается по материалам со стенфордским курсом.
Дополнительно:
◽️Учебник по NLP от Jacob Eisenstein - 2018 года, но большинство глав up-to-date ссылка
◽️Учебник "A Primer on Neural Network Models for Natural Language Processing" (2015 года, тоже староват, но все основные подходы вам все еще понадобятся) ссылка
На русском:
◽️Бесплатный курс Павла Бралавского "Введение в обработку естественного языка" на stepic: ссылка
Мне он показался сложноватым для совсем новичков, но зато у вас сразу будет несколько Jupyter-проектов на выходе.
◽️Виктор Захаров, учебник "КОРПУСНАЯ ЛИНГВИСТИКА" ссылка
Отличный учебник, написанный для лингвистов. Читать легко и приятно, поймете все про выборки для обучения.
Почти для всех курсов и учебников пререквизиты одинаковые: Python, матстат, основы ML
huggingface.co
Trending Papers - Hugging Face
Your daily dose of AI research from AK
Forwarded from эйай ньюз
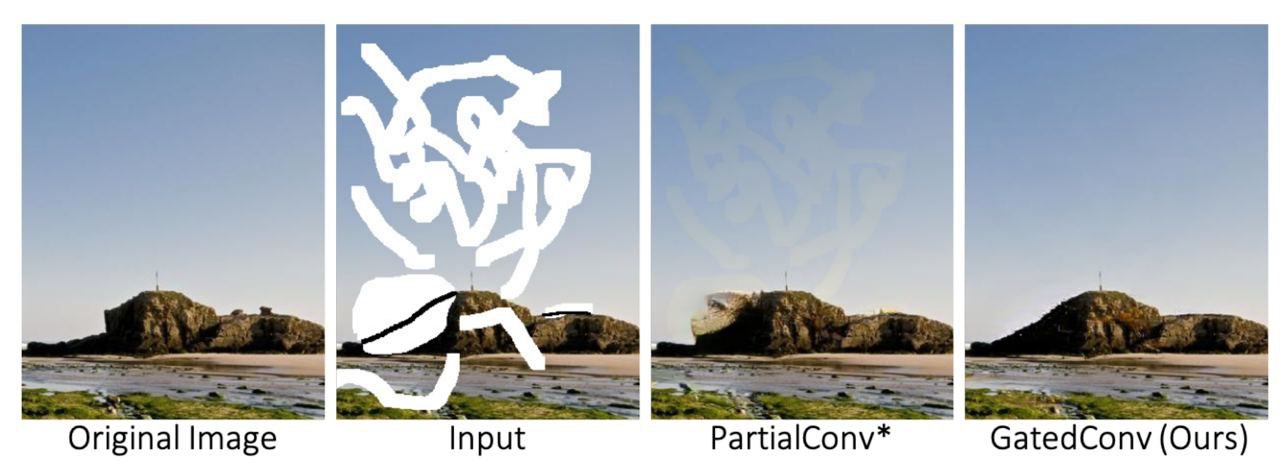
Image Inpainting: Partial Convolution vs Gated convolution
Продолжая рубрику #fundamentals,
поговорим о конволюциях, используемых в нейронных сетях для инпейнтинга. В модели для инпейнтинга изображений на вход обычно подается поврежденное изображение (с некоторыми замаскированными частями). Однако, мы не хотим, чтобы свёртки полагались на пустые области при вычислении фичей. У этой проблемы есть простое решение (Partial convolution) и более элегантное (Gated convolution).
🔻Partial Convolutions делают свертки зависимыми только от валидных пикселей. Они похожи на обычные свертки, где к каждой выходной feature-map применяется умножение на жесткую маску. Первая маска вычисляется непосредственно из покоцанного изображения или предоставляется пользователем в качестве входных данных. Маски для каждой следующей частичной свертки вычисляются путем нахождения ненулевых элементов в промежуточных feature-мапах.
- Для частичной свертки недопустимые пиксели будут постепенно исчезать в глубоких слоях, постепенно преобразовывая все значения маски в единицы.
- частичная свертка несовместима с дополнительным вводом пользователя. Однако мы хотели бы иметь возможность использовать дополнительные пользовательские инпуты для условной генерации (например, скетч внутри маски).
- Все каналы в каждом слое используют одну и ту же маску, что ограничивает гибкость. По сути, частичную свертку можно рассматривать как необучаемое одноканальное зануление фичей по маске.
🔻Gated convolutions. Вместо жесткой маски, обновляемой с помощью жестких правил, закрытые свертки автоматически учат soft маску из данных. Дополнительная конволюция берет входную feature-map и предсказывает соответствующую soft маску, которая применяется к выходу оригинальной свертки.
- Gated convolution может принимать любой дополнительный инпут пользователя (например, маску, эскиз) в качестве входных данных. Все они могут быть склеены с поврежденным изображением и скормлены в сеть.
- Gated convolution динамически учит механизм выбора признаков для каждого канала и каждого пространственного расположения.
- Интересно, что визуализация промежуточных значений предсказанных масок показывает, что gated convolution учится выбирать фичи не только по фону, маске, эскизу, но и с учетом семантической сегментации в некоторых каналах.
- Даже в глубоких слоях gated convolution учится выделять именно маскированные области и информацию о входном скетче в отдельных каналах, что позволяет более качественно генерировать восстановленную картинку.
@ai_newz
Forwarded from Big Data Science
🗣7 speech recognition tools
To develop your own ML speech recognition system, you can use the following frameworks and libraries:
• wav2letter - an open-course open source toolkit from Facebook AI Research merged with a larger library called Flashlight https://github.com/flashlight/wav2letter
• DeepSpeech powered by Baidu DeepSpeech, which will help you decode an audio file using pre-trained models or set up/train a custom dataset https://deepspeech.readthedocs.io/en/r0.9/?badge=latest
• TensorFlowASR - Open source package from Tensorflow implements some reference models trained using RNN with CTC https://github.com/TensorSpeech/TensorFlowASR
• OpenSeq2Seq - research project by NVIDIA on the problems of converting sequences to sequences https://github.com/NVIDIA/OpenSeq2Seq/blob/master/Streaming-ASR.ipynb
• SpeechRecognition - the project provides access to several automatic speech recognition models, including speech API wrappers from Google, Microsoft Azure and IBM https://github.com/Uberi/speech_recognition
We also note 2 ready-made services that provide an API for accessing the capabilities of services, from speech recognition to generating "natural" voice data:
• SmartSpeech by SberDevices https://sberdevices.ru/smartspeech/
• Yandex SpeechKit by Yandex https://cloud.yandex.ru/services/speechkit
GitHub
GitHub - flashlight/wav2letter: Facebook AI Research's Automatic Speech Recognition Toolkit
Facebook AI Research's Automatic Speech Recognition Toolkit - flashlight/wav2letter
Forwarded from Denis Sexy IT 🤖
The-DALL·E-2-prompt-book-v1.01.pdf
21.5 MB
Умные люди стараются не делать публично предсказаний, поэтому вот мое:
— Dalle 2 / Imagen и многие другие нейронки «текст в картинку» станут повседневным инструментов для всех, кто работает с визуальным контентом.
— Те кто не будет противится прогрессу (а такие всегда будут), возьмут этот инструмент на вооружение и он будет им экономить время и деньги.
— Пройдет лет 5 и в требованиях к вакансиям всяких там дизайнеров, будут добавлять «Знание промпт инженеринга» (промпт — это текстовый запрос, что подается нейронке на вход, у Dalle 2 до 400 символов).
— Ну и люди знающие как это работает, будут добавлять себе «промпт инженеринг» как скилл в резюме.
Я явно не один так думаю, потому что вот вам PDF новой бесплатной книги, где все 80 страниц про — «Prompt engineering» и то, как получить разные клевые результаты от этих нейронок.
А вот ссылка на страницу запроса доступа к Dalle 2, вдруг вы еще не подались туда.
Буквально на наших глаза зарождается новый навык владения профессиональным инструментом, не часто такое встретишь.
👍1
Forwarded from Big Data Science
🙌🏼7 Platforms of Federated ML
Federated learning is also referred to as collaborative because ML models are trained on multiple decentralized edge devices or servers containing local data samples without exchanging them. This approach differs from traditional centralized ML methods, where all local datasets are uploaded to a single server, and from more classical decentralized approaches with the same distribution of local data. Today, federated learning is actively used in the defense industry, telecommunications, pharmaceuticals and IoT platforms.
Federated Machine Learning ideas were first introduced by Google in 2017 to improve mobile keyboard text prediction using machine learning models trained on data from multiple devices. In federated ML, models are trained on multiple local datasets on local nodes without explicit data exchange, but with periodic exchange of parameters, such as deep neural network weights and biases, between local nodes to create a common global model. Unlike distributed learning, which was originally aimed at parallelizing computations, federated learning is aimed at learning heterogeneous data sets. In federated ML, datasets are usually highly heterogeneous in size. And clients, i.e. end devices where local models are trained can be unreliable and more prone to failure than in distributed learning systems where the nodes are data centers with powerful computing capabilities. Therefore, in order to provide distributed computing and synchronization of its results, federated ML requires frequent data exchange between nodes.
Due to its architectural features, federated ML has a number of disadvantages:
• heterogeneity between different local datasets - each node has an error in relation to the general population, and sample sizes can vary significantly;
• temporal heterogeneity - the distribution of each local dataset changes over time;
• it is necessary to ensure the compatibility of the data set on all nodes;
• hiding training datasets is fraught with the risk of introducing vulnerabilities into the global model;
• lack of access to global training data makes it difficult to identify unwanted biases in training inputs;
• there is a risk of losing updates to local ML models due to failures at individual nodes, which may affect the global model.
Today, federated ML is supported by the following platforms:
• FATE (Federated AI Technology Enabler) https://fate.fedai.org/
• Substra https://www.substra.ai/
• Python libraries PySyft and PyGrid https://github.com/OpenMined/PySyft, https://github.com/OpenMined/PyGrid, https://github.com/OpenMined/pygrid-admin
• Open FL https://github.com/intel/openfl
• TensorFlow Federated (TFF) https://www.tensorflow.org/federated
• IBM Federated Learning https://ibmfl.mybluemix.net/
• NVIDIA CLARA https://developer.nvidia.com/clara
Fate
HOME
An Industrial Grade
Federated Learning Framework
support federated learning architectures and secure computation of any machine learning algorithms
Federated Learning Framework
support federated learning architectures and secure computation of any machine learning algorithms
Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса
На прошлой неделе меня дважды спрашивали, как восстановить текст предложения из его LaBSE эмбеддинга. Я дважды отвечал, что никак.
Но на самом деле, конечно, можно обучить декодер генерировать текст по его эмбеддингу. Я попробовал, и примерно получилось.
Зачем это делать? Например, чтобы:
- переводить со 100 разных языков на русский;
- суммаризовать много похожих предложений одним;
- реалистично заменять фразы в составе предложений;
- менять смысл предложений.
Модель для восстановления предложений из эмбеддингов опубликована как cointegrated/rut5-base-labse-decoder, а подробности – на Хабре.
Forwarded from Habr For Dev