
Forwarded from S.E.Book
📓 Как вытащить из данных максимум. Навыки аналитики для неспециалистов.
💬 Дата-грамотность, то есть способность ориентироваться в мире данных, — ключевой навык сегодняшнего дня. Ежедневно в соцсетях публикуются миллиарды сообщений, электронные почтовые ящики по всей планете гудят от писем, а каждый подключенный к интернету автомобиль производит терабайты данных, не говоря уже об онлайн-магазинах, платежных системах и государственных цифровых сервисах. Однако работать с данными, анализировать их и использовать их для бизнеса по-прежнему умеет меньшинство, а специалистов катастрофически не хватает.
💬 Это практическое руководство позволит даже неспециалисту освоить четыре базовых уровня аналитики и узнать, как принимать эффективные решения на основе данных, чтобы извлекать максимум из информации и быть успешным в быстро меняющемся цифровом мире.
📌 Download.
#RU #DataMining
Forwarded from эйай ньюз
This media is not supported in your browser
VIEW IN TELEGRAM
Meta AI о нашем SOTA подходе для видео-сегментации человека на мобильных устройствах
В посте описана архитектура и всяческие трюки, которые помогают достичь SOTA результатов, при том, что модель бегает real-time на телефоне (либо, на другом мобильном устройстве).
Некоторые из фишек:
- FBNet - based архитектура, заточенная под сегментацию на мобилках с помощью Neural Architecture Seach. Выглядит как асиметричный U-Net с тяжелым энкодером и легковесным декодером.
- BoundaryIOU loss для смещения фокуса именно на точность сегментации на границе объекта
- Для увеличения консистентности предсказания во времени на вход берется маска, предсказанная на предыдущем фрейме
- Semi-supervised learning: В качестве учителя берется жирная сеть PointRend, а в качетсве студента легкая сеть, описанная выше.
К этому проекту приложил руку и ваш покорный слуга 🤓.
> Ссылка на статью
Forwarded from TechSparks
Красивый результат с интересными практическими перспективами: специалисты по машинному обучению из DeepMind смогли обучить свои алгоритмы управлять магнитами токамака так, чтобы получать и удерживать «бублик» из плазмы нужной формы.
Изучение плазмы в токамаках и разработка надёжных методов ее стабилизации необходимо для получения, наконец, после десятилетий исследований, мощного источника чистой энергии. Но плазма неустойчива и ее свойства меняются чрезвычайно быстро и слабопредсказуемо, поэтому ни оператор, ни жестко запрограммированные алгоритмы не в состоянии обеспечить требуемое управление магнитами токамака. А вот машинное обучение (причём обученное на симуляторе, а не только на реальной установке) с задачей справилось.
This work is another powerful example of how machine learning and expert communities can come together to tackle grand challenges and accelerate scientific discovery. Лучше не скажешь :)
https://deepmind.com/blog/article/Accelerating-fusion-science-through-learned-plasma-control
Deepmind
Accelerating fusion science through learned plasma control
Successfully controlling the nuclear fusion plasma in a tokamak with deep reinforcement learning
Forwarded from GitHub Community
CompreFace – Это бесплатная система распознавания лиц с открытым исходным кодом от Exadel
CompreFace можно легко интегрировать в любую систему без предварительных навыков машинного обучения. CompreFace предоставляет REST API для распознавания лиц, проверки лиц, обнаружения лиц, определения ориентиров, возраста и пола и легко развертывается с помощью докера.
⤷ Веб-сайт
GitHub | #Java #Recognition #Useful #Interesting

Forwarded from AI для Всех
Forwarded from Технологии | Нейросети | Боты
Хабр
Учим гипермодальный трансформер предсказывать калорийность борща
Попробовать можно тут Тыкать тут Привет Хабр, сегодня мы поговорим о такой важной теме как мультимодальные трансформеры. Что же это такое в контексте машинного обучения - это способность одной модели...
Forwarded from [404] — программирование
🐍 Распознавание текста с изображения — [8:50]
Python часто используют при разработке искусственного интеллекта, который, в свою очередь, умеет в компьютерное зрение. Это самое зрение позволяет программе искать и идентифицировать объекты на изображении (люди, животные или даже текст), без чего, естественно, никак не обойтись.
В этом видео автор на практике показал, как с использованием EasyOCR считывать текст русского и английского языка с изображения, а после — записать его в файл.
Перейти к просмотру
#видео #python

Forwarded from Big Data Science
🔥Hide a spicy photo from strangers? Easy with nudity detection API
Python program by DeepAI (https://deepai.org/machine-learning-model/nsfw-detector)
evaluates the image and estimates the likelihood that it covers areas of the human body that are usually found under clothing. The nudity check is a dynamic label, a certainty algorithm, or a false percentage. The user can set a different threshold in their app for what it considers to be nudity, and the image detection algorithm will return the percentage chance that the image contains natural content. This ML system is applicable not only to photos, but also to videos: neural networks analyze the video stream and give probabilistic feedback on the “adultness” of consumption.
See an example of using the API here: https://medium.com/mlearning-ai/i-tried-a-python-nude-detector-with-my-photo-446dba1bbfc8
Forwarded from Интернет-Розыск
Использование микросервисов и искусственного интеллекта для анализа изображений в доказательствах по уголовным делам.
▶️ https://youtu.be/6DsiCzTFQLQ
▶️ https://youtu.be/6DsiCzTFQLQ
YouTube
Using Micro-Services and Artificial Intelligence to Analyze Images in Criminal Evidences
In the context of the Brazilian judicial system, during a criminal investigation, forensic specialists extract, decode, and analyze the evidence collected to allow the prosecutor to make legal demands for a prosecution. These specialists have a very short…
Forwarded from тоже моушн
This media is not supported in your browser
VIEW IN TELEGRAM
с праздником, пацаны)
в комментариях к посту про музыкальный StyleGAN3 спрашивали - можно ли такое провернуть со своими фотографиями? теперь можно! для этого надо сначала заморфить фотки в колабе frame interpolation, а затем полученное видео обработать под звук в новом колабе - audio reactive video
make love not war!
colab audio reactive video
colab sequence frame interpolation
Forwarded from Технологии | Нейросети | Боты
This media is not supported in your browser
VIEW IN TELEGRAM
Интересное от Google Research
"Известно, что StyleGAN создает высококачественные изображения, а также предлагает беспрецедентное семантическое редактирование. Однако эти удивительные возможности были продемонстрированы только на ограниченном наборе наборов данных, которые обычно структурно выровнены и тщательно отобраны. В этой статье мы покажем, как StyleGAN можно адаптировать для работы с необработанными изображениями, собранными из Интернета."
Self-Distilled StyleGAN: Towards Generation from Internet Photos https://self-distilled-stylegan.github.io/
github:
https://github.com/self-distilled-stylegan/self-distilled-internet-photos
Forwarded from Технологии | Нейросети | Боты
This media is not supported in your browser
VIEW IN TELEGRAM
Примеры семантического редактирования:
"Наш подход сохраняет замечательные возможности семантического редактирования StyleGAN, что позволяет нам выполнять различное редактирование для каждого домена."
"Наш подход сохраняет замечательные возможности семантического редактирования StyleGAN, что позволяет нам выполнять различное редактирование для каждого домена."
Forwarded from Big Data Science
😎3 Face Recognition ML Services APIs: Choose What You Need
• IBM Watson Visual Recognition API for identifying scenes, objects, and faces in images uploaded to the service. It can process unstructured data in a large volume and is suitable as a decision support system. But it is expensive to maintain and does not process structured data directly. The facial recognition method does not support general biometric recognition, and the maximum image size is 10 MB with a minimum recommended density of 32x32 ppi. Suitable for image classification using built-in classifiers, allows you to create your own classifiers and train ML models. https://www.ibm.com/watson
• Kairos Face Recognition API allows developers of ML applications to add face recognition capabilities to their applications by writing just a few lines of code. The Kairos Face Recognition API shows high accuracy in real-life scenarios and performs well in low light conditions as well as partial face hiding. Applies an ethical approach to identifying individuals, taking into account diversity. It is an extensible tool: users can apply additional intelligence to work with video and photos in the real world. Suitable for working with large volumes of images and ensures confidentiality through the secure storage of collected data and regular audits. However, it only supports BMP, JPG, and PNG file types, GIF files are not supported. Slightly slower in operation than the AWS API. https://www.kairos.com/docs/getting-started-with-kairos-face-recognition
• Microsoft Computer Vision API in Azure gives developers access to advanced image processing algorithms. Once an image is loaded or its URL is specified, Microsoft Computer Vision algorithms analyze its visual content in various ways based on the user's choice. An added benefit of this fast API is visual guides, tutorials, and examples. A high SLA guarantees at least 99.9% availability. Through tight integration with other Microsoft Azure cloud services, APIs can be packaged into a complete solution. But if the transaction per second limit is exceeded, the response time will be reduced to the agreed limit. The pricing model is demand-driven, so the service can become expensive if the number of requests spikes. The Microsoft Computer Vision API is great for classifying images with objects, creatures, scenery, and activities, including their identification, categorization, and image tagging. Supports face, mood, age and scene recognition, optical character recognition to detect text content in images. Also provides intelligent photo management and moderated content display restriction. https://azure.microsoft.com/en-us/services/cognitive-services/computer-vision/
Ibm
IBM Watson
See how IBM Watson has advanced enterprise AI.
Forwarded from GitHub Community
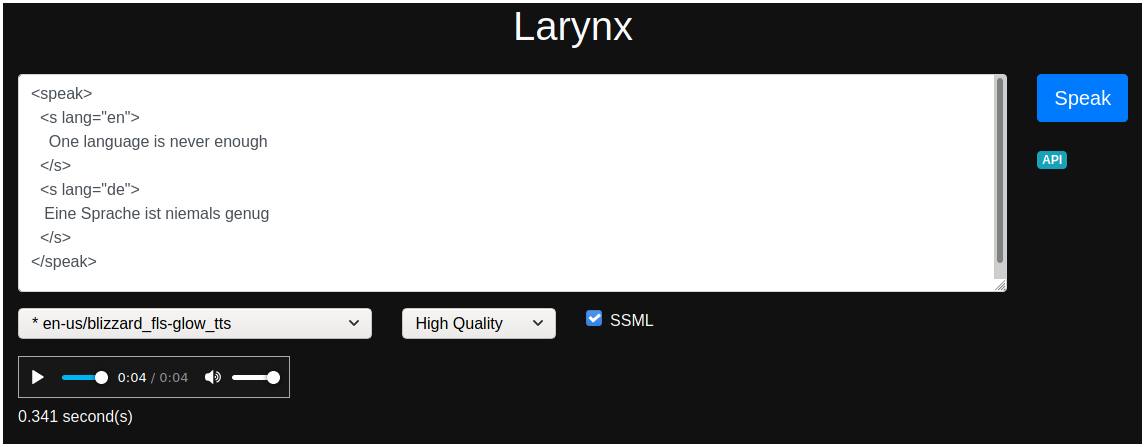
Larynx – Автономная сквозная система преобразования текста в речь с использованием gruut и onnx (архитектура). Доступно 50 голосов на 9 языках.
• Достаточно хороший синтез, чтобы не использовать облачный сервис
• Быстрее, чем работа в реальном времени на Raspberry Pi 4 (с вокодером низкого качества)
• Широкая языковая поддержка (9 языков)
• Голоса обучены исключительно на основе публичных наборов данных
GitHub | #Python #Speech #Interesting
Forwarded from [PYTHON:TODAY]
🔥 Полезные библиотеки Python
DeepFaceLive - Python утилита для создания дип фейков в режиме реального времени.
⚙️ GitHub/Инструкция
💾 Больше интересных проектов
#python #github
DeepFaceLive - Python утилита для создания дип фейков в режиме реального времени.
⚙️ GitHub/Инструкция
💾 Больше интересных проектов
#python #github
Forwarded from Derp Learning
This media is not supported in your browser
VIEW IN TELEGRAM
DiscoDiffusion v5 3d Работает неплохо даже на дефолтных настройках.
Забавны последние кадры, где все варианты CLIP решили, что голубой фон достаточно похож на текстовый запрос, и рисовать мы ничего больше не будем.
Забавны последние кадры, где все варианты CLIP решили, что голубой фон достаточно похож на текстовый запрос, и рисовать мы ничего больше не будем.
Forwarded from эйай ньюз
This media is not supported in your browser
VIEW IN TELEGRAM
Google прокачал StyleGAN
Теперь, наконец, нормально генерятся не только лица. Обучают на неструктурированных картинках из интернета, и результат вы можете видеть на видео.
https://self-distilled-stylegan.github.io/
Теперь, наконец, нормально генерятся не только лица. Обучают на неструктурированных картинках из интернета, и результат вы можете видеть на видео.
https://self-distilled-stylegan.github.io/