
🧠 Що таке “інтелект” LLM моделі?
У попередньому пості я використав фразу:
«Мислення — це здатність до міркування».
І, можливо, у тебе виникло цілком логічне запитання:
👉 Якщо памʼять моделі можна виміряти в токенах — то як вимірюється інтелект?
🔸 Памʼять — це кількість токенів, які модель може “тримати в голові” (сontext window) в одному запиті.
🔸 Мислення — це здатність моделі логічно міркувати, будувати ланцюжки, узагальнювати та робити висновки.
🔬 У світі AI це називають reasoning — і перевіряють цю здатнисть через спеціальні тести: 👇
▫️ GSM8K — шкільна математика (6–8 клас)
▫️ Big-Bench — логічні задачі з підказками
▫️ HumanEval — написання коду
▫️ MMLU — тести з 57 дисциплін (аналог IQ для LLM)
📊 Інтелект у цифрах:
Чим вищий відсоток — тим глибше мислення, кращий логічний ланцюжок і точніші відповіді.
💡 Цікаво, що GPT‑4o формально лідирує у тестах типу MMLU та GSM8K,
але…
🤔 На практиці:
Багато користувачів помічають:
👉 o3
▫️ краще міркує поетапно
▫️ рідше “фантазує”
▫️ не спрощує складну логіку
▫️ частіше дає чітке пояснення крок за кроком
Це як з людьми: один студент може добре скласти тест, а інший — справді глибоко розуміє суть.
✅ Став 👍 якщо було корисно
🔔 ПІДПИСАТИСЯ
У попередньому пості я використав фразу:
«Мислення — це здатність до міркування».
І, можливо, у тебе виникло цілком логічне запитання:
👉 Якщо памʼять моделі можна виміряти в токенах — то як вимірюється інтелект?
🔸 Памʼять — це кількість токенів, які модель може “тримати в голові” (сontext window) в одному запиті.
🔸 Мислення — це здатність моделі логічно міркувати, будувати ланцюжки, узагальнювати та робити висновки.
🔬 У світі AI це називають reasoning — і перевіряють цю здатнисть через спеціальні тести: 👇
▫️ GSM8K — шкільна математика (6–8 клас)
▫️ Big-Bench — логічні задачі з підказками
▫️ HumanEval — написання коду
▫️ MMLU — тести з 57 дисциплін (аналог IQ для LLM)
📊 Інтелект у цифрах:
GPT‑3.5        — MMLU: ~70%   | GSM8K: ~57%
GPT‑4o         — MMLU: ~88%   | GSM8K: ~93%
GPT‑4.1 mini   — MMLU: ~76%   | GSM8K: ~68%
GPT‑o3         — MMLU: ~86%   | GSM8K: ~89%
Чим вищий відсоток — тим глибше мислення, кращий логічний ланцюжок і точніші відповіді.
💡 Цікаво, що GPT‑4o формально лідирує у тестах типу MMLU та GSM8K,
але…
🤔 На практиці:
Багато користувачів помічають:
👉 o3
▫️ краще міркує поетапно
▫️ рідше “фантазує”
▫️ не спрощує складну логіку
▫️ частіше дає чітке пояснення крок за кроком
Це як з людьми: один студент може добре скласти тест, а інший — справді глибоко розуміє суть.
✅ Став 👍 якщо було корисно
🔔 ПІДПИСАТИСЯ
1👍24
🚀 GPT-5: свіжий реліз і головне, що потрібно знати
Вчора OpenAI офіційно представила GPT-5. Це справжній прорив, і тепер саме ця модель стала дефолтною у ChatGPT.
Хто дивився презентацію онлайн? 💬
Усі канали вже наввипередки розповідають, яка вона розумна, швидка і геніальна. Я не буду повторювати те, що ви й так прочитаєте в новинах. Натомість дам коротку вичавку з офіційної документації, яку, впевнений, більшість навіть не відкриє.
Джерело: офіційний гайд OpenAI
📌 Два режими роботи
🔹 GPT-5 Chat — швидкий режим для повсякденних завдань.
🔹 GPT-5 Thinking — «довге мислення» для складних запитів (код, наука, аналіз даних). Для тих, хто звик працювати з o3 — відчуття буде знайоме 😉.
📌 Ліміти за тарифами
Free
▪️ 10 повідомлень / 5 годин у Chat
▪️ 1 Thinking-повідомлення на день
▪️ Після ліміту — перехід на mini-модель
Plus
▪️ 80 повідомлень / 3 години у Chat
▪️ 200 Thinking-повідомлень на тиждень при ручному виборі — тепер доведеться осмислено формулювати запити, а не питати все підряд 😏
▪️ Автоперемикання у Thinking не витрачає тижневу квоту
Team
▪️ Ліміти як у Plus для Thinking
▪️ Автоперемикання не витрачає квоту
Pro
▪️ GPT-5 Thinking Pro — ще глибше й повільніше мислення
▪️ Немає тижневого ліміту (але діють антиаб’юз-обмеження)
📌 Важливий момент
Усі моделі, які ми нещодавно розбирали у постах — GPT-4o, GPT-4.1, GPT-4.5, o3 та інші — більше недоступні. Їх прибрали, і тепер GPT-5 став стандартом 🥴.
Це ще раз показує, наскільки швидко розвивається AI-сфера і як швидко застаріває інформація.
⚠️ ВАЖЛИВО: ліміти на Thinking враховуються тільки якщо ви вручну обираєте цю модель. Якщо GPT-5 сам вирішить, що йому треба «подумати довше» — це не йде у ліміт.
💡 Лайфхак: якщо перед запитом писати щось на кшталт «Подумай дуже добре й видай правильну відповідь» або навіть англійське «Think harder» — моделька майже завжди перемикається у Thinking автоматично, і це не витрачає тижневу квоту 😉.
А ви вже встигли протестувати GPT-5? Які враження?
Я вважаю, що лише за цей лайфхак цей пост заслуговує на 👍 .
Пишіть у коментарях 👇, поділимося досвідом.
🔔 ПІДПИСАТИСЯ
#ChatGPT #GPT5
👍22
💥 Учора весь інтернет гудів про вихід GPT-5.
Зізнаюсь — я теж чекав на вау. Але після дня тестів у різних конфігураціях враження змішані: пише не так яскраво, як GPT-4.5, і працює не завжди краще за о3. Схоже, спроба зібрати в одну модель усі завдання, які раніше тягнули окремі моделі, вийшла… так собі.
Не дивно, що на Reddit хвиля критики. Сам Альтман визнав, що очікували «помірний негатив», але не настільки, і пообіцяв швидкі покращення. Хто зна, можливо, навіть повернуть GPT-4о, бо запити від користувачів сипляться.
І тут варто згадати не лише бізнес, а й кращі практики управління проєктами: не можна відмовлятися від того, що працює, на користь неперевіреного. Якби вони залишили старі моделі й додали нову — користувачі поступово перейшли б на «п’ятірку», а OpenAI мала б час її підтягнути. Але вибрали хайп, і в результаті багато хто вже думає відписатися від платної підписки.
🔔 ПІДПИСАТИСЯ
👍12👌1
🇺🇸 vs 🇨🇳 Чому OpenAI відкрила свої моделі? І чи варто це вважати сигналом змін у геополітичному ландшафті?
Ситуація з нещодавнім відкриттям моделей gpt-oss-20b та gpt-oss-120b від OpenAI змусила мене замислитися не лише як інженера, а і як громадянина цифрової епохи — я вже писав про це тут.
Вирішив трохи розбавити освітній контент аналітикою — спробуємо поглянути на ситуацію ширше 👇
Це виглядає як красива історія: підтримка спільноти, відкритості, свободи знань. Але я не міг не спитати себе: чи справді великі гравці сьогодні думають про людей?
Хочеться вірити, що так. Але якщо чесно — глибокі альтруїстичні мотиви рідко рухають компаніями такого масштабу.
Читаючи аналітику, лідерборди моделей і спостерігаючи за тенденціями останніх місяців, ловлю себе на думці: Китай вже не просто наздоганяє — він реально поруч.
Причому не за рахунок кількох проривів, а завдяки цілісному підходу: відкритим моделям, масштабному виробництву чипів, агресивній конкуренції.
📊 На LLM-лідербордах видно:
▪️ У сегменті пропрієтарних моделей досі домінують США — GPT‑4o, Claude 4 Opus, Gemini 2.5 Pro.
▪️ Але у відкритому сегменті вже лідирує Китай: DeepSeek, Qwen3, Kimi, GLM 4.5 — і багато з них обганяють навіть Llama 4 та Gemma 2.
Чому так?
У США досі домінує підхід «секретність = перевага». Компанії скуповують таланти, захищають свої моделі як комерційну таємницю, вкладаються у власні “секретні інгредієнти”. Обмін знаннями — повільний, контрольований, дорогий.
У Китаї — протилежна стратегія: публікація коду, змагання на відкритих платформах, постійна боротьба за клієнтів, таланти й увагу. Це не просто хаос — це механізм жорсткого добору, де виживає не найбільший, а найспритніший і найадаптивніший.
🔎 У цьому контексті дуже показовим є AI Action Plan, нещодавно опублікований Білим домом.
— AI Action Plan, 2025
Інакше кажучи: відкритість — це вже не лише технологічне благо, а питання стратегії національного масштабу.
📌 Висновок:
Відкриття моделей OpenAI — це не просто жест. Це відповідь на прорив Китаю і реакція на новий курс США щодо open-source.
OpenAI зробила хід на випередження, щоб перехопити ініціативу в боротьбі за відкритий сегмент.
Якщо Google, Meta, Anthropic теж відкриють свої моделі — це стане підтвердженням: AI-стратегії більше не формуються лише в офісах компаній — тепер на них впливає і геополітика, і державна політика.
🔽 Якщо цей аналітичний формат вам сподобався — дайте знати пальцем вгору 👍. Можливо, варто час від часу робити не лише освітні, а й геополітичні дописи.
🔔 ПІДПИСАТИСЯ
#AIГеополітика #AIАналітика
Ситуація з нещодавнім відкриттям моделей gpt-oss-20b та gpt-oss-120b від OpenAI змусила мене замислитися не лише як інженера, а і як громадянина цифрової епохи — я вже писав про це тут.
Вирішив трохи розбавити освітній контент аналітикою — спробуємо поглянути на ситуацію ширше 👇
Це виглядає як красива історія: підтримка спільноти, відкритості, свободи знань. Але я не міг не спитати себе: чи справді великі гравці сьогодні думають про людей?
Хочеться вірити, що так. Але якщо чесно — глибокі альтруїстичні мотиви рідко рухають компаніями такого масштабу.
Читаючи аналітику, лідерборди моделей і спостерігаючи за тенденціями останніх місяців, ловлю себе на думці: Китай вже не просто наздоганяє — він реально поруч.
Причому не за рахунок кількох проривів, а завдяки цілісному підходу: відкритим моделям, масштабному виробництву чипів, агресивній конкуренції.
📊 На LLM-лідербордах видно:
▪️ У сегменті пропрієтарних моделей досі домінують США — GPT‑4o, Claude 4 Opus, Gemini 2.5 Pro.
▪️ Але у відкритому сегменті вже лідирує Китай: DeepSeek, Qwen3, Kimi, GLM 4.5 — і багато з них обганяють навіть Llama 4 та Gemma 2.
Чому так?
У США досі домінує підхід «секретність = перевага». Компанії скуповують таланти, захищають свої моделі як комерційну таємницю, вкладаються у власні “секретні інгредієнти”. Обмін знаннями — повільний, контрольований, дорогий.
У Китаї — протилежна стратегія: публікація коду, змагання на відкритих платформах, постійна боротьба за клієнтів, таланти й увагу. Це не просто хаос — це механізм жорсткого добору, де виживає не найбільший, а найспритніший і найадаптивніший.
🔎 У цьому контексті дуже показовим є AI Action Plan, нещодавно опублікований Білим домом.
“Open-source and open-weight models could become global standards in some areas of business and in academic research worldwide. For that reason, they also have geostrategic value.”
— AI Action Plan, 2025
Інакше кажучи: відкритість — це вже не лише технологічне благо, а питання стратегії національного масштабу.
📌 Висновок:
Відкриття моделей OpenAI — це не просто жест. Це відповідь на прорив Китаю і реакція на новий курс США щодо open-source.
OpenAI зробила хід на випередження, щоб перехопити ініціативу в боротьбі за відкритий сегмент.
Якщо Google, Meta, Anthropic теж відкриють свої моделі — це стане підтвердженням: AI-стратегії більше не формуються лише в офісах компаній — тепер на них впливає і геополітика, і державна політика.
🔽 Якщо цей аналітичний формат вам сподобався — дайте знати пальцем вгору 👍. Можливо, варто час від часу робити не лише освітні, а й геополітичні дописи.
🔔 ПІДПИСАТИСЯ
#AIГеополітика #AIАналітика
1👍26👎1🔥1
📌 Prompt тижня: Step-by-step
🎯Хочеш, щоб ChatGPT перетворював складні теми на простий план дій?
Використовуй цей prompt:
👉 Explain this step-by-step so a beginner can follow it: [тема]
Тема може бути українською чи іншою: бізнес-процеси, уроки, технічні навички.
💡 Що робить цей prompt: Модель розбиває складну задачу на зрозумілі кроки з поясненнями та прикладами, щоб ти міг діяти без плутанини.
🗣 Чому краще писати англійською?
• ChatGPT “тренувався” переважно на англомовних даних
• Відповіді часто виходять чіткіші та структурованіші
• Потім можна попросити: Translate to Ukrainian — і отримати якісний переклад
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Дочекайся списку кроків
3️⃣ Запитай: “Додай чеклист і типові помилки” — щоб уникнути підводних каменів
🧪 Приклади:
👨🏫 Завдання:
Використовуй цей prompt щодня протягом тижня — на теми, які тебе цікавлять.
Результат: більше структурованих дій, менше хаосу.
💬 Напиши в коментарях, яку тему ти спробуєш цього тижня.
Став 👍 Якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
🎯Хочеш, щоб ChatGPT перетворював складні теми на простий план дій?
Використовуй цей prompt:
👉 Explain this step-by-step so a beginner can follow it: [тема]
Тема може бути українською чи іншою: бізнес-процеси, уроки, технічні навички.
💡 Що робить цей prompt: Модель розбиває складну задачу на зрозумілі кроки з поясненнями та прикладами, щоб ти міг діяти без плутанини.
🗣 Чому краще писати англійською?
• ChatGPT “тренувався” переважно на англомовних даних
• Відповіді часто виходять чіткіші та структурованіші
• Потім можна попросити: Translate to Ukrainian — і отримати якісний переклад
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Дочекайся списку кроків
3️⃣ Запитай: “Додай чеклист і типові помилки” — щоб уникнути підводних каменів
🧪 Приклади:
Explain this step-by-step so a beginner can follow it: Як інтегрувати штучний інтелект у навчальний процес Explain this step-by-step so a beginner can follow it: підготовка бізнес-плану для інвестора Explain this step-by-step so a beginner can follow it: налаштування системи контролю версій для інженерного проекту 👨🏫 Завдання:
Використовуй цей prompt щодня протягом тижня — на теми, які тебе цікавлять.
Результат: більше структурованих дій, менше хаосу.
💬 Напиши в коментарях, яку тему ти спробуєш цього тижня.
Став 👍 Якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
5👍19👏1
📘 Prompt Programming: як студенти вчаться програмувати через діалог із AI
Збираючи для вас корисну інформацію про промптінг і роботу з AI, я натрапив на цікаве нове дослідження, опубліковане на ITiCSE 2025. У статті описано дослiдження через платформу Prompt Programming, яка вчить студентів не просто писати код — а співпрацювати з генеративними AI-моделями через діалог.
🧠 Проблема: як навчати програмуванню в епоху AI?
Сьогодні студенти все частіше звертаються до ChatGPT, Copilot та інших LLM-асистентів, щоби швидше писати код. Але:
🔹 Вони не мають формального навчання, як правильно з ними працювати
🔹 Не вміють формулювати ефективні запити (промпти), щоби отримати потрібне рішення
🔹 Часто довіряють результатам “як є”, не перевіряючи, чи справді код коректний
🔹 Не розвивають важливі навички: читання, перевірки, адаптації та редагування коду
👨🏫 Раніше завдання курсу з програмування — навчити писати код з нуля.
Тепер — навчити співпрацювати з AI: ставити правильні запитання, перевіряти результати, мислити критично.
🔍 Що зробили дослідники?
▪️ Створили платформу Prompt Programming, яка вчить студентів взаємодіяти з LLM
▪️ Додали підтримку мультикрокових діалогів, де студент поступово уточнює запит
▪️ Реалізували задачі з кількома пов’язаними функціями — як у реальному коді
▪️ Дозволили вибірково запускати код, щоби перевірити його коректність
🧪 У дослідженні взяли участь 900+ студентів, які проходили курс C-програмування. Автори аналізували:
— як студенти формулюють запити
— як будують рішення через кілька кроків
— коли і чому вирішують запустити код
— як змінюється стратегія залежно від складності задачі
📈 Що виявили:
▪️ Студенти активно використовували діалог, а не одноразові запити
▪️ У складніших задачах довші діалоги та більше уточнень
▪️ Запускали код вибірково — частіше тоді, коли вважали його правильним
▪️ Більшість дійшла висновку, що комбінація промптів і ручного коду — найкраща тактика
🌍 Навіщо це все?
Це не просто тренажер. Це — навчальне середовище, яке формує сучасні навички:
мислити через AI, перевіряти, уточнювати, співпрацювати.
📎 Платформа Prompt Programming доступна публічно разом з навчальними задачами.
🔗 Назва статті:
Prompt Programming: A Platform for Dialogue-based Computational Problem Solving with Generative AI Models
ITiCSE 2025
Читати повний текст (PDF)
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
1👍15👏1
📚 Як ефективно писати промпти для AI
У минулому пості я зробив огляд цікавої наукової статті з конференції ITiCSE 2025, де дослідники представили платформу Prompt Programming — середовище, що вчить студентів взаємодіяти з AI у вигляді діалогу.
А ось ще кілька корисних прийомів із цього дослідження, які легко застосувати у щоденній роботі з LLM (не тільки в програмуванні) 👇
🔁 Ітеративне уточнення промптів
Замість одного великого запиту — кілька уточнюючих. Це дозволяє покращити якість результату й краще зрозуміти логіку моделі.
🧩 Модульне мислення
Розбивай задачу на частини. Запитуй спочатку структуру, потім окремі елементи — це спрощує перевірку й адаптацію.
🧠 Уважна перевірка перед запуском
Не довіряй відповіді “наосліп”. Студенти запускали лише той код, який виглядав правильним — і це гарна стратегія для будь-яких AI-відповідей.
⚖️ Поєднання промптінгу з ручною роботою
Найкраще працює гібрид: частину — формулюєш словами, частину — допрацьовуєш сам. Це дає контроль і точність.
💬 Кілька повідомлень — краще, ніж одне
Дослідження показало: багатокрокові діалоги з AI дають кращі результати, ніж один «всеохопний» запит.
🔗 Стаття повністю (PDF):
Prompt Programming на arXiv
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍16
📊 Як побудова промпту впливає на якість коду?
Копаючи тему промптинга глибше, натрапив ще на дуже цікаве дослідження, яким хочу поділитися з вами.
Якщо є час і бажання — ознайомтесь з оригіналом.
А якщо ні — тримайте коротку й корисну вичимку 👇
🧪 Що досліджували?
▪️ Як саме структура запиту до LLM (GPT-4o, LLaMA 3, Mistral) впливає на:
— ✔️ правильність коду
— 🤖 схожість із людським рішенням
— 🧼 стиль і якість (code smells, складність)
▪️ Протестували 7 000+ промптів із 5 техніками:
Few-shot — приклади у запиті
Chain-of-Thought — “думай уголос”
Function Signature — тчітко вказати типи параметрів
Persona — надати LLM роль (наприклад: "ти досвідчений розробник")
Packages — явно вказати, які імпортувати
📈 Що виявили?
✅ Найефективніша техніка — function signature. Вона різко покращує правильність.
➕ Few-shot також корисна, особливо у парі зі структурою.
⚠️ Техніки на кшталт persona і CoT самі по собі не гарантують якість — іноді навіть погіршують точність.
🧠 Chain-of-Thought і persona зменшують code smells, але не обов’язково дають правильну відповідь.
📉 Few-shot може зменшити схожість із людським кодом — хоча іноді й покращує результат.
📌 Що це означає для нас?
На основі цього дослідження ми можемо суттєво покращити свої запити до AI, якщо:
🔹 Чітко описуємо, що саме хочемо (структура, формат, очікуваний результат)
🔹 Додаємо приклади або вводимо модель у контекст
🔹 Вказуємо обмеження — що можна, а що не потрібно
🔹 А вже потім — додаємо стиль, роль ("ти експерт", "пиши як маркетолог", тощо)
📎 Оригінал дослідження (PDF):
arXiv: The Impact of Prompt Programming on Function-Level Code Generation
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍8🔥5
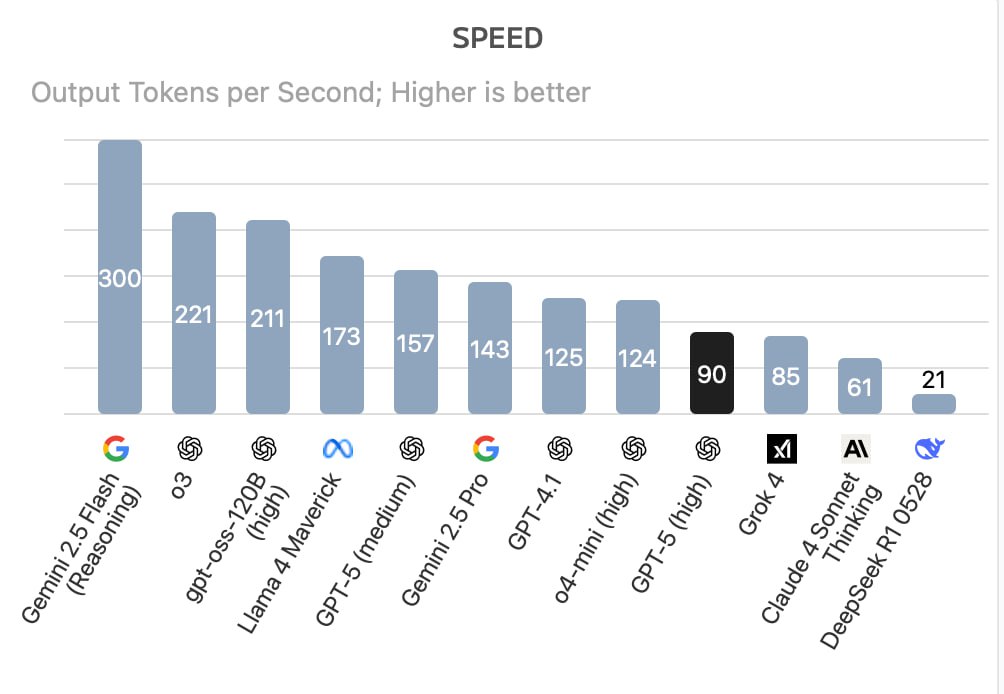
🧠 GPT-5 уже тут. Але старт — неідеальний
Минулого тижня вийшов довгоочікуваний GPT‑5, про який я вже писав у попередньому пості. Але реліз виявився не таким тріумфальним, як очікувалось: спільнота вибухнула обуренням, дехто навіть захотів скасувати підписку.
Сем Альтман та команда OpenAI протягом тижня екстрено виправляли помилки, і були змушені повернути GPT‑4o, o3 та інші моделі назад у ChatGPT. Щоправда, o3 тепер доступна тільки за Pro-підпискою за $200/міс.
🎯 Тож давай підсумуємо — що нового та які реальні результати ми вже маємо.
💡 Що нового в GPT‑5:
• Це не просто модель, а сімейство систем: GPT‑5, GPT‑5 Mini, Nano та Pro
• Кожна з них має різну продуктивність, швидкість та глибину “мислення”
• Додано роутер, який автоматично визначає, яку модель використати — на основі складності запиту, наявності інструментів і навіть фраз типу “think step-by-step”
• Усі моделі в інтерфейсі ChatGPT були замінені на GPT‑5 без попередження
⚠️ Але роутер зламався прямо “на старті”, і через це:
• Користувачі бачили повільні або поверхневі відповіді
• Були випадки автоматичного перемикання на Mini/Nano без пояснення
• Це змусило OpenAI екстрено повернути доступ до старих моделей
📊 Продуктивність на бенчмарках:
• SWE-Bench (software engineering tasks): GPT‑5 — 74.9% vs Claude Opus — 74.5%
• AIME 2025 (математичні задачі): GPT‑5 (high reasoning) — 94.6% vs o3 — 88.9%
• EQ-Bench Creative Writing: GPT‑5 — 90.3 vs o3 — 87.6 vs Gemini‑2.5‑Pro — 86.0
• Індекс Intelligence від Artificial Analysis: GPT‑5 (medium/high reasoning) — №1 серед усіх моделей
❗️ Але на деяких тестах GPT‑5 виступила гірше:
• ARC-AGI‑1/2 (абстрактне мислення, візуальні задачі): GPT‑5 — 65.7% / 9.9%
Grok 4 Thinking — 66.7% / 16.0%
🔗 GPT‑5 перевершує попередні моделі на більшості тестів
🧰 Можливості для розробників:
• 4 рівні міркування (від “без міркувань” до “глибоке міркування”)
• 3 рівні багатослівності (output length)
• Інструменти можна викликати через JSON або natural language
• Можна явно вказати, чи використовувати reasoning / non-reasoning модель
• Підсумок reasoning‑токенів після відповіді
🔗 Докладно про нові параметри та функції GPT‑5
🎯 Висновок:
GPT‑5 — це вже не просто “модель”, а ціла адаптивна система з можливістю змінювати глибину мислення, розмір відповіді та логіку обробки запиту. Для новачків це виглядає зручно. Але питання до досвідчених користувачів:
чи готові ви віддати контроль "роутеру" — і не знати, яка саме модель відповідає?
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍7🔥3👻1
🇮🇳 Індія створює власні LLM — із тисячами топових відеокарт NVIDIA
Для того щоб трохи розбавити потужні теоретичні пости, від яких ви могли вже втомитись — розбавлю трошки цікавими новинами 👇
У 2024 році американські AI-стартапи залучили $97B, європейські — $51B. А індійські — лише $780M.
Попри обмежені ресурси, Індія запускає масштабну програму розвитку власних AI-моделей.
🔸 У січні уряд Індії оголосив збір пропозицій на розробку національних LLM — буквально через 10 днів після релізу китайського DeepSeek‑R1.
До речі, і ми не відстаємо: в Україні Київстар, Мінцифра та WINWIN AI Centre of Excellence вже працюють над власною національною LLM, а її запуск планується до грудня 2025 року. [читати детальніше]
🔸 Для цього Індія зарезервувала 19 000 вiдеокарт (GPU), з них 13 000 — NVIDIA H100 — одні з найпотужніших відеокарт у світі, які використовують для навчання великих моделей.
🔸 У квітні уряд Індії обрав шість команд для створення національних мовних моделей. Серед них:
SSarvam AI працює над потужною моделлю на 70 мільярдів параметрів, яка розуміє кілька мов і вміє працювати з голосом — що особливо важливо для людей, які не читають чи не пишуть.
Soket AI Labs створює ще більшу — на 120 мільярдів параметрів.
CoRover вже представив першу версію — BharatGPT (3.2B), яка підтримує голосовий інтерфейс 12 мовами. Також вийшла компактна версія — BharatGPT Mini (534M), яка працює навіть на слабких пристроях.
📏 Для порівняння:
GPT‑3 від OpenAI — 175B параметрів
GPT‑4 (за чутками) — понад 1 трильйон параметрів (точна кількість не розкривається)
Grok (від X / Elon Musk) — ~314B у версії Grok-1.5
Claude 3 Opus (Anthropic) — приблизно 200B
LLaMA 2 (Meta) — випускалась у варіантах 7B, 13B, 70B
🔍 Тобто індійські моделі вже входять у той самий "ваговий клас", що й продукти глобальних AI-гігантів.
⚙️ Виклики:
Понад 120 мов і 19 500 діалектів
У багатьох мов немає чіткого поділу між словами — важко токенізувати
Нестача якісних текстових корпусів
Суттєво менше фінансування, ніж у США чи Китаї
💡 Але тут важлива не лише технологія. А те, що країна створює свої власні голоси, культурні коди й світогляд в архітектурі моделей.
📌 Джерело: MIT Technology Review
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍12
🌍 Чому країни масово створюють свої AI-моделі?
(Як продовження попереднього поста 👉 про Індію)
У минулому дописі я писав, як Індія запускає власну велику мовну модель (LLM) — і чому це важливо для неї.
Але це — не одиничний кейс.
Сьогодні ми бачимо глобальний тренд: уряди по всьому світу інвестують у розробку власних AI-моделей.
Від ОАЕ до Франції, від Японії до України — країни створюють моделі, які відображають їхню мову, культуру й інтереси.
🔍 Постає логічне питання: навіщо це все?
Чому не користуватися просто GPT, Claude або Grok, як ми користуємось, скажімо, браузером Chrome чи пошуком Google?
Давайте розберемося 👇
🇨🇺 1. Культурна точність
Глобальні моделі навчені переважно на англомовних даних. Вони "думають" у межах західного контексту.
Поняття, гумор, соціальні ролі, навіть уявлення про добро і зло — усе це передається через фільтр іншої культури.
LLM легко відповідають на питання про Супермена чи Starbucks — але можуть не знати, що таке “Козацька Рада” або “вереснева хмаринка”.
📌 Проблеми з культурною неупередженістю:
Згідно з дослідженням CultureLLM, моделі LLM демонструють упередженість щодо культур із малою цифровою присутністю.
Під час навчання переважають англомовні дані, тому культури з “low-resource” мовами часто ігноруються або спрощуються.
🛡 2. Цифровий суверенітет
AI — це не просто технологія. Це майбутній мозок у системах оборони, освіти, медицини, фінансів.
“AI will become the central nervous system of digital government and economic systems.”
— Stanford HAI, 2024 AI Index
Якщо в тебе немає своєї моделі — у тебе немає контролю над тим, як і що вона “думає”.
Залежність від чужого AI = залежність від чужих цінностей, пріоритетів і обмежень.
📌 І це не лише слова. Цифровий суверенітет вже став офіційною стратегією багатьох держав:
▪️ Франція — “Souveraineté numérique”
▪️ Німеччина — GAIA-X
▪️ ОАЕ — Falcon AI під державним контролем
▪️ Китай — локальні моделі (Qwen, Yi) з відкритими вагами, але обов’язковим ліцензуванням
🟡 А що Україна?
У березні 2025 Київстар, Мінцифра та WINWIN AI Centre of Excellence підписали меморандум про розробку першої в Україні національної LLM.
[читати офіційний реліз]
🗣 3. Збереження мов і діалектів
Багато мов просто не представлені у світових моделях. Це означає — їх не “чують”, вони не мають впливу.
Національні LLM — це шанс дати цифрове життя рідній мові й уникнути зникнення.
В Індії понад 19 000 діалектів. В Україні — купа говорів і регіональних форм.
Без своїх моделей — вони зникнуть із цифрового простору.
📜 4. Право на власну етику й закон
Американські моделі відповідають американським законам. Китайські — китайським.
Тільки власна модель може працювати за твоїми правилами — у межах твоєї Конституції, твоєї системи освіти, твоєї моралі.
🤝 Висновок:
Власна LLM — це не розкіш і не забаганка. Це — цифрова незалежність.
Бо якщо твоєї моделі немає — твоєї культури немає в AI.
І тоді хтось інший напише твою історію замість тебе.
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍19⚡3❤1🔥1
📌 Prompt тижня: I’m probably wrong, but … What do you think?
🎯 Хочеш, щоб ChatGPT не просто відповідав, а перевіряв твої ідеї на міцність?
Спробуй цей prompt:
👉 I’m probably wrong, but [твердження] — what do you think?
Тема може бути будь-яка: бізнес, освіта, технології, соціальні питання.
💡 Що робить цей prompt:
Модель починає мислити критично, знаходить слабкі місця та дає аргументи з різних боків — і «за», і «проти».
Це допомагає уникнути упереджень і прокачати власне мислення.
📎 Що зробити:
1️⃣ Сформулюй своє припущення у форматі “I’m probably wrong, but…”
2️⃣ Дочекайся відповіді з аргументами
3️⃣ Запитай: “Play devil’s advocate against your answer” — щоб отримати ще глибший аналіз
🧪 Приклади:
👨🏫 Завдання:
Спробуй цей prompt мінімум 3 рази цього тижня на різні теми.
Результат: більш критичне мислення і свіжі ідеї, які ти б сам не побачив.
💬 Напиши в коментарях, яке припущення ти перевіриш першим.
Став 👍 якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
🎯 Хочеш, щоб ChatGPT не просто відповідав, а перевіряв твої ідеї на міцність?
Спробуй цей prompt:
👉 I’m probably wrong, but [твердження] — what do you think?
Тема може бути будь-яка: бізнес, освіта, технології, соціальні питання.
💡 Що робить цей prompt:
Модель починає мислити критично, знаходить слабкі місця та дає аргументи з різних боків — і «за», і «проти».
Це допомагає уникнути упереджень і прокачати власне мислення.
📎 Що зробити:
1️⃣ Сформулюй своє припущення у форматі “I’m probably wrong, but…”
2️⃣ Дочекайся відповіді з аргументами
3️⃣ Запитай: “Play devil’s advocate against your answer” — щоб отримати ще глибший аналіз
🧪 Приклади:
I’m probably wrong, but дистанційна робота продуктивніша за офісну — what do you think? I’m probably wrong, but регулювання ШІ зупинить інновації — what do you think? I’m probably wrong, but YouTube програє TikTok у довгостроковій перспективі — what do you think? 👨🏫 Завдання:
Спробуй цей prompt мінімум 3 рази цього тижня на різні теми.
Результат: більш критичне мислення і свіжі ідеї, які ти б сам не побачив.
💬 Напиши в коментарях, яке припущення ти перевіриш першим.
Став 👍 якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
5👍18🔥4
📌 Чому ваш запит до AI не працює?
У попередньому пості я робив огляд наукової статті про промптинг — дослідження проводили на прикладі програмування.
Але, незважаючи на технічну тематику, результати дослідження легко адаптувати під наші щоденні запити до AI — у навчанні, роботі, бізнесі чи творчості.
Ось 5 порад з цього дослідження, які допоможуть писати складні, але ефективні запити 👇
1️⃣ Структуруйте запит
Замість “Напиши мені текст” — краще сформулюйте чітко:
▪️ тему
▪️ стиль або тон
▪️ обсяг
▪️ приклад схожого формату
2️⃣ Формат і обмеження мають значення
Вкажіть, який результат хочете: список, таблицю, опис у 3 абзаци…
Також додайте, що не потрібно (наприклад, "без емодзі", "не згадуй ChatGPT").
3️⃣ Подавайте приклади
Один хороший приклад у промпті допомагає AI краще зрозуміти контекст і стиль. Це значно підвищує якість відповіді.
4️⃣ Не покладайтесь лише на “роль”
Фраза “уяви, що ти маркетолог / письменник / історик” корисна, але не замінює чітких інструкцій. Краще — роль + структура + приклад.
5️⃣ Не бійтеся писати довгі промпти
Складне завдання потребує деталізації. AI працює краще, коли точно знає, чого ви хочете.
💡 У дослідженні протестували 7 000+ варіантів запитів на GPT‑4o, LLaMA 3 і Mistral — і всі ці висновки засновані на фактах.
📎 Ознайомитись з повною статтею можна тут (PDF):
The Impact of Prompt Programming on Function-Level Code Generation
🔁 Зберігайте пост і експериментуйте — результат дійсно змінюється, коли змінюється запит.
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
Telegram
ProofOf{P}
📊 Як побудова промпту впливає на якість коду?
Копаючи тему промптинга глибше, натрапив ще на дуже цікаве дослідження, яким хочу поділитися з вами.
Якщо є час і бажання — ознайомтесь з оригіналом.
А якщо ні — тримайте коротку й корисну вичимку 👇
🧪 Що досліджували?…
Копаючи тему промптинга глибше, натрапив ще на дуже цікаве дослідження, яким хочу поділитися з вами.
Якщо є час і бажання — ознайомтесь з оригіналом.
А якщо ні — тримайте коротку й корисну вичимку 👇
🧪 Що досліджували?…
👍10👏5💯2
🎬 AI-згенероване відео — вже мейнстрім
Привіт, друзі!
Учора прочитав кілька новин про те, що зараз відбувається в AI, який працює з відео — і вирішив поділитися з вами найцікавішим.
Сьогодні інформація не надто складна (як це іноді буває у нас, коли ми глибоко занурюємось у технічні деталі 😅). Але буде цікаво всім, хто стежить за AI або просто хоче розуміти, як змінюється відеоіндустрія.
🔻 Отже, що нового?
▪️ Студія Dor Brothers із Берліна зняла вірусне відео The Drill (16+ млн переглядів), використовуючи лише AI.
▪️ Genre.ai зробила божевільну рекламу для Kalshi за $2K, згенерувавши понад 400 AI-кліпів — і відібравши з них лише 15 найкращих для фінального монтажу.
▪️ Netflix згенерувала сцену обвалу будівлі для серіалу The Eternaut за допомогою Runway — в 10 разів швидше й дешевше, ніж за класичною схемою.
🛠 Як це працює?
🔹 ChatGPT + Gemini → сценарії та шот-листи
🔹 Midjourney / DALL-E → картинки
🔹 Runway Gen-4 / Google Veo → відео
🔹 Все монтується у звичайному редакторі
🎯 Netflix, AMC, Lionsgate, Blumhouse і навіть Даррен Аронофскі вже інтегрують ці інструменти у продакшн.
🧠 Що це означає для нас?
AI забирає на себе частину традиційної відеотворчості: декорації, акторів, камери, монтаж.
Це знижує вартість входу в індустрію і відкриває двері новим креаторам.
А старі гравці можуть працювати швидше й масштабніше.
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍12❤3👎1🔥1🥴1
🧠 Як бізнес автоматизує роботу через AI‑агентів: приклади, інструменти, поради
Привіт, друзі!
Підготував практичний огляд про те, як бізнес уже зараз автоматизує процеси з допомогою AI‑агентів — автономних помічників на базі LLM‑моделей, які виконують рутину: комунікацію з клієнтами, звітність, бронювання, управління проектами.
🧩 Реальні кейси:
• Hebbia — агент-аналітик, який читає фінансові документи, робить висновки та пише меморандуми. Використовується в BlackRock, KKR, ВПС США, заощаджує сотні годин аналітики. джерело
• Retool Agents — автономні агенти обробляють клієнтські запити, аналітику, повернення. Працюють приблизно за $3/год, суттєво знижуючи навантаження. джерело
• TinyFish — агенти імітують дії користувачів на сайтах (моніторинг цін, бронювання, перевірка наявності). Використовуються в e‑commerce, навіть Google. джерело
---
🛠 Практичні підходи: які є AI‑агенти
• Кастомні агенти (LLM‑агенти)
Побудовані на GPT, Claude, Gemini — під ваші процеси, потребують технічної реалізації.
• No-code / low-code платформи
Relevance AI — агенти без коду.
SuperOps — автоматизація підтримки.
StackAI, MindStudio — швидкий запуск агентів з тексту або логіки.
• Корпоративні агенти (Copilots)
Microsoft Copilot for Service — інтегрується в Outlook, Teams та CRM (Salesforce, Zendesk), допомагає з email-чернетками, резюме кейсів, зустрічей.
OpenAI Agent Mode — автономне виконання завдань у браузері, Gmail, Drive.
Microsoft також працює над “Tenant Copilot” і “Agent Factory” — платформами для створення агентів як цифрових співробітників.
🧭 Який підхід обрати?
Стартап / технічний засновник → кастомний агент на базі LLM
Малий бізнес / школа / фітнес‑студія / звичайний користувач → Relevance AI, StackAI, MindStudio або OpenAI Agent Mode
Корпорація / B2B → Microsoft Copilot for Service або кастомні агенти через OpenAI Agent‑building platform
🔝 Топ‑5 задач, які агенти вже автоматизують:
1. Створення задач із листів або нотаток
2. Автоматична звітність і дашборди
3. Моніторинг проєктів і прогнозування ризиків
4. Автоматична клієнтська підтримка (FAQ, броні, запити)
5. Автономна бронь, покупки, реєстрація
---
📌 Висновок
AI‑агенти — це не майбутнє, а вже робочий інструмент, який допомагає компаніям будь-якого розміру економити час і гроші.
Сьогодні достатньо 1–2 днів, щоб протестувати агента під свої задачі — без коду і без великих бюджетів.
🗨 Напишіть у коментарях, якщо вам цікаво — підготую покроковий гайд:
як запустити агента під ваш бізнес, які інструменти обрати і як уникнути помилок на старті.
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍16👏2
🔍 Знайшов дуже круте дослідження від Meta, Google, Nvidia та Cornell
https://arxiv.org/pdf/2505.24832
У ньому розбирають, скільки насправді LLM запам’ятовують із тренувальних даних — і це не здогадки, а точне число в бітах 🤔
Готую для вас детальний і зрозумілий огляд — буде завтра!
⏳ Stay tuned.
https://arxiv.org/pdf/2505.24832
У ньому розбирають, скільки насправді LLM запам’ятовують із тренувальних даних — і це не здогадки, а точне число в бітах 🤔
Готую для вас детальний і зрозумілий огляд — буде завтра!
⏳ Stay tuned.
👍14👌3🔥1
🧠 Скільки LLM насправді запам’ятовують із тренувальних даних?
Як вам вже полюбилось — приношу огляд нового дослідження від Meta, Google, Nvidia та Cornell University, яке пропонує чіткий підхід:
➡️ вимірювати кількість бітів, які модель запам’ятала.
Ми часто чуємо: «модель навчилась», «модель згенерувала».
Але як зрозуміти, що вона дійсно навчилась, а що просто зазубрила з тренування?
📐 Як це працює?
Кожен текст можна представити як певну кількість бітів.
Якщо модель A стискає текст краще, ніж модель B — значить B просто запам’ятала частину тексту, а не узагальнила.
📌 Центральна ідея:
Це має глибоке коріння:
📖 Ще в 1951 році Клод Шеннон у статті Prediction and Entropy of Printed English показав:
ентропія = мінімальна кількість бітів, необхідна для представлення тексту.
🔍 Чому це важливо?
• 🧮 Математична точність: можна порахувати, скільки інформації модель надлишково запам’ятала
• 🧠 Нова метрика для LLM: автори порівнюють negative log likelihood (NLL) між навченою та "суперіорною" моделлю — це і є обсяг запам’ятовування в бітах
🔬 Експерименти
Автори тренували сотнi моделей GPT‑2 на:
• 🧪 синтетичних даних (випадкові токени, без узагальнення)
• 🌐 реальному тексті (FineWeb) з жорстким deduplication
🧮 Моделі: від 100K до 20M параметрів + GPT‑2 XL (1.5B)
📊 Результати:
✅ Дослідники встановили, що на кожен параметр модель запам’ятовує в середньому 3.6 біта.
Тобто, якщо у вас модель з 1 мільйоном параметрів — вона буквально запам’ятовує близько 450 000 байтів (≈450 КБ) із тренувальних даних. (При тому, що повний обсяг параметрів займає ≈2 МБ, тобто ≈¼ йде на «пам’ять».)
Щоб було зрозуміліше:
• В середньому 1 літера англійською = 1 байт
• Одне речення ≈ 50–100 байтів
Отже, така модель може дослівно запам’ятати тисячі речень з навчального набору.
А якщо параметрів — мільярди, як у GPT‑3 чи GPT‑4, обсяг запам’ятовування стає суттєвим.
✅ Меморизація не росте нескінченно.
На перших етапах модель просто зубрить дані, але згодом — починає узагальнювати, і запам’ятовування зменшується.
✅ Виявлено цікавий ефект double descent:
Тестова помилка моделі:
спочатку ➘ падає ➝ потім ➚ зростає (через перенавчання) ➝ потім ➘ знову падає, коли модель починає узагальнювати знання.
🧪 Що ще цікавого?
• 📉 Меморизація ≠ генерація — LLM може відтворити рядок, не запам’ятавши його
• 📈 Запам’ятовуються частіше тексти з рідкісними словами (TF‑IDF)
• 🔐 Membership inference атаки працюють лише при малих моделях і маленьких датасетах
📌 Висновки
Попередні спроби оцінити запам’ятовування базувались на генерації продовжень до відомих фрагментів — але це не завжди свідчить про запам’ятовування. Наприклад, фраза “привiт привiт привiт…” або проста арифметика можуть бути згенеровані без запам’ятовування. Ця робота пропонує теоретичне обґрунтування, яке дозволяє кількісно оцінити, наскільки моделі запам’ятовують свої тренувальні набори. І вона закладає основу для майбутніх підходів до зменшення запам’ятовування без потреби збільшувати обсяг даних.
🔗 Джерела
• 📄 How Much Do Language Models Memorize? (arXiv, 2025)
• 📖 Shannon (1951): Prediction and Entropy of Printed English
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
Як вам вже полюбилось — приношу огляд нового дослідження від Meta, Google, Nvidia та Cornell University, яке пропонує чіткий підхід:
➡️ вимірювати кількість бітів, які модель запам’ятала.
Ми часто чуємо: «модель навчилась», «модель згенерувала».
Але як зрозуміти, що вона дійсно навчилась, а що просто зазубрила з тренування?
📐 Як це працює?
Кожен текст можна представити як певну кількість бітів.
Якщо модель A стискає текст краще, ніж модель B — значить B просто запам’ятала частину тексту, а не узагальнила.
📌 Центральна ідея:
“A model’s negative log likelihood is equal to the minimum number of bits needed to represent a given piece of data.”
Це має глибоке коріння:
📖 Ще в 1951 році Клод Шеннон у статті Prediction and Entropy of Printed English показав:
ентропія = мінімальна кількість бітів, необхідна для представлення тексту.
🔍 Чому це важливо?
• 🧮 Математична точність: можна порахувати, скільки інформації модель надлишково запам’ятала
• 🧠 Нова метрика для LLM: автори порівнюють negative log likelihood (NLL) між навченою та "суперіорною" моделлю — це і є обсяг запам’ятовування в бітах
🔬 Експерименти
Автори тренували сотнi моделей GPT‑2 на:
• 🧪 синтетичних даних (випадкові токени, без узагальнення)
• 🌐 реальному тексті (FineWeb) з жорстким deduplication
🧮 Моделі: від 100K до 20M параметрів + GPT‑2 XL (1.5B)
📊 Результати:
✅ Дослідники встановили, що на кожен параметр модель запам’ятовує в середньому 3.6 біта.
Тобто, якщо у вас модель з 1 мільйоном параметрів — вона буквально запам’ятовує близько 450 000 байтів (≈450 КБ) із тренувальних даних. (При тому, що повний обсяг параметрів займає ≈2 МБ, тобто ≈¼ йде на «пам’ять».)
Щоб було зрозуміліше:
• В середньому 1 літера англійською = 1 байт
• Одне речення ≈ 50–100 байтів
Отже, така модель може дослівно запам’ятати тисячі речень з навчального набору.
А якщо параметрів — мільярди, як у GPT‑3 чи GPT‑4, обсяг запам’ятовування стає суттєвим.
✅ Меморизація не росте нескінченно.
На перших етапах модель просто зубрить дані, але згодом — починає узагальнювати, і запам’ятовування зменшується.
✅ Виявлено цікавий ефект double descent:
Тестова помилка моделі:
спочатку ➘ падає ➝ потім ➚ зростає (через перенавчання) ➝ потім ➘ знову падає, коли модель починає узагальнювати знання.
🧪 Що ще цікавого?
• 📉 Меморизація ≠ генерація — LLM може відтворити рядок, не запам’ятавши його
• 📈 Запам’ятовуються частіше тексти з рідкісними словами (TF‑IDF)
• 🔐 Membership inference атаки працюють лише при малих моделях і маленьких датасетах
📌 Висновки
Попередні спроби оцінити запам’ятовування базувались на генерації продовжень до відомих фрагментів — але це не завжди свідчить про запам’ятовування. Наприклад, фраза “привiт привiт привiт…” або проста арифметика можуть бути згенеровані без запам’ятовування. Ця робота пропонує теоретичне обґрунтування, яке дозволяє кількісно оцінити, наскільки моделі запам’ятовують свої тренувальні набори. І вона закладає основу для майбутніх підходів до зменшення запам’ятовування без потреби збільшувати обсяг даних.
🔗 Джерела
• 📄 How Much Do Language Models Memorize? (arXiv, 2025)
• 📖 Shannon (1951): Prediction and Entropy of Printed English
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍12🔥2❤1
🧩 Модель, ентропія і кількість бітів
Можливо, у вас виникло питання щодо фрази з нещодавнього дослідження:
🔍 Розбираємося 👇
Що означає “ентропія = мінімальна кількість бітів для представлення тексту”?
Це базовий принцип із теорії інформації Клода Шеннона:
🧠 Ентропія — це середня кількість бітів, необхідна для кодування одного символу або повідомлення, якщо ми хочемо стискати дані максимально ефективно, без втрати інформації.
🔧 Простий приклад:
• Якщо підкидаємо ідеальну монету (50/50), нам потрібно 1 біт:
• Якщо монета “зміщена” (наприклад, 90% шанс на орла), то можна кодувати ще ефективніше — і в середньому потрібно меньше 1 біта.
📦 Те саме з текстом:
У стандартному ASCII кожен символ займає 8 бітів (1 байт).
Але англійська мова не використовує всі символи з однаковою ймовірністю.
Часті символи, шаблони та слова — трапляються знову і знову.
🧠 Як довів Шеннон, можна стискати набагато ефективніше:
Ентропія англійської ≈ 1.3 біта/символ
📦 Приклад: слово “the”
У ASCII:
Але “the” — одне з найпоширеніших слів.
Якщо використовувати ефективне кодування (наприклад, метод Хаффмана), ми можемо присвоїти йому коротший код, скажімо:
📉 Завдяки цьому середнє стискання досягає ≈ 1.3 біта/символ
📐 Що таке метод Хаффмана?
• Будує дерево на основі частоти символів/слів
• Призначає коротші коди для частих елементів
• Дає префіксне кодування (жоден код не є початком іншого)
Цей принцип лежить в основі:
• Huffman coding
• Аритметичного кодування
• BPE, GPT tokenizer
📊 Зв’язок з моделями
У статті Prediction and Entropy of Printed English (1951) Шеннон описав ентропію як очікувану довжину найефективнішого коду.
У сучасному ML це записується так:
• Якщо модель впевнена у x → p(x) ≈ 1 → log ≈ 0
• Якщо не впевнена → p(x) мала → log велике → більше бітів
✅ Підсумок:
✔️ Ентропія — теоретична нижня межа стискання
✔️ −log₂(p(x)) — інформаційна “вартість” символу
✔️ LLM використовують це для loss-функцій, оцінки памʼяті та генерації
Став 👍, якщо стало зрозуміліше!
🔔 ПІДПИСАТИСЯ
Можливо, у вас виникло питання щодо фрази з нещодавнього дослідження:
“A model’s negative log likelihood is equal to the minimum number of bits needed to represent a given piece of data.”
🔍 Розбираємося 👇
Що означає “ентропія = мінімальна кількість бітів для представлення тексту”?
Це базовий принцип із теорії інформації Клода Шеннона:
🧠 Ентропія — це середня кількість бітів, необхідна для кодування одного символу або повідомлення, якщо ми хочемо стискати дані максимально ефективно, без втрати інформації.
🔧 Простий приклад:
• Якщо підкидаємо ідеальну монету (50/50), нам потрібно 1 біт:
0 = орел, 1 = решка• Якщо монета “зміщена” (наприклад, 90% шанс на орла), то можна кодувати ще ефективніше — і в середньому потрібно меньше 1 біта.
📦 Те саме з текстом:
У стандартному ASCII кожен символ займає 8 бітів (1 байт).
Але англійська мова не використовує всі символи з однаковою ймовірністю.
Часті символи, шаблони та слова — трапляються знову і знову.
🧠 Як довів Шеннон, можна стискати набагато ефективніше:
Ентропія англійської ≈ 1.3 біта/символ
📦 Приклад: слово “the”
У ASCII:
t = 8 біт, h = 8 біт, e = 8 біт → разом 24 бітиАле “the” — одне з найпоширеніших слів.
Якщо використовувати ефективне кодування (наприклад, метод Хаффмана), ми можемо присвоїти йому коротший код, скажімо:
“the” = 5 біт📉 Завдяки цьому середнє стискання досягає ≈ 1.3 біта/символ
📐 Що таке метод Хаффмана?
• Будує дерево на основі частоти символів/слів
• Призначає коротші коди для частих елементів
• Дає префіксне кодування (жоден код не є початком іншого)
Цей принцип лежить в основі:
• Huffman coding
• Аритметичного кодування
• BPE, GPT tokenizer
📊 Зв’язок з моделями
У статті Prediction and Entropy of Printed English (1951) Шеннон описав ентропію як очікувану довжину найефективнішого коду.
У сучасному ML це записується так:
−log₂(p(x)) — скільки бітів потрібно для представлення x, якщо ймовірність p(x)• Якщо модель впевнена у x → p(x) ≈ 1 → log ≈ 0
• Якщо не впевнена → p(x) мала → log велике → більше бітів
✅ Підсумок:
✔️ Ентропія — теоретична нижня межа стискання
✔️ −log₂(p(x)) — інформаційна “вартість” символу
✔️ LLM використовують це для loss-функцій, оцінки памʼяті та генерації
Став 👍, якщо стало зрозуміліше!
🔔 ПІДПИСАТИСЯ
👍13🙏2❤1
🇨🇳 Китай охолонув до чипів Nvidia. Що відбувається?
🔄 Після дозволу від уряду США, Nvidia та AMD знову почали продавати AI‑процесори в Китай. Але замість радості — китайська влада запровадила перевірку безпеки чипів і закликала місцеві компанії купувати тільки вітчизняне.
💥 DeepSeek, наприклад, намагалася тренувати свою нову модель DeepSeek-R2 на чипах Huawei — і не змогла. Проєкт затримується. Але держава тисне: хочеш підтримку — купуй китайське.
📉 Nvidia H20, спеціально зроблений для Китаю в обхід санкцій, звинувачено у можливих “бекдорах” і стеженні за користувачами. Nvidia заперечує.
🔐 Уряд Китаю:
• вимагає технічні пояснення щодо H20
• допитує Baidu, ByteDance і Tencent щодо планів купувати чипи з США
• просуває масштабну програму підтримки локальних виробників чипів
🇺🇸 США, зі свого боку:
• у 2022—2024 посилювали обмеження на експорт AI-чипів
• недавно скасували заборону — в обмін на рідкоземельні мінерали з Китаю
• запровадили 15% експортний збір з продажів AI-чипів у Китаї
• дозволили Nvidia розробити спрощений процесор на архітектурі Blackwell для КНР
🧠 AI = стратегічна перевага
Хто контролює AI — той контролює технології, економіку та оборону. США — лідери у пропрієтарних моделях. Китай — у відкритих. Але чипи залишаються ахіллесовою п’ятою. І КНР уже не хоче залежати від «ненадійного» постачальника.
📌 Цікаво: у світі вже масово використовують open-weight AI-моделі з Китаю.
А от чи почнуть купувати й китайські процесори — питання відкрите.
Став 👍, якщо стало зрозуміліше!
🔔 ПІДПИСАТИСЯ
#AIГеополітика
👍15
🤔 OpenAI будує обчислювальний мегамозок із Oracle
Щє трошки новин на вихідних, та подумати про те, як AI впливає на бізнеси та геополітику.
🔌 $30 млрд щорічно — OpenAI планує віддавати Oracle за нову хвилю дата‑центрів, потужністю 4,5 ГВт — це в 10 разів більше, ніж найбільші об’єкти, що будує Microsoft.
📍 Перший об’єкт уже працює (Stargate I) в Абіліні, Техас — і скоро з’явиться наступна черга. Разом вони дадуть понад 5 ГВт нового обчислювального ресурсу, що охоплює понад 2 млн чіпів.
🆙 Обсяг інфраструктури Stargate перевищить початкові плани: $500 млрд інвестицій у 10 ГВт інфраструктури за 4 роки в США.
👷♂️ Вони прогнозують понад 100 000 нових робочих місць — від будівництва до обслуговування дата‑центрів.
🤖 Це величезна інфраструктура для розвитку ШІ. На Stargate працюють:
— OpenAI — моделі
— Oracle — залізо + софт
— SoftBank — фінансування й енергетика
— Microsoft — інфраструктурна підтримка
— Nvidia, Crusoe, MGX — чіпи, будівництво й інвестиції
Що це змінює? Це не просто дата‑центри — це фундамент нової ери ШІ. Oracle стає ключовим гравцем у AI‑обчисленнях, а OpenAI може масштабуватися до GPT‑7 і далі.
⚡️ Головне питання — де взяти всю ту енергію? SoftBank може стати вирішальним гравцем — він активно інвестує в енергетику саме для ШІ.
🔗 Детальніше — офіційна стаття в блозі OpenAI
Став 👍, якщо було корисно !
🔔 ПІДПИСАТИСЯ
1👍7❤3🔥1
📌 Prompt тижня: Explain this to me like I’m 5
🎯 Хочеш, щоб ChatGPT пояснював складні речі максимально просто?
Спробуй цей prompt:
👉 Explain this to me like I’m 5: [тема]
Тема може бути будь-яка: бізнес-процеси, наукові теорії, нові технології чи навіть правопис.
💡 Що робить цей prompt:
Модель перекладає складні ідеї «з дорослої мови» на просту, зрозумілу та інтуїтивну.
Це допомагає швидко схопити суть і вже потім занурюватися глибше.
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Дочекайся пояснення простими словами
3️⃣ Запитай: “Now explain it to me like I’m an expert” — і отримаєш глибший рівень
🧪 Приклади:
👨🏫 Завдання:
Спробуй цей prompt мінімум 2 рази цього тижня.
Результат: ти швидко зрозумієш основу навіть найскладніших тем.
💬 Напиши в коментарях, яку тему ти попросиш пояснити «як п’ятирічному».
Став 👍 якщо пост був корисним!
🔔 ПІДПИСАТИСЯ
🎯 Хочеш, щоб ChatGPT пояснював складні речі максимально просто?
Спробуй цей prompt:
👉 Explain this to me like I’m 5: [тема]
Тема може бути будь-яка: бізнес-процеси, наукові теорії, нові технології чи навіть правопис.
💡 Що робить цей prompt:
Модель перекладає складні ідеї «з дорослої мови» на просту, зрозумілу та інтуїтивну.
Це допомагає швидко схопити суть і вже потім занурюватися глибше.
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Дочекайся пояснення простими словами
3️⃣ Запитай: “Now explain it to me like I’m an expert” — і отримаєш глибший рівень
🧪 Приклади:
Explain this to me like I’m 5: що таке блокчейнExplain this to me like I’m 5: як працює квантовий комп’ютерExplain this to me like I’m 5: бізнес-модель Netflix👨🏫 Завдання:
Спробуй цей prompt мінімум 2 рази цього тижня.
Результат: ти швидко зрозумієш основу навіть найскладніших тем.
💬 Напиши в коментарях, яку тему ти попросиш пояснити «як п’ятирічному».
Став 👍 якщо пост був корисним!
🔔 ПІДПИСАТИСЯ
👍19🔥1🤔1