
📌 Prompt тижня: Give me the 80/20 of ...
🎯 Хочеш швидко розібратись у складній темі? Спробуй цей prompt в ChatGPT:
👉 Give me the 80/20 of [тема]
Тема може бути будь-яка: штучний інтелект, маркетинг, правопис, створення Telegram‑ботів — що тобі актуально.
Модель видасть тільки найважливіше: 20% того, що дає 80% результату.
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Прочитай відповідь
3️⃣ Запитай: “Поясни пункт 2 детальніше” — і копай глибше
🧪 Приклад:
👨🏫 Завдання:
Використовуй цей prompt щодня протягом тижня — на різні теми.
Ти здивуєшся, скільки всього зможеш зрозуміти значно швидше.
🔔 ПІДПИСАТИСЯ
🎯 Хочеш швидко розібратись у складній темі? Спробуй цей prompt в ChatGPT:
👉 Give me the 80/20 of [тема]
Тема може бути будь-яка: штучний інтелект, маркетинг, правопис, створення Telegram‑ботів — що тобі актуально.
Модель видасть тільки найважливіше: 20% того, що дає 80% результату.
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Прочитай відповідь
3️⃣ Запитай: “Поясни пункт 2 детальніше” — і копай глибше
🧪 Приклад:
Give me the 80/20 of розумінні психології Юнга Give me the 80/20 of вживанні Present Perfect в англійській👨🏫 Завдання:
Використовуй цей prompt щодня протягом тижня — на різні теми.
Ти здивуєшся, скільки всього зможеш зрозуміти значно швидше.
🔔 ПІДПИСАТИСЯ
❤7👍3👏3
🧮 Що таке токени — і чому це важливо?
У попередніх постах ми вже детально розібрали моделі від OpenAI і важливість промптингу — як правильно формулювати запити, щоб отримати найкращий результат у роботі з текстом, таблицями, кодом чи PDF.
Однак для якісного й ефективного використання LLM‑моделей є ще одна критично важлива характеристика, яку обов’язково потрібно враховувати — це обʼєм контексту.
Ти, мабуть, бачив у характеристиках моделей фрази на кшталт “контекст 128 000 токенів” — але що це означає на практиці? Як це впливає на твої запити, файли й результат?
Розбираємося просто 👇
🔹 1 токен ≈ ¾ слова
Тобто:
▫️ “ChatGPT — це цікаво” → ≈ 4 токени
▫️ Один абзац тексту — ≈ 20–40 токенів
▫️ Сторінка A4 — ≈ 500–600 токенів
🔹 GPT‑4o, o3, o4‑mini — до 128 000 токенів
🔹 GPT‑4.1, mini, nano — до 1 000 000 токенів
🧠 Що це означає?
Чим більший контекст — тим більше інформації модель може «тримати в голові» одночасно: цілу книжку, технічний мануал або десятки сторінок з аналітикою.
Коли це корисно?
📄 Ти імпортуєш середній документ (до 100 сторінок, ~50–60 тис. токенів)
📘 Приклад:
У тебе технічна документація чи юридичний документ на 80 сторінок (PDF), і потрібно:
👉 «Поясни, як працює розділ авторизації»
👉 «Знайди конфлікти між розділом 3 і 7»
👉 «Витягни всі умови щодо неустойки й штрафів»
👉 «Які пункти можуть бути суперечливими для другої сторони?»
📌 Вистачає GPT‑4o (до 128k токенів)
🔧 Можна обробити документ прямо в ChatGPT без API
📄 Великий документ або база знань (200–400 сторінок, >150 тис. токенів)
📘 Приклад:
Є методичка, мануал або повна продуктова база на 300+ сторінок.
→ Потрібно витягти всі процеси, повʼязані з техпідтримкою, з усіх розділів.
📌 Тут GPT‑4o не впорається (перевищено 128k)
✅ Використовуй GPT‑4.1 mini або nano через API — вони «бачать» до 1 млн токенів
📊 Велика таблиця (200–500 тис. рядків)
📘 Приклад:
Завантажив лог-файл у CSV з 450 тис. рядків. Хочеш:
👉 «Знайди помилки, які повторювались ночами у вихідні»
👉 «Знайди IP-адреси, що викликали аномальну активність»
📌 GPT‑4o — не вистачить контексту
✅ GPT‑4.1 mini (API) або o4-mini з розбиттям таблиці на блоки
Порада:
▪️ Якщо файл короткий → GPT‑4o
▪️ Якщо файл великий → GPT‑4.1 mini або nano
✍️ Хочеш гайд по токенах у prompt-інженерії чи для API? Напиши “токени!” у коментарях 👇
🔔 ПІДПИСАТИСЯ
👍10🔥3❤1
👋 Вітаю, друзі!
Щиро дякую за вашу активність у коментарях та реакціях 💬🔥
Багато хто з вас просив гайди:
— як працювати з mini-моделями через API
— як ефективно використовувати токени у prompt-інженерії
🛠 Я обов’язково все підготую — і ви отримаєте покрокові інструкції.
Але оскільки у вас різний рівень підготовки, щоб ми всі були на одній хвилі, я спершу розповім про інші важливі концепції, які допоможуть краще зрозуміти, як працюють сучасні LLM.
💡 Наприклад:
— чим відрізняється “памʼять” моделі від її “мислення”
— як довжина промпта впливає на якість відповіді
— і чому деякі запити працюють краще через 3 кроки, ніж за один
📚 Усе це — фундамент, на якому базується якісний prompt engineering.
Про це й поговоримо у наступних постах 👇
💬 Ще раз дякую за ваші цікаві запитання!
Якщо хочете більше корисного — ставте реакції й пишіть у коментарях, що саме для вас актуально. Це допомагає мені робити канал ціннішим саме для вас ❤️
👍16
🧠 Довжина контексту ≠ Глибина мислення
Багато хто думає:
“У цієї моделі 1 мільйон токенів — отже, вона розумніша”.
❌ Насправді це не так.
Давайте розберемось 👇
🔸 Довжина контексту або context window — це обсяг інформації, яку модель може “тримати в памʼяті” під час роботи з вашим запитом.
▫️ GPT‑4o: до 128 000 токенів
▫️ GPT‑4.1 mini: до 1 000 000 токенів
📌 Якщо ваш prompt або документ перевищує цей ліміт, модель починає “забувати” початок або просто ігнорувати частину даних — і це може критично вплинути на відповідь.
🔸 Глибина мислення — це наскільки добре модель вміє аналізувати, робити логічні висновки, порівнювати та узагальнювати.
🧪 Приклад:
📄 Ви даєте PDF на 30 сторінок — це ≈ 25 000 токенів.
Обидві моделі справляються з обсягом.
🔹 Але GPT‑4o краще побачить звʼязки між розділами, графіками, коментарями.
🔹 А mini — просто «запамʼятає» більше, але не факт, що зробить правильні висновки.
Запамʼятай:
🔸 Контекст — це памʼять
🔸 Мислення — це здатність до міркування
І це не одне й те саме.
✅ Став 👍 якщо було корисно
🔔 ПІДПИСАТИСЯ
1👍14❤2🔥2
🚀 OpenAI виклала у відкритий доступ свої перші великі моделі!
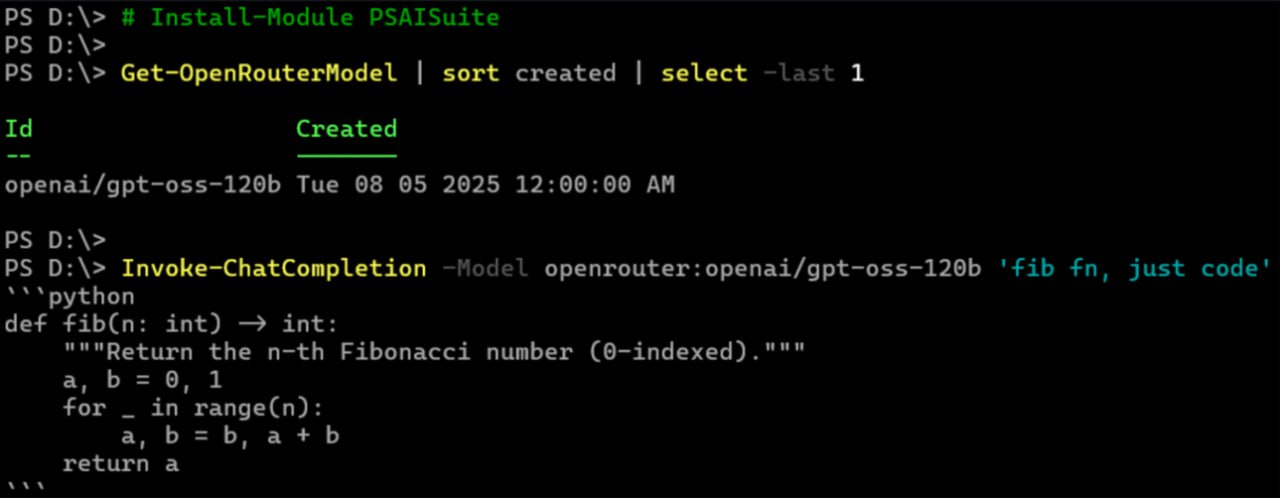
Так, це не жарт — gpt-oss-120b і gpt-oss-20b уже доступні з відкритими вагами 💥
🔹 120B — надпотужна, вже доступна через OpenRouter
🔹 20B — можна запускати локально, навіть на MacBook Pro чи RTX 3090ti
🧪 Я вже скачав і провів кілька експериментів із gpt-oss-120b — результати вражають, хоча повну картину покажуть незалежні бенчмарки.
📦 Завантажити моделі:
🔗 gpt-oss-20b (HuggingFace) — для локального запуску (через Ollama / LM Studio / llama.cpp)
🔗 gpt-oss-120b (HuggingFace) — для досліджень і API через OpenRouter
🧠 Важливий контекст:
Це не GPT-5 і не «нова ера інтелекту». Це швидше, доступніше і контрольоване.
LLM-потенціал вже наближається до межі — просто тепер він у твоїх руках.
🔥 Чому це стратегічно важливо?
✅ Зміцнення open-source-екосистеми
✅ Атака на BigTech-монополії
✅ Перехід OpenAI у консалтингову AI-гру: модель — безкоштовно, інтеграція — за гроші
🔎 Хто вже тестував 20B? Чи хоче? Якi враження?
🔔 ПІДПИСАТИСЯ
👍11❤2👏1
🔓🔑 Кому реально корисні open-weight моделі типу gpt-oss-20b/120b?
Пiсля того як OpenAI відкрила ваги своїх потужних моделей — тепер кожен може запускати їх локально. Але хто реально з цього виграє?
🔸 Дослідники
Можна безкоштовно експериментувати з LLM без API-лімітів.
✅ Запускаєш на власному GPU або в хмарі
✅ Жодних ліцензій чи NDA
✅ Повна свобода модифікацій
➡️ Підходить для університетів, AI-лабораторій, ентузіастів
🔸 Малий бізнес
Тепер AI доступний навіть кав’ярням, спортзалам і школам ☕️💪
✅ Можна розгорнути на комп’ютері з RTX 3090/4090 або орендувати хмару
✅ Жодних щомісячних оплат OpenAI
✅ Дані залишаються у вас
➡️ Приклади: власний бот у Telegram, голосовий помічник, чат із клієнтами
🔸 Розробники в країнах з обмеженим доступом
У деяких регіонах ChatGPT/API офіційно заблоковані.
✅ Моделі працюють офлайн
✅ Без VPN, без обмежень, без реєстрацій
➡️ Це відкриває можливості для локального ринку та освіти
🔹 Висока якість — як у o4-mini
🔹 Локальний запуск — навіть без хмари
🔹 Безкоштовні ваги — без API та ліцензійних зборів
➡️ На форумах вже пишуть:
«Тепер я можу впровадити розумні, безпечні й доступні рішення у свій продукт і допомогти підприємцям економити кошти та ухвалювати кращі рішення»
Це не просто модель — це новий рівень доступності штучного інтелекту.
🔔 ПІДПИСАТИСЯ
👍16
🧠 Що таке “інтелект” LLM моделі?
У попередньому пості я використав фразу:
«Мислення — це здатність до міркування».
І, можливо, у тебе виникло цілком логічне запитання:
👉 Якщо памʼять моделі можна виміряти в токенах — то як вимірюється інтелект?
🔸 Памʼять — це кількість токенів, які модель може “тримати в голові” (сontext window) в одному запиті.
🔸 Мислення — це здатність моделі логічно міркувати, будувати ланцюжки, узагальнювати та робити висновки.
🔬 У світі AI це називають reasoning — і перевіряють цю здатнисть через спеціальні тести: 👇
▫️ GSM8K — шкільна математика (6–8 клас)
▫️ Big-Bench — логічні задачі з підказками
▫️ HumanEval — написання коду
▫️ MMLU — тести з 57 дисциплін (аналог IQ для LLM)
📊 Інтелект у цифрах:
Чим вищий відсоток — тим глибше мислення, кращий логічний ланцюжок і точніші відповіді.
💡 Цікаво, що GPT‑4o формально лідирує у тестах типу MMLU та GSM8K,
але…
🤔 На практиці:
Багато користувачів помічають:
👉 o3
▫️ краще міркує поетапно
▫️ рідше “фантазує”
▫️ не спрощує складну логіку
▫️ частіше дає чітке пояснення крок за кроком
Це як з людьми: один студент може добре скласти тест, а інший — справді глибоко розуміє суть.
✅ Став 👍 якщо було корисно
🔔 ПІДПИСАТИСЯ
У попередньому пості я використав фразу:
«Мислення — це здатність до міркування».
І, можливо, у тебе виникло цілком логічне запитання:
👉 Якщо памʼять моделі можна виміряти в токенах — то як вимірюється інтелект?
🔸 Памʼять — це кількість токенів, які модель може “тримати в голові” (сontext window) в одному запиті.
🔸 Мислення — це здатність моделі логічно міркувати, будувати ланцюжки, узагальнювати та робити висновки.
🔬 У світі AI це називають reasoning — і перевіряють цю здатнисть через спеціальні тести: 👇
▫️ GSM8K — шкільна математика (6–8 клас)
▫️ Big-Bench — логічні задачі з підказками
▫️ HumanEval — написання коду
▫️ MMLU — тести з 57 дисциплін (аналог IQ для LLM)
📊 Інтелект у цифрах:
GPT‑3.5        — MMLU: ~70%   | GSM8K: ~57%
GPT‑4o         — MMLU: ~88%   | GSM8K: ~93%
GPT‑4.1 mini   — MMLU: ~76%   | GSM8K: ~68%
GPT‑o3         — MMLU: ~86%   | GSM8K: ~89%
Чим вищий відсоток — тим глибше мислення, кращий логічний ланцюжок і точніші відповіді.
💡 Цікаво, що GPT‑4o формально лідирує у тестах типу MMLU та GSM8K,
але…
🤔 На практиці:
Багато користувачів помічають:
👉 o3
▫️ краще міркує поетапно
▫️ рідше “фантазує”
▫️ не спрощує складну логіку
▫️ частіше дає чітке пояснення крок за кроком
Це як з людьми: один студент може добре скласти тест, а інший — справді глибоко розуміє суть.
✅ Став 👍 якщо було корисно
🔔 ПІДПИСАТИСЯ
1👍24
🚀 GPT-5: свіжий реліз і головне, що потрібно знати
Вчора OpenAI офіційно представила GPT-5. Це справжній прорив, і тепер саме ця модель стала дефолтною у ChatGPT.
Хто дивився презентацію онлайн? 💬
Усі канали вже наввипередки розповідають, яка вона розумна, швидка і геніальна. Я не буду повторювати те, що ви й так прочитаєте в новинах. Натомість дам коротку вичавку з офіційної документації, яку, впевнений, більшість навіть не відкриє.
Джерело: офіційний гайд OpenAI
📌 Два режими роботи
🔹 GPT-5 Chat — швидкий режим для повсякденних завдань.
🔹 GPT-5 Thinking — «довге мислення» для складних запитів (код, наука, аналіз даних). Для тих, хто звик працювати з o3 — відчуття буде знайоме 😉.
📌 Ліміти за тарифами
Free
▪️ 10 повідомлень / 5 годин у Chat
▪️ 1 Thinking-повідомлення на день
▪️ Після ліміту — перехід на mini-модель
Plus
▪️ 80 повідомлень / 3 години у Chat
▪️ 200 Thinking-повідомлень на тиждень при ручному виборі — тепер доведеться осмислено формулювати запити, а не питати все підряд 😏
▪️ Автоперемикання у Thinking не витрачає тижневу квоту
Team
▪️ Ліміти як у Plus для Thinking
▪️ Автоперемикання не витрачає квоту
Pro
▪️ GPT-5 Thinking Pro — ще глибше й повільніше мислення
▪️ Немає тижневого ліміту (але діють антиаб’юз-обмеження)
📌 Важливий момент
Усі моделі, які ми нещодавно розбирали у постах — GPT-4o, GPT-4.1, GPT-4.5, o3 та інші — більше недоступні. Їх прибрали, і тепер GPT-5 став стандартом 🥴.
Це ще раз показує, наскільки швидко розвивається AI-сфера і як швидко застаріває інформація.
⚠️ ВАЖЛИВО: ліміти на Thinking враховуються тільки якщо ви вручну обираєте цю модель. Якщо GPT-5 сам вирішить, що йому треба «подумати довше» — це не йде у ліміт.
💡 Лайфхак: якщо перед запитом писати щось на кшталт «Подумай дуже добре й видай правильну відповідь» або навіть англійське «Think harder» — моделька майже завжди перемикається у Thinking автоматично, і це не витрачає тижневу квоту 😉.
А ви вже встигли протестувати GPT-5? Які враження?
Я вважаю, що лише за цей лайфхак цей пост заслуговує на 👍 .
Пишіть у коментарях 👇, поділимося досвідом.
🔔 ПІДПИСАТИСЯ
#ChatGPT #GPT5
👍22
💥 Учора весь інтернет гудів про вихід GPT-5.
Зізнаюсь — я теж чекав на вау. Але після дня тестів у різних конфігураціях враження змішані: пише не так яскраво, як GPT-4.5, і працює не завжди краще за о3. Схоже, спроба зібрати в одну модель усі завдання, які раніше тягнули окремі моделі, вийшла… так собі.
Не дивно, що на Reddit хвиля критики. Сам Альтман визнав, що очікували «помірний негатив», але не настільки, і пообіцяв швидкі покращення. Хто зна, можливо, навіть повернуть GPT-4о, бо запити від користувачів сипляться.
І тут варто згадати не лише бізнес, а й кращі практики управління проєктами: не можна відмовлятися від того, що працює, на користь неперевіреного. Якби вони залишили старі моделі й додали нову — користувачі поступово перейшли б на «п’ятірку», а OpenAI мала б час її підтягнути. Але вибрали хайп, і в результаті багато хто вже думає відписатися від платної підписки.
🔔 ПІДПИСАТИСЯ
👍12👌1
🇺🇸 vs 🇨🇳 Чому OpenAI відкрила свої моделі? І чи варто це вважати сигналом змін у геополітичному ландшафті?
Ситуація з нещодавнім відкриттям моделей gpt-oss-20b та gpt-oss-120b від OpenAI змусила мене замислитися не лише як інженера, а і як громадянина цифрової епохи — я вже писав про це тут.
Вирішив трохи розбавити освітній контент аналітикою — спробуємо поглянути на ситуацію ширше 👇
Це виглядає як красива історія: підтримка спільноти, відкритості, свободи знань. Але я не міг не спитати себе: чи справді великі гравці сьогодні думають про людей?
Хочеться вірити, що так. Але якщо чесно — глибокі альтруїстичні мотиви рідко рухають компаніями такого масштабу.
Читаючи аналітику, лідерборди моделей і спостерігаючи за тенденціями останніх місяців, ловлю себе на думці: Китай вже не просто наздоганяє — він реально поруч.
Причому не за рахунок кількох проривів, а завдяки цілісному підходу: відкритим моделям, масштабному виробництву чипів, агресивній конкуренції.
📊 На LLM-лідербордах видно:
▪️ У сегменті пропрієтарних моделей досі домінують США — GPT‑4o, Claude 4 Opus, Gemini 2.5 Pro.
▪️ Але у відкритому сегменті вже лідирує Китай: DeepSeek, Qwen3, Kimi, GLM 4.5 — і багато з них обганяють навіть Llama 4 та Gemma 2.
Чому так?
У США досі домінує підхід «секретність = перевага». Компанії скуповують таланти, захищають свої моделі як комерційну таємницю, вкладаються у власні “секретні інгредієнти”. Обмін знаннями — повільний, контрольований, дорогий.
У Китаї — протилежна стратегія: публікація коду, змагання на відкритих платформах, постійна боротьба за клієнтів, таланти й увагу. Це не просто хаос — це механізм жорсткого добору, де виживає не найбільший, а найспритніший і найадаптивніший.
🔎 У цьому контексті дуже показовим є AI Action Plan, нещодавно опублікований Білим домом.
— AI Action Plan, 2025
Інакше кажучи: відкритість — це вже не лише технологічне благо, а питання стратегії національного масштабу.
📌 Висновок:
Відкриття моделей OpenAI — це не просто жест. Це відповідь на прорив Китаю і реакція на новий курс США щодо open-source.
OpenAI зробила хід на випередження, щоб перехопити ініціативу в боротьбі за відкритий сегмент.
Якщо Google, Meta, Anthropic теж відкриють свої моделі — це стане підтвердженням: AI-стратегії більше не формуються лише в офісах компаній — тепер на них впливає і геополітика, і державна політика.
🔽 Якщо цей аналітичний формат вам сподобався — дайте знати пальцем вгору 👍. Можливо, варто час від часу робити не лише освітні, а й геополітичні дописи.
🔔 ПІДПИСАТИСЯ
#AIГеополітика #AIАналітика
Ситуація з нещодавнім відкриттям моделей gpt-oss-20b та gpt-oss-120b від OpenAI змусила мене замислитися не лише як інженера, а і як громадянина цифрової епохи — я вже писав про це тут.
Вирішив трохи розбавити освітній контент аналітикою — спробуємо поглянути на ситуацію ширше 👇
Це виглядає як красива історія: підтримка спільноти, відкритості, свободи знань. Але я не міг не спитати себе: чи справді великі гравці сьогодні думають про людей?
Хочеться вірити, що так. Але якщо чесно — глибокі альтруїстичні мотиви рідко рухають компаніями такого масштабу.
Читаючи аналітику, лідерборди моделей і спостерігаючи за тенденціями останніх місяців, ловлю себе на думці: Китай вже не просто наздоганяє — він реально поруч.
Причому не за рахунок кількох проривів, а завдяки цілісному підходу: відкритим моделям, масштабному виробництву чипів, агресивній конкуренції.
📊 На LLM-лідербордах видно:
▪️ У сегменті пропрієтарних моделей досі домінують США — GPT‑4o, Claude 4 Opus, Gemini 2.5 Pro.
▪️ Але у відкритому сегменті вже лідирує Китай: DeepSeek, Qwen3, Kimi, GLM 4.5 — і багато з них обганяють навіть Llama 4 та Gemma 2.
Чому так?
У США досі домінує підхід «секретність = перевага». Компанії скуповують таланти, захищають свої моделі як комерційну таємницю, вкладаються у власні “секретні інгредієнти”. Обмін знаннями — повільний, контрольований, дорогий.
У Китаї — протилежна стратегія: публікація коду, змагання на відкритих платформах, постійна боротьба за клієнтів, таланти й увагу. Це не просто хаос — це механізм жорсткого добору, де виживає не найбільший, а найспритніший і найадаптивніший.
🔎 У цьому контексті дуже показовим є AI Action Plan, нещодавно опублікований Білим домом.
“Open-source and open-weight models could become global standards in some areas of business and in academic research worldwide. For that reason, they also have geostrategic value.”
— AI Action Plan, 2025
Інакше кажучи: відкритість — це вже не лише технологічне благо, а питання стратегії національного масштабу.
📌 Висновок:
Відкриття моделей OpenAI — це не просто жест. Це відповідь на прорив Китаю і реакція на новий курс США щодо open-source.
OpenAI зробила хід на випередження, щоб перехопити ініціативу в боротьбі за відкритий сегмент.
Якщо Google, Meta, Anthropic теж відкриють свої моделі — це стане підтвердженням: AI-стратегії більше не формуються лише в офісах компаній — тепер на них впливає і геополітика, і державна політика.
🔽 Якщо цей аналітичний формат вам сподобався — дайте знати пальцем вгору 👍. Можливо, варто час від часу робити не лише освітні, а й геополітичні дописи.
🔔 ПІДПИСАТИСЯ
#AIГеополітика #AIАналітика
1👍26👎1🔥1
📌 Prompt тижня: Step-by-step
🎯Хочеш, щоб ChatGPT перетворював складні теми на простий план дій?
Використовуй цей prompt:
👉 Explain this step-by-step so a beginner can follow it: [тема]
Тема може бути українською чи іншою: бізнес-процеси, уроки, технічні навички.
💡 Що робить цей prompt: Модель розбиває складну задачу на зрозумілі кроки з поясненнями та прикладами, щоб ти міг діяти без плутанини.
🗣 Чому краще писати англійською?
• ChatGPT “тренувався” переважно на англомовних даних
• Відповіді часто виходять чіткіші та структурованіші
• Потім можна попросити: Translate to Ukrainian — і отримати якісний переклад
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Дочекайся списку кроків
3️⃣ Запитай: “Додай чеклист і типові помилки” — щоб уникнути підводних каменів
🧪 Приклади:
👨🏫 Завдання:
Використовуй цей prompt щодня протягом тижня — на теми, які тебе цікавлять.
Результат: більше структурованих дій, менше хаосу.
💬 Напиши в коментарях, яку тему ти спробуєш цього тижня.
Став 👍 Якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
🎯Хочеш, щоб ChatGPT перетворював складні теми на простий план дій?
Використовуй цей prompt:
👉 Explain this step-by-step so a beginner can follow it: [тема]
Тема може бути українською чи іншою: бізнес-процеси, уроки, технічні навички.
💡 Що робить цей prompt: Модель розбиває складну задачу на зрозумілі кроки з поясненнями та прикладами, щоб ти міг діяти без плутанини.
🗣 Чому краще писати англійською?
• ChatGPT “тренувався” переважно на англомовних даних
• Відповіді часто виходять чіткіші та структурованіші
• Потім можна попросити: Translate to Ukrainian — і отримати якісний переклад
📎 Що зробити:
1️⃣ Напиши цей запит у чат
2️⃣ Дочекайся списку кроків
3️⃣ Запитай: “Додай чеклист і типові помилки” — щоб уникнути підводних каменів
🧪 Приклади:
Explain this step-by-step so a beginner can follow it: Як інтегрувати штучний інтелект у навчальний процес Explain this step-by-step so a beginner can follow it: підготовка бізнес-плану для інвестора Explain this step-by-step so a beginner can follow it: налаштування системи контролю версій для інженерного проекту 👨🏫 Завдання:
Використовуй цей prompt щодня протягом тижня — на теми, які тебе цікавлять.
Результат: більше структурованих дій, менше хаосу.
💬 Напиши в коментарях, яку тему ти спробуєш цього тижня.
Став 👍 Якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
5👍19👏1
📘 Prompt Programming: як студенти вчаться програмувати через діалог із AI
Збираючи для вас корисну інформацію про промптінг і роботу з AI, я натрапив на цікаве нове дослідження, опубліковане на ITiCSE 2025. У статті описано дослiдження через платформу Prompt Programming, яка вчить студентів не просто писати код — а співпрацювати з генеративними AI-моделями через діалог.
🧠 Проблема: як навчати програмуванню в епоху AI?
Сьогодні студенти все частіше звертаються до ChatGPT, Copilot та інших LLM-асистентів, щоби швидше писати код. Але:
🔹 Вони не мають формального навчання, як правильно з ними працювати
🔹 Не вміють формулювати ефективні запити (промпти), щоби отримати потрібне рішення
🔹 Часто довіряють результатам “як є”, не перевіряючи, чи справді код коректний
🔹 Не розвивають важливі навички: читання, перевірки, адаптації та редагування коду
👨🏫 Раніше завдання курсу з програмування — навчити писати код з нуля.
Тепер — навчити співпрацювати з AI: ставити правильні запитання, перевіряти результати, мислити критично.
🔍 Що зробили дослідники?
▪️ Створили платформу Prompt Programming, яка вчить студентів взаємодіяти з LLM
▪️ Додали підтримку мультикрокових діалогів, де студент поступово уточнює запит
▪️ Реалізували задачі з кількома пов’язаними функціями — як у реальному коді
▪️ Дозволили вибірково запускати код, щоби перевірити його коректність
🧪 У дослідженні взяли участь 900+ студентів, які проходили курс C-програмування. Автори аналізували:
— як студенти формулюють запити
— як будують рішення через кілька кроків
— коли і чому вирішують запустити код
— як змінюється стратегія залежно від складності задачі
📈 Що виявили:
▪️ Студенти активно використовували діалог, а не одноразові запити
▪️ У складніших задачах довші діалоги та більше уточнень
▪️ Запускали код вибірково — частіше тоді, коли вважали його правильним
▪️ Більшість дійшла висновку, що комбінація промптів і ручного коду — найкраща тактика
🌍 Навіщо це все?
Це не просто тренажер. Це — навчальне середовище, яке формує сучасні навички:
мислити через AI, перевіряти, уточнювати, співпрацювати.
📎 Платформа Prompt Programming доступна публічно разом з навчальними задачами.
🔗 Назва статті:
Prompt Programming: A Platform for Dialogue-based Computational Problem Solving with Generative AI Models
ITiCSE 2025
Читати повний текст (PDF)
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
1👍15👏1
📚 Як ефективно писати промпти для AI
У минулому пості я зробив огляд цікавої наукової статті з конференції ITiCSE 2025, де дослідники представили платформу Prompt Programming — середовище, що вчить студентів взаємодіяти з AI у вигляді діалогу.
А ось ще кілька корисних прийомів із цього дослідження, які легко застосувати у щоденній роботі з LLM (не тільки в програмуванні) 👇
🔁 Ітеративне уточнення промптів
Замість одного великого запиту — кілька уточнюючих. Це дозволяє покращити якість результату й краще зрозуміти логіку моделі.
🧩 Модульне мислення
Розбивай задачу на частини. Запитуй спочатку структуру, потім окремі елементи — це спрощує перевірку й адаптацію.
🧠 Уважна перевірка перед запуском
Не довіряй відповіді “наосліп”. Студенти запускали лише той код, який виглядав правильним — і це гарна стратегія для будь-яких AI-відповідей.
⚖️ Поєднання промптінгу з ручною роботою
Найкраще працює гібрид: частину — формулюєш словами, частину — допрацьовуєш сам. Це дає контроль і точність.
💬 Кілька повідомлень — краще, ніж одне
Дослідження показало: багатокрокові діалоги з AI дають кращі результати, ніж один «всеохопний» запит.
🔗 Стаття повністю (PDF):
Prompt Programming на arXiv
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍16
📊 Як побудова промпту впливає на якість коду?
Копаючи тему промптинга глибше, натрапив ще на дуже цікаве дослідження, яким хочу поділитися з вами.
Якщо є час і бажання — ознайомтесь з оригіналом.
А якщо ні — тримайте коротку й корисну вичимку 👇
🧪 Що досліджували?
▪️ Як саме структура запиту до LLM (GPT-4o, LLaMA 3, Mistral) впливає на:
— ✔️ правильність коду
— 🤖 схожість із людським рішенням
— 🧼 стиль і якість (code smells, складність)
▪️ Протестували 7 000+ промптів із 5 техніками:
Few-shot — приклади у запиті
Chain-of-Thought — “думай уголос”
Function Signature — тчітко вказати типи параметрів
Persona — надати LLM роль (наприклад: "ти досвідчений розробник")
Packages — явно вказати, які імпортувати
📈 Що виявили?
✅ Найефективніша техніка — function signature. Вона різко покращує правильність.
➕ Few-shot також корисна, особливо у парі зі структурою.
⚠️ Техніки на кшталт persona і CoT самі по собі не гарантують якість — іноді навіть погіршують точність.
🧠 Chain-of-Thought і persona зменшують code smells, але не обов’язково дають правильну відповідь.
📉 Few-shot може зменшити схожість із людським кодом — хоча іноді й покращує результат.
📌 Що це означає для нас?
На основі цього дослідження ми можемо суттєво покращити свої запити до AI, якщо:
🔹 Чітко описуємо, що саме хочемо (структура, формат, очікуваний результат)
🔹 Додаємо приклади або вводимо модель у контекст
🔹 Вказуємо обмеження — що можна, а що не потрібно
🔹 А вже потім — додаємо стиль, роль ("ти експерт", "пиши як маркетолог", тощо)
📎 Оригінал дослідження (PDF):
arXiv: The Impact of Prompt Programming on Function-Level Code Generation
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍8🔥5
🧠 GPT-5 уже тут. Але старт — неідеальний
Минулого тижня вийшов довгоочікуваний GPT‑5, про який я вже писав у попередньому пості. Але реліз виявився не таким тріумфальним, як очікувалось: спільнота вибухнула обуренням, дехто навіть захотів скасувати підписку.
Сем Альтман та команда OpenAI протягом тижня екстрено виправляли помилки, і були змушені повернути GPT‑4o, o3 та інші моделі назад у ChatGPT. Щоправда, o3 тепер доступна тільки за Pro-підпискою за $200/міс.
🎯 Тож давай підсумуємо — що нового та які реальні результати ми вже маємо.
💡 Що нового в GPT‑5:
• Це не просто модель, а сімейство систем: GPT‑5, GPT‑5 Mini, Nano та Pro
• Кожна з них має різну продуктивність, швидкість та глибину “мислення”
• Додано роутер, який автоматично визначає, яку модель використати — на основі складності запиту, наявності інструментів і навіть фраз типу “think step-by-step”
• Усі моделі в інтерфейсі ChatGPT були замінені на GPT‑5 без попередження
⚠️ Але роутер зламався прямо “на старті”, і через це:
• Користувачі бачили повільні або поверхневі відповіді
• Були випадки автоматичного перемикання на Mini/Nano без пояснення
• Це змусило OpenAI екстрено повернути доступ до старих моделей
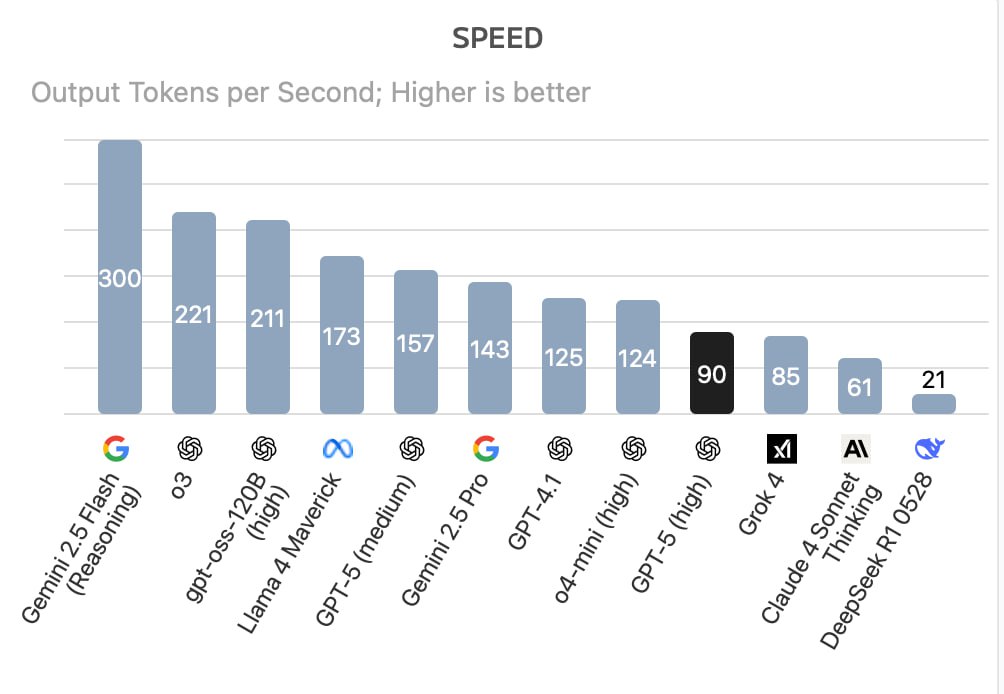
📊 Продуктивність на бенчмарках:
• SWE-Bench (software engineering tasks): GPT‑5 — 74.9% vs Claude Opus — 74.5%
• AIME 2025 (математичні задачі): GPT‑5 (high reasoning) — 94.6% vs o3 — 88.9%
• EQ-Bench Creative Writing: GPT‑5 — 90.3 vs o3 — 87.6 vs Gemini‑2.5‑Pro — 86.0
• Індекс Intelligence від Artificial Analysis: GPT‑5 (medium/high reasoning) — №1 серед усіх моделей
❗️ Але на деяких тестах GPT‑5 виступила гірше:
• ARC-AGI‑1/2 (абстрактне мислення, візуальні задачі): GPT‑5 — 65.7% / 9.9%
Grok 4 Thinking — 66.7% / 16.0%
🔗 GPT‑5 перевершує попередні моделі на більшості тестів
🧰 Можливості для розробників:
• 4 рівні міркування (від “без міркувань” до “глибоке міркування”)
• 3 рівні багатослівності (output length)
• Інструменти можна викликати через JSON або natural language
• Можна явно вказати, чи використовувати reasoning / non-reasoning модель
• Підсумок reasoning‑токенів після відповіді
🔗 Докладно про нові параметри та функції GPT‑5
🎯 Висновок:
GPT‑5 — це вже не просто “модель”, а ціла адаптивна система з можливістю змінювати глибину мислення, розмір відповіді та логіку обробки запиту. Для новачків це виглядає зручно. Але питання до досвідчених користувачів:
чи готові ви віддати контроль "роутеру" — і не знати, яка саме модель відповідає?
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍7🔥3👻1
🇮🇳 Індія створює власні LLM — із тисячами топових відеокарт NVIDIA
Для того щоб трохи розбавити потужні теоретичні пости, від яких ви могли вже втомитись — розбавлю трошки цікавими новинами 👇
У 2024 році американські AI-стартапи залучили $97B, європейські — $51B. А індійські — лише $780M.
Попри обмежені ресурси, Індія запускає масштабну програму розвитку власних AI-моделей.
🔸 У січні уряд Індії оголосив збір пропозицій на розробку національних LLM — буквально через 10 днів після релізу китайського DeepSeek‑R1.
До речі, і ми не відстаємо: в Україні Київстар, Мінцифра та WINWIN AI Centre of Excellence вже працюють над власною національною LLM, а її запуск планується до грудня 2025 року. [читати детальніше]
🔸 Для цього Індія зарезервувала 19 000 вiдеокарт (GPU), з них 13 000 — NVIDIA H100 — одні з найпотужніших відеокарт у світі, які використовують для навчання великих моделей.
🔸 У квітні уряд Індії обрав шість команд для створення національних мовних моделей. Серед них:
SSarvam AI працює над потужною моделлю на 70 мільярдів параметрів, яка розуміє кілька мов і вміє працювати з голосом — що особливо важливо для людей, які не читають чи не пишуть.
Soket AI Labs створює ще більшу — на 120 мільярдів параметрів.
CoRover вже представив першу версію — BharatGPT (3.2B), яка підтримує голосовий інтерфейс 12 мовами. Також вийшла компактна версія — BharatGPT Mini (534M), яка працює навіть на слабких пристроях.
📏 Для порівняння:
GPT‑3 від OpenAI — 175B параметрів
GPT‑4 (за чутками) — понад 1 трильйон параметрів (точна кількість не розкривається)
Grok (від X / Elon Musk) — ~314B у версії Grok-1.5
Claude 3 Opus (Anthropic) — приблизно 200B
LLaMA 2 (Meta) — випускалась у варіантах 7B, 13B, 70B
🔍 Тобто індійські моделі вже входять у той самий "ваговий клас", що й продукти глобальних AI-гігантів.
⚙️ Виклики:
Понад 120 мов і 19 500 діалектів
У багатьох мов немає чіткого поділу між словами — важко токенізувати
Нестача якісних текстових корпусів
Суттєво менше фінансування, ніж у США чи Китаї
💡 Але тут важлива не лише технологія. А те, що країна створює свої власні голоси, культурні коди й світогляд в архітектурі моделей.
📌 Джерело: MIT Technology Review
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍12
🌍 Чому країни масово створюють свої AI-моделі?
(Як продовження попереднього поста 👉 про Індію)
У минулому дописі я писав, як Індія запускає власну велику мовну модель (LLM) — і чому це важливо для неї.
Але це — не одиничний кейс.
Сьогодні ми бачимо глобальний тренд: уряди по всьому світу інвестують у розробку власних AI-моделей.
Від ОАЕ до Франції, від Японії до України — країни створюють моделі, які відображають їхню мову, культуру й інтереси.
🔍 Постає логічне питання: навіщо це все?
Чому не користуватися просто GPT, Claude або Grok, як ми користуємось, скажімо, браузером Chrome чи пошуком Google?
Давайте розберемося 👇
🇨🇺 1. Культурна точність
Глобальні моделі навчені переважно на англомовних даних. Вони "думають" у межах західного контексту.
Поняття, гумор, соціальні ролі, навіть уявлення про добро і зло — усе це передається через фільтр іншої культури.
LLM легко відповідають на питання про Супермена чи Starbucks — але можуть не знати, що таке “Козацька Рада” або “вереснева хмаринка”.
📌 Проблеми з культурною неупередженістю:
Згідно з дослідженням CultureLLM, моделі LLM демонструють упередженість щодо культур із малою цифровою присутністю.
Під час навчання переважають англомовні дані, тому культури з “low-resource” мовами часто ігноруються або спрощуються.
🛡 2. Цифровий суверенітет
AI — це не просто технологія. Це майбутній мозок у системах оборони, освіти, медицини, фінансів.
“AI will become the central nervous system of digital government and economic systems.”
— Stanford HAI, 2024 AI Index
Якщо в тебе немає своєї моделі — у тебе немає контролю над тим, як і що вона “думає”.
Залежність від чужого AI = залежність від чужих цінностей, пріоритетів і обмежень.
📌 І це не лише слова. Цифровий суверенітет вже став офіційною стратегією багатьох держав:
▪️ Франція — “Souveraineté numérique”
▪️ Німеччина — GAIA-X
▪️ ОАЕ — Falcon AI під державним контролем
▪️ Китай — локальні моделі (Qwen, Yi) з відкритими вагами, але обов’язковим ліцензуванням
🟡 А що Україна?
У березні 2025 Київстар, Мінцифра та WINWIN AI Centre of Excellence підписали меморандум про розробку першої в Україні національної LLM.
[читати офіційний реліз]
🗣 3. Збереження мов і діалектів
Багато мов просто не представлені у світових моделях. Це означає — їх не “чують”, вони не мають впливу.
Національні LLM — це шанс дати цифрове життя рідній мові й уникнути зникнення.
В Індії понад 19 000 діалектів. В Україні — купа говорів і регіональних форм.
Без своїх моделей — вони зникнуть із цифрового простору.
📜 4. Право на власну етику й закон
Американські моделі відповідають американським законам. Китайські — китайським.
Тільки власна модель може працювати за твоїми правилами — у межах твоєї Конституції, твоєї системи освіти, твоєї моралі.
🤝 Висновок:
Власна LLM — це не розкіш і не забаганка. Це — цифрова незалежність.
Бо якщо твоєї моделі немає — твоєї культури немає в AI.
І тоді хтось інший напише твою історію замість тебе.
Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍19⚡3❤1🔥1
📌 Prompt тижня: I’m probably wrong, but … What do you think?
🎯 Хочеш, щоб ChatGPT не просто відповідав, а перевіряв твої ідеї на міцність?
Спробуй цей prompt:
👉 I’m probably wrong, but [твердження] — what do you think?
Тема може бути будь-яка: бізнес, освіта, технології, соціальні питання.
💡 Що робить цей prompt:
Модель починає мислити критично, знаходить слабкі місця та дає аргументи з різних боків — і «за», і «проти».
Це допомагає уникнути упереджень і прокачати власне мислення.
📎 Що зробити:
1️⃣ Сформулюй своє припущення у форматі “I’m probably wrong, but…”
2️⃣ Дочекайся відповіді з аргументами
3️⃣ Запитай: “Play devil’s advocate against your answer” — щоб отримати ще глибший аналіз
🧪 Приклади:
👨🏫 Завдання:
Спробуй цей prompt мінімум 3 рази цього тижня на різні теми.
Результат: більш критичне мислення і свіжі ідеї, які ти б сам не побачив.
💬 Напиши в коментарях, яке припущення ти перевіриш першим.
Став 👍 якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
🎯 Хочеш, щоб ChatGPT не просто відповідав, а перевіряв твої ідеї на міцність?
Спробуй цей prompt:
👉 I’m probably wrong, but [твердження] — what do you think?
Тема може бути будь-яка: бізнес, освіта, технології, соціальні питання.
💡 Що робить цей prompt:
Модель починає мислити критично, знаходить слабкі місця та дає аргументи з різних боків — і «за», і «проти».
Це допомагає уникнути упереджень і прокачати власне мислення.
📎 Що зробити:
1️⃣ Сформулюй своє припущення у форматі “I’m probably wrong, but…”
2️⃣ Дочекайся відповіді з аргументами
3️⃣ Запитай: “Play devil’s advocate against your answer” — щоб отримати ще глибший аналіз
🧪 Приклади:
I’m probably wrong, but дистанційна робота продуктивніша за офісну — what do you think? I’m probably wrong, but регулювання ШІ зупинить інновації — what do you think? I’m probably wrong, but YouTube програє TikTok у довгостроковій перспективі — what do you think? 👨🏫 Завдання:
Спробуй цей prompt мінімум 3 рази цього тижня на різні теми.
Результат: більш критичне мислення і свіжі ідеї, які ти б сам не побачив.
💬 Напиши в коментарях, яке припущення ти перевіриш першим.
Став 👍 якщо пост був корисним — щоб я бачив, що треба робити більше таких!
🔔 ПІДПИСАТИСЯ
5👍18🔥4
📌 Чому ваш запит до AI не працює?
У попередньому пості я робив огляд наукової статті про промптинг — дослідження проводили на прикладі програмування.
Але, незважаючи на технічну тематику, результати дослідження легко адаптувати під наші щоденні запити до AI — у навчанні, роботі, бізнесі чи творчості.
Ось 5 порад з цього дослідження, які допоможуть писати складні, але ефективні запити 👇
1️⃣ Структуруйте запит
Замість “Напиши мені текст” — краще сформулюйте чітко:
▪️ тему
▪️ стиль або тон
▪️ обсяг
▪️ приклад схожого формату
2️⃣ Формат і обмеження мають значення
Вкажіть, який результат хочете: список, таблицю, опис у 3 абзаци…
Також додайте, що не потрібно (наприклад, "без емодзі", "не згадуй ChatGPT").
3️⃣ Подавайте приклади
Один хороший приклад у промпті допомагає AI краще зрозуміти контекст і стиль. Це значно підвищує якість відповіді.
4️⃣ Не покладайтесь лише на “роль”
Фраза “уяви, що ти маркетолог / письменник / історик” корисна, але не замінює чітких інструкцій. Краще — роль + структура + приклад.
5️⃣ Не бійтеся писати довгі промпти
Складне завдання потребує деталізації. AI працює краще, коли точно знає, чого ви хочете.
💡 У дослідженні протестували 7 000+ варіантів запитів на GPT‑4o, LLaMA 3 і Mistral — і всі ці висновки засновані на фактах.
📎 Ознайомитись з повною статтею можна тут (PDF):
The Impact of Prompt Programming on Function-Level Code Generation
🔁 Зберігайте пост і експериментуйте — результат дійсно змінюється, коли змінюється запит.
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
Telegram
ProofOf{P}
📊 Як побудова промпту впливає на якість коду?
Копаючи тему промптинга глибше, натрапив ще на дуже цікаве дослідження, яким хочу поділитися з вами.
Якщо є час і бажання — ознайомтесь з оригіналом.
А якщо ні — тримайте коротку й корисну вичимку 👇
🧪 Що досліджували?…
Копаючи тему промптинга глибше, натрапив ще на дуже цікаве дослідження, яким хочу поділитися з вами.
Якщо є час і бажання — ознайомтесь з оригіналом.
А якщо ні — тримайте коротку й корисну вичимку 👇
🧪 Що досліджували?…
👍10👏5💯2
🎬 AI-згенероване відео — вже мейнстрім
Привіт, друзі!
Учора прочитав кілька новин про те, що зараз відбувається в AI, який працює з відео — і вирішив поділитися з вами найцікавішим.
Сьогодні інформація не надто складна (як це іноді буває у нас, коли ми глибоко занурюємось у технічні деталі 😅). Але буде цікаво всім, хто стежить за AI або просто хоче розуміти, як змінюється відеоіндустрія.
🔻 Отже, що нового?
▪️ Студія Dor Brothers із Берліна зняла вірусне відео The Drill (16+ млн переглядів), використовуючи лише AI.
▪️ Genre.ai зробила божевільну рекламу для Kalshi за $2K, згенерувавши понад 400 AI-кліпів — і відібравши з них лише 15 найкращих для фінального монтажу.
▪️ Netflix згенерувала сцену обвалу будівлі для серіалу The Eternaut за допомогою Runway — в 10 разів швидше й дешевше, ніж за класичною схемою.
🛠 Як це працює?
🔹 ChatGPT + Gemini → сценарії та шот-листи
🔹 Midjourney / DALL-E → картинки
🔹 Runway Gen-4 / Google Veo → відео
🔹 Все монтується у звичайному редакторі
🎯 Netflix, AMC, Lionsgate, Blumhouse і навіть Даррен Аронофскі вже інтегрують ці інструменти у продакшн.
🧠 Що це означає для нас?
AI забирає на себе частину традиційної відеотворчості: декорації, акторів, камери, монтаж.
Це знижує вартість входу в індустрію і відкриває двері новим креаторам.
А старі гравці можуть працювати швидше й масштабніше.
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍12❤3👎1🔥1🥴1
🧠 Як бізнес автоматизує роботу через AI‑агентів: приклади, інструменти, поради
Привіт, друзі!
Підготував практичний огляд про те, як бізнес уже зараз автоматизує процеси з допомогою AI‑агентів — автономних помічників на базі LLM‑моделей, які виконують рутину: комунікацію з клієнтами, звітність, бронювання, управління проектами.
🧩 Реальні кейси:
• Hebbia — агент-аналітик, який читає фінансові документи, робить висновки та пише меморандуми. Використовується в BlackRock, KKR, ВПС США, заощаджує сотні годин аналітики. джерело
• Retool Agents — автономні агенти обробляють клієнтські запити, аналітику, повернення. Працюють приблизно за $3/год, суттєво знижуючи навантаження. джерело
• TinyFish — агенти імітують дії користувачів на сайтах (моніторинг цін, бронювання, перевірка наявності). Використовуються в e‑commerce, навіть Google. джерело
---
🛠 Практичні підходи: які є AI‑агенти
• Кастомні агенти (LLM‑агенти)
Побудовані на GPT, Claude, Gemini — під ваші процеси, потребують технічної реалізації.
• No-code / low-code платформи
Relevance AI — агенти без коду.
SuperOps — автоматизація підтримки.
StackAI, MindStudio — швидкий запуск агентів з тексту або логіки.
• Корпоративні агенти (Copilots)
Microsoft Copilot for Service — інтегрується в Outlook, Teams та CRM (Salesforce, Zendesk), допомагає з email-чернетками, резюме кейсів, зустрічей.
OpenAI Agent Mode — автономне виконання завдань у браузері, Gmail, Drive.
Microsoft також працює над “Tenant Copilot” і “Agent Factory” — платформами для створення агентів як цифрових співробітників.
🧭 Який підхід обрати?
Стартап / технічний засновник → кастомний агент на базі LLM
Малий бізнес / школа / фітнес‑студія / звичайний користувач → Relevance AI, StackAI, MindStudio або OpenAI Agent Mode
Корпорація / B2B → Microsoft Copilot for Service або кастомні агенти через OpenAI Agent‑building platform
🔝 Топ‑5 задач, які агенти вже автоматизують:
1. Створення задач із листів або нотаток
2. Автоматична звітність і дашборди
3. Моніторинг проєктів і прогнозування ризиків
4. Автоматична клієнтська підтримка (FAQ, броні, запити)
5. Автономна бронь, покупки, реєстрація
---
📌 Висновок
AI‑агенти — це не майбутнє, а вже робочий інструмент, який допомагає компаніям будь-якого розміру економити час і гроші.
Сьогодні достатньо 1–2 днів, щоб протестувати агента під свої задачі — без коду і без великих бюджетів.
🗨 Напишіть у коментарях, якщо вам цікаво — підготую покроковий гайд:
як запустити агента під ваш бізнес, які інструменти обрати і як уникнути помилок на старті.
✅ Став 👍 якщо було корисно.
🔔 ПІДПИСАТИСЯ
👍16👏2