Напишите в комментариях самые запоминающиеся/интересные/сложные вопросы/задачи по С++ с интервью, которые вы проходили.
Надеюсь из поста читатели смогут для себя подчерпнуть интересные моменты и найти точки роста, чтобы в следующий раз точно пройти собес.
Я начну. Написать потокобезопасную очередь с приоритетом.
Приоритета всего 3.
Количество тасок с 1 и 2 приоритетом в очереди ограничено, с наименьшим приоритетом - неограничено.
При попытке вставить в очередь слишком много задач 1 или 2 приоритета, этот метод блочится.
Доставаться из очереди таски должны строго по убыванию приоритета: только при отсутствии задач более высокого приоритета можно начать отдавать задачи более низкого.
Practice interview. Stay cool.
Надеюсь из поста читатели смогут для себя подчерпнуть интересные моменты и найти точки роста, чтобы в следующий раз точно пройти собес.
Я начну. Написать потокобезопасную очередь с приоритетом.
Приоритета всего 3.
Количество тасок с 1 и 2 приоритетом в очереди ограничено, с наименьшим приоритетом - неограничено.
При попытке вставить в очередь слишком много задач 1 или 2 приоритета, этот метод блочится.
Доставаться из очереди таски должны строго по убыванию приоритета: только при отсутствии задач более высокого приоритета можно начать отдавать задачи более низкого.
Practice interview. Stay cool.
🔥13❤8👍3❤🔥2
Экскурсия по лабораториям YADRO: как тестируют серверы и телеком-оборудование
В ноябре и декабре YADRO проводит экскурсии по своим лабораториям в Санкт-Петербурге и Москве.
На маршрутах — тестовые стенды, оборудование на разных этапах отладки и рабочие пространства команд. Инженеры расскажут, какие проверки проходит железо, и ответят на вопросы.
📍Санкт-Петербург — 12 ноября и 1 декабря
📍Москва — 17 ноября и 8 декабря
Сбор гостей в 18:30, старт в 19:00.
Экскурсия занимает до двух часов. Участие бесплатное — нужно зарегистрироваться и дождаться подтверждения от организаторов. Возраст участников — от 18 лет.
Зарегистрироваться
Реклама. ООО "КНС ГРУПП". ИНН 7701411241. erid: 2W5zFGVnpQA
В ноябре и декабре YADRO проводит экскурсии по своим лабораториям в Санкт-Петербурге и Москве.
На маршрутах — тестовые стенды, оборудование на разных этапах отладки и рабочие пространства команд. Инженеры расскажут, какие проверки проходит железо, и ответят на вопросы.
📍Санкт-Петербург — 12 ноября и 1 декабря
📍Москва — 17 ноября и 8 декабря
Сбор гостей в 18:30, старт в 19:00.
Экскурсия занимает до двух часов. Участие бесплатное — нужно зарегистрироваться и дождаться подтверждения от организаторов. Возраст участников — от 18 лет.
Зарегистрироваться
Реклама. ООО "КНС ГРУПП". ИНН 7701411241. erid: 2W5zFGVnpQA
👍10❤6🔥6👎5😁1
С++26. Или все-таки 27?
Немного с опозданием, но новость все-таки на канале. Черновик С++26 не удалось утвердить с первого раза на этапе голосования национальных органов ISO. Фактически, принятие С++26 отложено на неопределенный срок.
Почему так?
Причиной скорее всего являются контракты. По сути, это возможность писать что-то вроде
Вроде идея-то классная. Но ее дизайн в стандарте оказался не очень удачным.
Против него высказалось достаточно тяжеловесов мира плюсов, в том числе и сам Страуструп.
По поводу контрактов были ожесточенные дискуссии и в драфте С++26 был скорее некий MVP контрактов, нежели полноценная функциональность.
Бьерн же сказал, что «это не минимально жизнеспособный продукт. Это не минимально и не жизнеспособно», и что контракты добавляют сложность «очень неясными способами», меняя смысл кода в зависимости от контекста.
Если кому очень интересно, то вот и вот две бумаги от Бьерна и его коллег, критикующих контракты.
Там критика и по функционалу(очень сложно, описание примерно в 56 страниц текста), и по перформансу(не zero-cost) и по процедуре внедрения в драфт стандарта.
Тем не менее Страуструп и соавторы не против идеи контрактов как таковой. Они против конкретного неудачного дизайна из черновика С++26. В качестве альтернативы они предлагают:
👉🏿 Признать контракты просто отладочным инструментом, а не функцией безопасности.
👉🏿 Использовать гораздо более простой и мощный библиотечный дизайн, который уже реализован, протестирован и совместим (ссылаются на D4324R0 / P4324R0 — "C++ Design By Contract: Minimum Language, Maximum Library").
👉🏿 Вместо огромного и неполного языкового механизма сделать ставку на hardened standard libraries (ужесточенные стандартные библиотеки) с минимальными накладными расходами (замерено ~0.3% в production у Google) и статический анализ через C++ Core Guidelines.
Ну и главное. Это не конец С++ и не конец С++26. Наоборот, процессы вокруг принятия стандарта оказались способны предотвратить попадания в него вредной функциональности. Провал голосования означает, что комитету придётся вернуться к обсуждению, вероятно, пересмотреть подход к контрактам или процедуру их принятия, и провести повторное голосование.
Пишите в комментариях, что думаете по поводу контрактов и ситуации вокруг провала С++26.
Ставьте ⚡️, если поддерживаете слоняру-Бьерна.
Ставьте🗿, если достали эти деды, не дают языку стать безопаснее.
See opportunities in failures. Stay cool.
Немного с опозданием, но новость все-таки на канале. Черновик С++26 не удалось утвердить с первого раза на этапе голосования национальных органов ISO. Фактически, принятие С++26 отложено на неопределенный срок.
Почему так?
Причиной скорее всего являются контракты. По сути, это возможность писать что-то вроде
int divide(int a, int b) pre(b != 0) { ... }, где pre — это контракт, проверяемый во время выполнения или компиляции. В общем, это какие-то пред и/или постусловия, которым должны удовлетворять функции.Вроде идея-то классная. Но ее дизайн в стандарте оказался не очень удачным.
Против него высказалось достаточно тяжеловесов мира плюсов, в том числе и сам Страуструп.
По поводу контрактов были ожесточенные дискуссии и в драфте С++26 был скорее некий MVP контрактов, нежели полноценная функциональность.
Бьерн же сказал, что «это не минимально жизнеспособный продукт. Это не минимально и не жизнеспособно», и что контракты добавляют сложность «очень неясными способами», меняя смысл кода в зависимости от контекста.
Если кому очень интересно, то вот и вот две бумаги от Бьерна и его коллег, критикующих контракты.
Там критика и по функционалу(очень сложно, описание примерно в 56 страниц текста), и по перформансу(не zero-cost) и по процедуре внедрения в драфт стандарта.
Тем не менее Страуструп и соавторы не против идеи контрактов как таковой. Они против конкретного неудачного дизайна из черновика С++26. В качестве альтернативы они предлагают:
👉🏿 Признать контракты просто отладочным инструментом, а не функцией безопасности.
👉🏿 Использовать гораздо более простой и мощный библиотечный дизайн, который уже реализован, протестирован и совместим (ссылаются на D4324R0 / P4324R0 — "C++ Design By Contract: Minimum Language, Maximum Library").
👉🏿 Вместо огромного и неполного языкового механизма сделать ставку на hardened standard libraries (ужесточенные стандартные библиотеки) с минимальными накладными расходами (замерено ~0.3% в production у Google) и статический анализ через C++ Core Guidelines.
Ну и главное. Это не конец С++ и не конец С++26. Наоборот, процессы вокруг принятия стандарта оказались способны предотвратить попадания в него вредной функциональности. Провал голосования означает, что комитету придётся вернуться к обсуждению, вероятно, пересмотреть подход к контрактам или процедуру их принятия, и провести повторное голосование.
Пишите в комментариях, что думаете по поводу контрактов и ситуации вокруг провала С++26.
Ставьте ⚡️, если поддерживаете слоняру-Бьерна.
Ставьте🗿, если достали эти деды, не дают языку стать безопаснее.
See opportunities in failures. Stay cool.
⚡84❤9👍5🗿5🤔1
LRU-кэш на собеседовании
#опытным
LRU (Least Recently Used) - классический вопрос на собеседованиях. Вроде не чистый литкоды, можно и ООП пописать, и помикроархитектурить. Но тем не менее задача проверяет знание алгоритмов и структур данных применительно к реально используемой штуке.
Требования к задаче:
👉🏿 Реализовать LRU-кэш с фиксированной ёмкостью, задаваемой в конструкторе.
👉🏿 Операции
👉🏿 При переполнении удаляется самый редкоиспользованный элемент.
👉🏿
👉🏿 нет требований на потокобезопасность.
Типичное решение, безо всяких ухищрений: двусвязный список (
Разберём ключевые моменты:
Очевидно, что нам нужен ассоциативный контейнер, работающий за O(1). Из стандартного это std::unordered_map. Получим просто key-value хранилище.
Теперь нам нужна логика последнего использованного. Здесь надо бы хранить последовательность ключей от самого редкоиспользуемого до последнего использованного. Подойдет какой-то последовательный контейнер. Но нам нужно уметь за константу добавлять новый элемент либо перемещать в начало вновь запрошенный элемент. За константу переместить из середины в начало может std::list.
И в конце нам надо как-то связать эти две структуры. В мапке, по которой и будет происходить поиск, в качестве значения будем хранить не значение по ключу, а итератор на лист. Только зная итератор (по сути указатель на элемент) мы можем за константу переместить элемент из середины в конец.
Осталось только корректно это все подружить друг с другом и получится рабочее решение. Можно поиграться на годболте.
Тут есть потенциал для оптимизаций (например кэш локалити при использовании std::list), это не продовое решение. Но для собеседования это решение базово удовлетворяет всем требованиям.
Good luck with interviews. Stay cool.
#interview #algorithms
#опытным
LRU (Least Recently Used) - классический вопрос на собеседованиях. Вроде не чистый литкоды, можно и ООП пописать, и помикроархитектурить. Но тем не менее задача проверяет знание алгоритмов и структур данных применительно к реально используемой штуке.
Требования к задаче:
👉🏿 Реализовать LRU-кэш с фиксированной ёмкостью, задаваемой в конструкторе.
👉🏿 Операции
get(key) и put(key, value) должны работать за O(1) в среднем.👉🏿 При переполнении удаляется самый редкоиспользованный элемент.
👉🏿
get возвращает ссылку на значение значение, если ключ есть, иначе - сигнал об отсутствии.👉🏿 нет требований на потокобезопасность.
Типичное решение, безо всяких ухищрений: двусвязный список (
std::list) для порядка использования + хеш-таблица (std::unordered_map) для доступа по ключу.template<typename Key, typename Value>
class LRUCache {
public:
using value_type = std::pair<Key, Value>;
using list_type = std::list<value_type>;
using list_iterator = typename list_type::iterator;
using map_type = std::unordered_map<Key, list_iterator>;
explicit LRUCache(size_t capacity) : cap_(capacity) {
if (cap_ == 0) throw std::invalid_argument("Capacity must be > 0");
}
std::optional<std::reference_wrapper<const Value>> get(const Key& key) {
auto it = idx_.find(key);
if (it == idx_.end()) return std::nullopt;
entries_.splice(entries_.begin(), entries_, it->second);
return std::cref(it->second->second);
}
void put(const Key& key, Value value) {
auto it = idx_.find(key);
if (it != idx_.end()) {
it->second->second = std::move(value);
entries_.splice(entries_.begin(), entries_, it->second);
return;
}
if (entries_.size() == cap_) {
const Key& k_evict = entries_.back().first;
idx_.erase(k_evict);
entries_.pop_back();
}
entries_.emplace_front(key, std::move(value));
idx_.emplace(key, entries_.begin());
}
bool contains(const Key& key) const {
return idx_.find(key) != idx_.end();
}
size_t size() const { return entries_.size(); }
size_t capacity() const { return cap_; }
private:
size_t cap_;
list_type entries_;
std::unordered_map<Key, list_iterator> idx_;
};
Разберём ключевые моменты:
Очевидно, что нам нужен ассоциативный контейнер, работающий за O(1). Из стандартного это std::unordered_map. Получим просто key-value хранилище.
Теперь нам нужна логика последнего использованного. Здесь надо бы хранить последовательность ключей от самого редкоиспользуемого до последнего использованного. Подойдет какой-то последовательный контейнер. Но нам нужно уметь за константу добавлять новый элемент либо перемещать в начало вновь запрошенный элемент. За константу переместить из середины в начало может std::list.
И в конце нам надо как-то связать эти две структуры. В мапке, по которой и будет происходить поиск, в качестве значения будем хранить не значение по ключу, а итератор на лист. Только зная итератор (по сути указатель на элемент) мы можем за константу переместить элемент из середины в конец.
Осталось только корректно это все подружить друг с другом и получится рабочее решение. Можно поиграться на годболте.
Тут есть потенциал для оптимизаций (например кэш локалити при использовании std::list), это не продовое решение. Но для собеседования это решение базово удовлетворяет всем требованиям.
Good luck with interviews. Stay cool.
#interview #algorithms
👍19❤11🔥6⚡2🤓1
Ссылка внутри std::optional
#опытным
В прошлом посте была конструкция
Зачем так сложно? Почему нельзя было просто std::optional<const Value&>?
Дело в том, что в C++17 и далее конструкция std::optional<T&> по стандарту ill-formed программе. И реализации зачастую даже ставили static_assert на ее использование.
Проблема была в опасности самой конструкции, а скорее в спорах по дизайну. Что должно случиться при assignment'е: изменение объекта, ссылка на который хранится в optional, или все-таки замена самой ссылки, чтобы optional просто указывал на другой объект.
В то время видимо были весомые аргументы в пользу обоих вариантов, поэтому так и не выбрали ничего. И вынудили нас использовать немного корявый вариант с std::reference_wrapper, который работает примерно так:
Синтаксис выглядит не очень. Оно и понятно, учитывая вложенность классов.
Но о чудо! В C++26 этот костыль больше не нужен. Был принят документ P2988R12, который добавляет частичную специализацию
Теперь можно писать напрямую:
Что важного нужно знать об этой специализации?
👉🏿 Это не владеющий nullable-тип: хранит указатель
👉🏿 Присваивание всегда rebind:
👉🏿
👉🏿
👉🏿 Конструирование тривиальное (простая обёртка над указателем).
👉🏿 Ну и наше любимое: автор пропоузала позаботился о том, чтобы по-максимуму минимизировать возможности для появления висячих ссылок. Конструкторы, которые могли бы создать временный объект и dangling-ссылку, удалены. А на другие методы наложены ограничения, которые не позволяют скомпилировать такие конструкции:
Если кто-то хотел nullable ссылку, то вот вам пожалуйста. Работает в рамках давно привычных конценций.
Break crutches. Stay cool.
#cpp26
#опытным
В прошлом посте была конструкция
std::optional<std::reference_wrapper<const Value>>. Зачем так сложно? Почему нельзя было просто std::optional<const Value&>?
Дело в том, что в C++17 и далее конструкция std::optional<T&> по стандарту ill-formed программе. И реализации зачастую даже ставили static_assert на ее использование.
Проблема была в опасности самой конструкции, а скорее в спорах по дизайну. Что должно случиться при assignment'е: изменение объекта, ссылка на который хранится в optional, или все-таки замена самой ссылки, чтобы optional просто указывал на другой объект.
В то время видимо были весомые аргументы в пользу обоих вариантов, поэтому так и не выбрали ничего. И вынудили нас использовать немного корявый вариант с std::reference_wrapper, который работает примерно так:
// Переприсваивание самой ссылки
int a = 1;
int b = 2;

std::optional<std::reference_wrapper<int>> opt = std::ref(a);
// opt "смотрит" на a

opt = std::ref(b);
// Теперь opt "смотрит" на b. Значение a осталось равно 1.


// Изменение объекта по ссылке
int x = 10;
std::optional<std::reference_wrapper<int>> opt = std::ref(x);
opt->get() = 42;          // x == 42
// или
opt.value().get() = 43;   // x == 43
Синтаксис выглядит не очень. Оно и понятно, учитывая вложенность классов.
Но о чудо! В C++26 этот костыль больше не нужен. Был принят документ P2988R12, который добавляет частичную специализацию
std::optional для lvalue-ссылок.Теперь можно писать напрямую:
std::optional<int&> opt = a;
opt = b;        // opt теперь ссылается на b; a остается неизменным
*opt = 42;      // пишем в b
Что важного нужно знать об этой специализации?
👉🏿 Это не владеющий nullable-тип: хранит указатель
T* или nullptr, не имеет отдельного стораджа для объекта внутри себя.👉🏿 Присваивание всегда rebind:
optional начинает ссылаться на другой объект; семантика assign-through не используется.👉🏿
const optional<T&> позволяет менять объект по ссылке, optional<const T&> - уже нет.👉🏿
value_or возвращает T по значению, а не ссылку.👉🏿 Конструирование тривиальное (простая обёртка над указателем).
👉🏿 Ну и наше любимое: автор пропоузала позаботился о том, чтобы по-максимуму минимизировать возможности для появления висячих ссылок. Конструкторы, которые могли бы создать временный объект и dangling-ссылку, удалены. А на другие методы наложены ограничения, которые не позволяют скомпилировать такие конструкции:
opt = 42;
opt = std::string("привет");
Если кто-то хотел nullable ссылку, то вот вам пожалуйста. Работает в рамках давно привычных конценций.
Break crutches. Stay cool.
#cpp26
🔥15❤8👍7
Почему список инициализации конструктора работает не как ожидается?
#новичкам
Классическая проблема - вы написали какой-то класс с какими-то полями и хотите в списке инициализации задать значения этим полям. Пишите:
Все бы хорошо, но при запуске получаем UB. Потому что мало ли что вы там хотели в своем порядке проинициализировать. Инициализация происходит так, как описано в списке инициализации, но в порядке объявления полей в классе.
Значит
Понятное дело, что так требует стандарт: все поля инициализируются строго в порядке объявления. Но почему так? Почему нельзя просто разрешить задавать значения полям в том порядке, в котором они прописаны в list initialization?
Проведем мысленный эксперимент: сделаем 3 конструктора и все 3 будут иметь разный порядок инициализации в списках. И это может работать.
Но рано или поздно придет время разрушать объекты. В каком порядке будем разрушать?
Надо, вообще говоря, в порядке создания. А как компилятору понять, в каком порядке разрушать поля, если каждый конструктор задает свой порядок?
1️⃣ Допустим, что компилятор будут генерить код с прежними требованиями: разрушаем поля в порядке обратном объявлению. Многие фундаментальные принципы С++, в том числе и RAII, держатся на простом контракте: ресурс захватывается в конструкторе, освобождается в деструкторе, а зависимости между ресурсами живут по принципу LIFO. Если один ресурс использует другой, то он должен быть создан после него и разрушен до него. В итоге в этом случае будет просто UB при разрушении объектов.
2️⃣ А можно ли разрушать в соответствии с созданием объекта? Это мало того, что нужно как-то идентифицировать объекты в рантайме, чтобы понимать порядок создания/уничтожения полей. Так еще потребуются фактически разные деструкторы, каждый для своего конструктора. И подумайте, что тут будет при наследовании.
В общем, этот подход накладывает оверхэд и делает код менее предсказуемым.
Поэтому мы и живем с такой неочевидностью в списках инициализации.
Have an order in life. Stay cool.
#cppcore
#новичкам
Классическая проблема - вы написали какой-то класс с какими-то полями и хотите в списке инициализации задать значения этим полям. Пишите:
class TcpClient {
    Connection conn_;
    Socket socket_;
public:
    TcpClient(const std::string& host, uint16_t port)
        : socket_(host, port),
          conn_(socket_) {}
};
int main() {
    TcpClient client("example.com", 8080);
}
Все бы хорошо, но при запуске получаем UB. Потому что мало ли что вы там хотели в своем порядке проинициализировать. Инициализация происходит так, как описано в списке инициализации, но в порядке объявления полей в классе.
Значит
conn_ будет инициализировать помойкой, так как у socket_ еще не задано корректное значение. И все, имеем коннекшен, открывающий портал в другую галактику, а не в нужную аппку.Понятное дело, что так требует стандарт: все поля инициализируются строго в порядке объявления. Но почему так? Почему нельзя просто разрешить задавать значения полям в том порядке, в котором они прописаны в list initialization?
Проведем мысленный эксперимент: сделаем 3 конструктора и все 3 будут иметь разный порядок инициализации в списках. И это может работать.
Но рано или поздно придет время разрушать объекты. В каком порядке будем разрушать?
Надо, вообще говоря, в порядке создания. А как компилятору понять, в каком порядке разрушать поля, если каждый конструктор задает свой порядок?
1️⃣ Допустим, что компилятор будут генерить код с прежними требованиями: разрушаем поля в порядке обратном объявлению. Многие фундаментальные принципы С++, в том числе и RAII, держатся на простом контракте: ресурс захватывается в конструкторе, освобождается в деструкторе, а зависимости между ресурсами живут по принципу LIFO. Если один ресурс использует другой, то он должен быть создан после него и разрушен до него. В итоге в этом случае будет просто UB при разрушении объектов.
2️⃣ А можно ли разрушать в соответствии с созданием объекта? Это мало того, что нужно как-то идентифицировать объекты в рантайме, чтобы понимать порядок создания/уничтожения полей. Так еще потребуются фактически разные деструкторы, каждый для своего конструктора. И подумайте, что тут будет при наследовании.
В общем, этот подход накладывает оверхэд и делает код менее предсказуемым.
Поэтому мы и живем с такой неочевидностью в списках инициализации.
Have an order in life. Stay cool.
#cppcore
👍22🔥11❤8
В России можно посещать IT-мероприятия хоть каждый день: как оффлайн, так и онлайн
Но где их находить? Как узнавать о них раньше, чем когда все начнут выкладывать фотографии оттуда?
Переходите на канал IT-Мероприятия России. В нём каждый день анонсируются мероприятия со всех городов России
📆 в канале размещаются как онлайн, так и оффлайн мероприятия;
👩💻 можно найти ивенты по любому стеку: программирование, frontend-backend разработка, кибербезопасность, дата-аналитика, osint, devops и другие;
🎙 разнообразные форматы мероприятий: митапы с коллегами по цеху, конференции и вебинары с известными опытными специалистами, форумы и олимпиады от важных представителей индустрии и многое другое
А чтобы не искать по разным форумам и чатам новости о предстоящих ивентах:
🚀 IT-мероприятия России — подписывайся и будь в курсе всех предстоящих мероприятий!
Но где их находить? Как узнавать о них раньше, чем когда все начнут выкладывать фотографии оттуда?
Переходите на канал IT-Мероприятия России. В нём каждый день анонсируются мероприятия со всех городов России
📆 в канале размещаются как онлайн, так и оффлайн мероприятия;
👩💻 можно найти ивенты по любому стеку: программирование, frontend-backend разработка, кибербезопасность, дата-аналитика, osint, devops и другие;
🎙 разнообразные форматы мероприятий: митапы с коллегами по цеху, конференции и вебинары с известными опытными специалистами, форумы и олимпиады от важных представителей индустрии и многое другое
А чтобы не искать по разным форумам и чатам новости о предстоящих ивентах:
🚀 IT-мероприятия России — подписывайся и будь в курсе всех предстоящих мероприятий!
👍6❤5🔥5
Скользящее среднее
#новичкам
Посчитать среднее для заданного набора элементов - может в принципе хороший школьник начальных классов.
А что если надо посчитать среднее в скользящем окне значений? Да еще и за O(1) на добавление значения в окно и расчет среднего?
Начнем с наивного линейного решения:
Берем скучный вектор, при добавлении вставляем в конец(О(1) амортизированное) и удаляем из начала(О(N)). При запросе среднего каждый раз проходимся по всей коллекции.
Это очень наивно, и очень неэффективно.
Если даже просто банально поменять вектор на std::deque, то мы уже будем выполнять addValue за константу(вставка/удаление в начало/конец - константные операции для дека).
Для удовлетворения требований задачи осталось только расчет среднего оптимизировать. Расчет скользящего среднего за константу - это значит, что нам надо просто сумму обновлять каждый раз. Будем каждый раз при добавлении нового значения выкидывать из суммы последний элемент дека и добавлять значение нового.
Целиком выйдет что-то такое:
Однако добавление элементов в дек все равно будет триггерить динамические аллокации на создание нового блока под элементы и деаллокацию старых. Плюс элементы рядом лежат только внутри одного блока, кэш локалити между разными блоками слабая.
Все эти проблемы можно решить с помощью кольцевого буфера. В конструкторе выделяем память для вектора нужного размера и дальше просто закольцовываем операции удаления и добавления нового элемента - новый будет просто перезаписывать старый. Сумма при этом будет обновляться похожим образом: вычитаем старый элемент и прибавляем новый.
Выглядит это так:
Дальше оптимизировать алгоритмически уже сложно. К сожалению, точное среднее не получится посчитать, не имея полного набора элементов в окне. Есть разные приближенные методы типа экспоненциального сглаживания, но использование таких методов должно быть допустимо с точки зрения домена вычислений.
Use the right structure. Stay cool.
#algorithms #interview
#новичкам
Посчитать среднее для заданного набора элементов - может в принципе хороший школьник начальных классов.
А что если надо посчитать среднее в скользящем окне значений? Да еще и за O(1) на добавление значения в окно и расчет среднего?
Начнем с наивного линейного решения:
class MovingAverage {
public:
    explicit MovingAverage(int size) : maxSize(size) {}

    void addValue(double value) {
        buffer.push_back(value);
        if (buffer.size() > maxSize) {
            buffer.erase(buffer.begin()); // O(N)
        }
    }

    double getAverage() const {
        if (buffer.empty()) return 0.0;
        double sum = std::accumulate(buffer.begin(), buffer.end(), 0.0); // O(N)
        return sum / buffer.size();
    }

private:
    std::vector<double> buffer;
    int maxSize;
};
Берем скучный вектор, при добавлении вставляем в конец(О(1) амортизированное) и удаляем из начала(О(N)). При запросе среднего каждый раз проходимся по всей коллекции.
Это очень наивно, и очень неэффективно.
Если даже просто банально поменять вектор на std::deque, то мы уже будем выполнять addValue за константу(вставка/удаление в начало/конец - константные операции для дека).
Для удовлетворения требований задачи осталось только расчет среднего оптимизировать. Расчет скользящего среднего за константу - это значит, что нам надо просто сумму обновлять каждый раз. Будем каждый раз при добавлении нового значения выкидывать из суммы последний элемент дека и добавлять значение нового.
Целиком выйдет что-то такое:
class MovingAverage {
public:
    explicit MovingAverage(int windowSize) : size_(windowSize), sum_(0.0) {}

    void addValue(double value) {
        prices_.push_back(price);
        sum_ += price;
        if (prices_.size() > size_) {
            sum_ -= prices_.front();
            prices_.pop_front();
        }
    }

    double getMovingAverage() const {
        if (prices_.empty()) return 0.0;
        return sum_ / prices_.size();
    }

private:
    std::deque<double> prices_;
    double sum_;
    int size_;
};
Однако добавление элементов в дек все равно будет триггерить динамические аллокации на создание нового блока под элементы и деаллокацию старых. Плюс элементы рядом лежат только внутри одного блока, кэш локалити между разными блоками слабая.
Все эти проблемы можно решить с помощью кольцевого буфера. В конструкторе выделяем память для вектора нужного размера и дальше просто закольцовываем операции удаления и добавления нового элемента - новый будет просто перезаписывать старый. Сумма при этом будет обновляться похожим образом: вычитаем старый элемент и прибавляем новый.
Выглядит это так:
class MovingAverage {
public:
    explicit MovingAverage(int size)
        : buffer(size, 0.0), maxSize(size) {}

    void addPrice(double price) {
        // update sum
        sum -= buffer[index];
        sum += price;
        // override buffer elem
        buffer[index] = price;
        index = (index + 1) % maxSize;

        if (count < maxSize) count++;
    }

    double getAverage() const {
        return count == 0 ? 0.0 : sum / count;
    }

private:
    std::vector<double> buffer;
    int maxSize;
    int index = 0;
    int count = 0;
    double sum = 0.0;
};
Дальше оптимизировать алгоритмически уже сложно. К сожалению, точное среднее не получится посчитать, не имея полного набора элементов в окне. Есть разные приближенные методы типа экспоненциального сглаживания, но использование таких методов должно быть допустимо с точки зрения домена вычислений.
Use the right structure. Stay cool.
#algorithms #interview

❤14👍9🔥7⚡2🥱2
Деление по модулю
#опытным
В прошлом посте в реализации скользящего среднего через ринг буффер используется формула
Но знаете ли вы, что деление по модулю - это очень медленная операция?
Сложение, вычитание и основные битовые операции выполняются условно за 1 такт. Сигнал просто проходит через сумматор и все. Умножение - за 3-4 за счет аппаратного умножителя (Wallace tree, carry-save adder).
А вот инструкция div выполняется за 10-50 тактов. На порядок больше. Почему так?
Деление просто не имеет быстрой аппаратной схемы. Чтобы получить
1. Сравнить старшие биты делимого и делителя.
2. Вычесть (или не вычесть) делитель.
3. Сдвинуть частичный остаток.
4. Повторить для следующего бита частного.
Условно, процессор делит в столбик.
Блок деления устроен итеративно: вместо одной комбинационной схемы процессор за несколько шагов вычисляет очередные биты частного.
Теоретически можно построить полностью комбинационную схему для деления, которая выдавала бы результат сильно быстрее. Но такая схема для 64-битных чисел потребовала бы много транзисторов/много памяти и огромную площадь на кристалле.
Поскольку деление в реальных программах встречается относительно редко (по разным оценкам порядка 1% от всех инструкций), инженеры хардвара идут на компромисс: они делают блок деления компактным и последовательным, жертвуя скоростью ради экономии места на чипе для более важных блоков (например, кэш-памяти или блоков векторных инструкций AVX-512).
Вывод тут один: если вы паритесь за нано и микросекунды, то избегайте деления.
Но как?
Есть несколько методик, которые применимы в общем и в данном конкретном случае:
1️⃣ Можно сделать параметр size шаблонным. Тогда компилятор сможет применить оптимизацию "умножения на магическое число" (метод Гранлунда-Монтгомери). Главная идея - если делитель является константой на этапе выполнения или компиляции цикла, деление n / d можно заменить математически эквивалентным выражением вида
2️⃣ Если уж прям нельзя сделать шаблонным параметр, то тоже не страшно. maxSize же не меняется. Поэтому нам просто нужно самим сделать то, что делает компилятор. Условно, в конструкторе предрасчитать магические числа и потом использовать быстрое умножение. Для этого естественно есть библиотечки, типа libdivide. Вот небольшой отрывок кода, как ей пользоваться:
3️⃣ Можно ограничить пространство значений размера ринг буфера до степени двойки. Тогда деление по модулю можно заменить на супербыстрое битовое умножение:
По сути просто оставляем только младшие разряды числа и предотвращаем переполнение.
4️⃣ Можно просто использовать условие:
Предсказатель переходов здесь должен хорошо отрабатывать и латенси должно ощутимо снизиться.
Не во всех случаях подходит, но в этом работает прекрасно.
То есть проблему можно решить и можно(и нужно) даже побэнчмарчить, что быстрее по итогу.
Don't let the pipeline stall. Stay cool.
#performance #compiler #hardware
#опытным
В прошлом посте в реализации скользящего среднего через ринг буффер используется формула
index = (index + 1) % maxSize. Делим по модулю на максимальный размер, чтобы текущий индекс не превысил его.Но знаете ли вы, что деление по модулю - это очень медленная операция?
Сложение, вычитание и основные битовые операции выполняются условно за 1 такт. Сигнал просто проходит через сумматор и все. Умножение - за 3-4 за счет аппаратного умножителя (Wallace tree, carry-save adder).
А вот инструкция div выполняется за 10-50 тактов. На порядок больше. Почему так?
Деление просто не имеет быстрой аппаратной схемы. Чтобы получить
x / y, процессор выполняет циклический алгоритм - обычно это модификации SRT division (назван по фамилиям Sweeney, Robertson, Tocher):1. Сравнить старшие биты делимого и делителя.
2. Вычесть (или не вычесть) делитель.
3. Сдвинуть частичный остаток.
4. Повторить для следующего бита частного.
Условно, процессор делит в столбик.
Блок деления устроен итеративно: вместо одной комбинационной схемы процессор за несколько шагов вычисляет очередные биты частного.
Теоретически можно построить полностью комбинационную схему для деления, которая выдавала бы результат сильно быстрее. Но такая схема для 64-битных чисел потребовала бы много транзисторов/много памяти и огромную площадь на кристалле.
Поскольку деление в реальных программах встречается относительно редко (по разным оценкам порядка 1% от всех инструкций), инженеры хардвара идут на компромисс: они делают блок деления компактным и последовательным, жертвуя скоростью ради экономии места на чипе для более важных блоков (например, кэш-памяти или блоков векторных инструкций AVX-512).
Вывод тут один: если вы паритесь за нано и микросекунды, то избегайте деления.
Но как?
Есть несколько методик, которые применимы в общем и в данном конкретном случае:
1️⃣ Можно сделать параметр size шаблонным. Тогда компилятор сможет применить оптимизацию "умножения на магическое число" (метод Гранлунда-Монтгомери). Главная идея - если делитель является константой на этапе выполнения или компиляции цикла, деление n / d можно заменить математически эквивалентным выражением вида
(n * m) >> s, где m и s - предвычисленные константы. m - некое обратное число в модульной арифметике, а s - зависит от разрядности чисел при делении и их величины.2️⃣ Если уж прям нельзя сделать шаблонным параметр, то тоже не страшно. maxSize же не меняется. Поэтому нам просто нужно самим сделать то, что делает компилятор. Условно, в конструкторе предрасчитать магические числа и потом использовать быстрое умножение. Для этого естественно есть библиотечки, типа libdivide. Вот небольшой отрывок кода, как ей пользоваться:
int sum_of_quotients(const int *numers, int count, int d) {
    int result = 0;
    libdivide::divider<int> fast_d(d); //constructs an instance of libdivide::divider
    for (int i=0; i < count; i++)
        result += numers[i] / fast_d; //uses faster libdivide division
    return result;
}
3️⃣ Можно ограничить пространство значений размера ринг буфера до степени двойки. Тогда деление по модулю можно заменить на супербыстрое битовое умножение:
index = (index + 1) & (maxSize - 1)
По сути просто оставляем только младшие разряды числа и предотвращаем переполнение.
4️⃣ Можно просто использовать условие:
index++;
if (index >= maxSize) {
    index = 0;
}
Предсказатель переходов здесь должен хорошо отрабатывать и латенси должно ощутимо снизиться.
Не во всех случаях подходит, но в этом работает прекрасно.
То есть проблему можно решить и можно(и нужно) даже побэнчмарчить, что быстрее по итогу.
Don't let the pipeline stall. Stay cool.
#performance #compiler #hardware
❤11🔥8👍6💯2
Кто в IT платит выше рынка? И какой оффер считается хорошим?
Предлагаем опытным IT-специалистам поделиться мнением о зарплатах и бенефитах в крупных технологических компаниях.
Кто, на ваш взгляд, платит выше рынка?
У кого привлекательнее премии?
Насколько важны ДМС, спорт, питание и другие бонусы при выборе работы?
👉 Поделиться мнением: https://clck.ru/3WzzJ6
Предлагаем опытным IT-специалистам поделиться мнением о зарплатах и бенефитах в крупных технологических компаниях.
Кто, на ваш взгляд, платит выше рынка?
У кого привлекательнее премии?
Насколько важны ДМС, спорт, питание и другие бонусы при выборе работы?
👉 Поделиться мнением: https://clck.ru/3WzzJ6
❤4👍4🔥4
Store buffer
#опытным
Все примерно понимают, зачем нужен кэш в ядре процессора. Процессора очень быстрый, а память либо медленная, дешевая и объемная, либо быстрая, дорогая и маленькая. Поэтому перед ОЗУ ставят каскад быстрых и небольших кэшэй, чтобы ускорить работу с памятью.
Но это все равно не до конца решает проблему, а потенциально добавляет новых. Современные процессы содержат несколько ядер, которые общаются друг с другом по протоколу когерентности кэшей(усложненные вариации MESI). Чтобы записать в свой кэш, ядро должно инвалидировать все кэш линии других ядер, содержащих копию тех же данных.
Процесс занимает какое-то время(десятки тактов), на которое ядро должно остановить конвейер и ожидать подтверждения инвалидации от других ядер.
Ждать никто не хочет, поэтому инженеры железа внедрили еще одну оптимизацию.
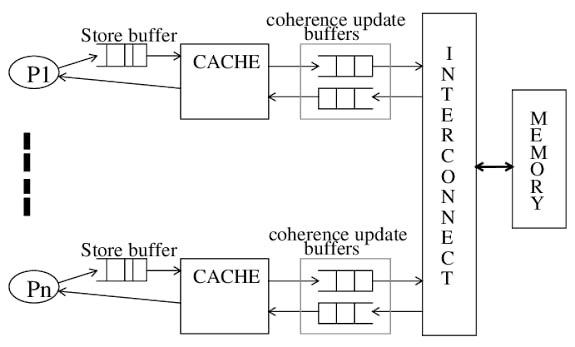
Когда ядро процессора делает запись в память, оно не ждёт, пока значение доедет до L1. Оно кладёт его в маленький per-core FIFO между ядром и кэшем - store buffer. Он содержит завершённые(с точки зрения CPU) записи, пока их кэш-линия не будет получена в эксклюзивное владение (M state) через MESI и не произойдет реальная запись. Только после этого можно рассчитывать, что изменения увидят другие ядра.
Глубина очереди - обычно несколько десятков записей в зависимости от процессора.
Получается, когда ядро выполняет
Вещь прекрасная, но надо понимать некоторые важные моменты:
1️⃣ Буфер ограниченный. Значит аномалии в инструкциях, типа большого количества записей в разные ячейки может его заполнить до конца и ждать все-таки придется.
2️⃣ Как придется ждать всему пайплайну исполнения при L1-write промахе. Если адреса для записи нет в кэше, то надо ее подтянуть, а это очень долго.
3️⃣ Некоторые барьеры памяти форсят запись буффера в кэш-линию. Это одна из причин, почему более строгий порядок операций над атомиками может приводить к уменьшению перфа.
4️⃣ При выполнении чтения поиск в первую очередь происходит в этом буффере. Вдруг мы совсем недавно выполнили запись и хотим по горячим следам увидеть эти данные. Чтобы не искать в кэше, первым делом ядро смотрит в свой буфер.
5️⃣ Буффер записи - это инструмент спекуляции процесса. Он пытается схитрить и срезать углы. И у этого есть последствия.
Например, случилась запись переменной в каком-то потоке. Если дальше очень быстро последует чтение, то чтение из этого потока увидит обновленную информацию, а чтение из другого потока - нет.
Это будет происходить даже с атомиками с более слабыми порядками, чем memory_order_seq_cst.
6️⃣ Отложенной записью объясняется единственный вид реордеринга, который разрешается архитектурой x86 - StoreLoad. Об этом в другом посте.
То есть, это не волшебная вундервафля, решающая все проблемы. Это всего лишь инструмент спекуляции, у которого есть ограничения и последствия. И, плотно работая с продвинутой многопоточкой, важно понимать механизм его работы и эти аспекты.
Don't wait. Stay cool.
#concurrency #hardware
#опытным
Все примерно понимают, зачем нужен кэш в ядре процессора. Процессора очень быстрый, а память либо медленная, дешевая и объемная, либо быстрая, дорогая и маленькая. Поэтому перед ОЗУ ставят каскад быстрых и небольших кэшэй, чтобы ускорить работу с памятью.
Но это все равно не до конца решает проблему, а потенциально добавляет новых. Современные процессы содержат несколько ядер, которые общаются друг с другом по протоколу когерентности кэшей(усложненные вариации MESI). Чтобы записать в свой кэш, ядро должно инвалидировать все кэш линии других ядер, содержащих копию тех же данных.
Процесс занимает какое-то время(десятки тактов), на которое ядро должно остановить конвейер и ожидать подтверждения инвалидации от других ядер.
Ждать никто не хочет, поэтому инженеры железа внедрили еще одну оптимизацию.
Когда ядро процессора делает запись в память, оно не ждёт, пока значение доедет до L1. Оно кладёт его в маленький per-core FIFO между ядром и кэшем - store buffer. Он содержит завершённые(с точки зрения CPU) записи, пока их кэш-линия не будет получена в эксклюзивное владение (M state) через MESI и не произойдет реальная запись. Только после этого можно рассчитывать, что изменения увидят другие ядра.
Глубина очереди - обычно несколько десятков записей в зависимости от процессора.
Получается, когда ядро выполняет
mov [addr], value, инструкция завершается сразу как только значение попало в буфер. На конвейере при этом нет никакого ожидания - другие инструкции продолжают последовательно исполняться. Дальше буфер сам, асинхронно, сливает записи в кэш по мере получения линий.Вещь прекрасная, но надо понимать некоторые важные моменты:
1️⃣ Буфер ограниченный. Значит аномалии в инструкциях, типа большого количества записей в разные ячейки может его заполнить до конца и ждать все-таки придется.
2️⃣ Как придется ждать всему пайплайну исполнения при L1-write промахе. Если адреса для записи нет в кэше, то надо ее подтянуть, а это очень долго.
3️⃣ Некоторые барьеры памяти форсят запись буффера в кэш-линию. Это одна из причин, почему более строгий порядок операций над атомиками может приводить к уменьшению перфа.
4️⃣ При выполнении чтения поиск в первую очередь происходит в этом буффере. Вдруг мы совсем недавно выполнили запись и хотим по горячим следам увидеть эти данные. Чтобы не искать в кэше, первым делом ядро смотрит в свой буфер.
5️⃣ Буффер записи - это инструмент спекуляции процесса. Он пытается схитрить и срезать углы. И у этого есть последствия.
Например, случилась запись переменной в каком-то потоке. Если дальше очень быстро последует чтение, то чтение из этого потока увидит обновленную информацию, а чтение из другого потока - нет.
Это будет происходить даже с атомиками с более слабыми порядками, чем memory_order_seq_cst.
6️⃣ Отложенной записью объясняется единственный вид реордеринга, который разрешается архитектурой x86 - StoreLoad. Об этом в другом посте.
То есть, это не волшебная вундервафля, решающая все проблемы. Это всего лишь инструмент спекуляции, у которого есть ограничения и последствия. И, плотно работая с продвинутой многопоточкой, важно понимать механизм его работы и эти аспекты.
Don't wait. Stay cool.
#concurrency #hardware
👍19🔥10❤4❤🔥3