
Человеческие сообщения об ошибках в static_assert
#опытным
Одной неприятной особенностью static_assert еще с С++11 были ограничения на сообщения об ошибках. По сути могли использоваться только строковые литералы. ТО есть просто фиксированные строки. Никаких динамических преобразований:
Из сообщения об ошибке компиляции:
Хотя, вообще говоря, было бы неплохо увидеть размер переданного типа прямо в сообщении об ошибке для упрощения дебага. Но сделать мы этого не могли, даже константные выражения не могли использоваться.
До С++26, когда завезли константные выражения в сообщения об ошибках. После запятой может быть объект
Это позволило использовать различные библиотеки форматирования внутри сообщения об ошибке. Например std::format:
И это работает уже на gcc.
Так что внутри static_assert теперь разрешены любые выкрутасы, главное чтобы они были константными выражениями.
Be flexible. Stay cool.
#cpp26
#опытным
Одной неприятной особенностью static_assert еще с С++11 были ограничения на сообщения об ошибках. По сути могли использоваться только строковые литералы. ТО есть просто фиксированные строки. Никаких динамических преобразований:
template <class T>
void g() {
    static_assert(sizeof(T) == 4, "Type T size is not 4");
}
Из сообщения об ошибке компиляции:
error: static assertion failed: Type T size is not 4 мы узнаем лишь то, что размер не равен 4. Хотя, вообще говоря, было бы неплохо увидеть размер переданного типа прямо в сообщении об ошибке для упрощения дебага. Но сделать мы этого не могли, даже константные выражения не могли использоваться.
До С++26, когда завезли константные выражения в сообщения об ошибках. После запятой может быть объект
msg, у которого должны быть 2 constexpr метода .data() для получения указателя на начало строки и .size() для получения размера.Это позволило использовать различные библиотеки форматирования внутри сообщения об ошибке. Например std::format:
template <class T>
void f() {
    static_assert( sizeof(T) == 4,
                   std::format("Type T size should be 4, actual: {}", sizeof(T)) );
}

int main() {
    f<std::int32_t>();
    f<std::int64_t>();
}
И это работает уже на gcc.
Так что внутри static_assert теперь разрешены любые выкрутасы, главное чтобы они были константными выражениями.
Be flexible. Stay cool.
#cpp26
❤27🔥12👍7❤🔥1
Какой метод не переопределяется?
#новичкам
Для начала. Что будет если не пометить переопределенный в дочернем классе метод как override?
Обычно говорят, что override генерирует проверку компилятора, что данный метод действительно переопределяет метод базового класса. И соотвественно ошибку в случае, если это не так.
Проверки - это дело важное и нужное, их нужно использовать. Но в том-то и дело, что override - это лишь проверка. Она никак не влияет на то, реально ли переопределяется метод или нет.
Взглядните на этот код:
Является ли метод foo в Derived переопределением метода из Base?
Казалось бы, нет пометок ни virtual, ни override.
Но это и не важно. Главное, чтобы сигнатура метода из дочернего класса была ровно такой же, какой была сигнатура виртуального метода в базовом классе. Здесь с этим все в порядке, поэтому метод действительно переопределяется..
То есть метод не переопределяется только в случае отличной сигнатуры. Поставьте в этом случае override и тогда будет ошибка компиляции. Поставьте в наследнике virtual и сделаете новый метод виртуальный метод в наследнике. Ничего не делаете и получите просто новый невиртуальный метод в наследнике.
Что же влияет на сигнатуру?
1️⃣ Имя функции и набор параметров. Это банально и все знают.
2️⃣ CV-квалификация метода. Грубо говоря, константный метод или нет.
3️⃣ Ref-квалификация метода. Говорили о них тут.
Если что-то из этого не соответствует виртуальному методу в родительском классе, то дочерний метод не будет переопределять родителя.
Use checks. Stay cool.
#cppcore
#новичкам
Для начала. Что будет если не пометить переопределенный в дочернем классе метод как override?
Обычно говорят, что override генерирует проверку компилятора, что данный метод действительно переопределяет метод базового класса. И соотвественно ошибку в случае, если это не так.
Проверки - это дело важное и нужное, их нужно использовать. Но в том-то и дело, что override - это лишь проверка. Она никак не влияет на то, реально ли переопределяется метод или нет.
Взглядните на этот код:
struct Base {
    virtual void foo(int i) const {
        std::cout << "Base" << std::endl;
    }
    virtual ~Base() = default;
};

struct Derived : Base {
    void foo(int) const {
        std::cout << "Derived" << std::endl;
    }
};

int main() {
    std::unique_ptr<Base> p = std::make_unique<Derived>();
    p->foo(42);
}
Является ли метод foo в Derived переопределением метода из Base?
Казалось бы, нет пометок ни virtual, ни override.
Но это и не важно. Главное, чтобы сигнатура метода из дочернего класса была ровно такой же, какой была сигнатура виртуального метода в базовом классе. Здесь с этим все в порядке, поэтому метод действительно переопределяется..
То есть метод не переопределяется только в случае отличной сигнатуры. Поставьте в этом случае override и тогда будет ошибка компиляции. Поставьте в наследнике virtual и сделаете новый метод виртуальный метод в наследнике. Ничего не делаете и получите просто новый невиртуальный метод в наследнике.
Что же влияет на сигнатуру?
1️⃣ Имя функции и набор параметров. Это банально и все знают.
2️⃣ CV-квалификация метода. Грубо говоря, константный метод или нет.
3️⃣ Ref-квалификация метода. Говорили о них тут.
Если что-то из этого не соответствует виртуальному методу в родительском классе, то дочерний метод не будет переопределять родителя.
Use checks. Stay cool.
#cppcore

❤13👍6🔥6
Ревью
#опытным
Как-то мы обходили стороной некоторые обновления в стандартной concurrency библиотеке С++.
Можно было бы начать прям сразу, но зайдем с небольшого интерактива в рамках рубрики #ревью.
Все просто: мы даем небольшой кусочек кода, а вы накидываетесь и оставляете комменты о том, что в этом коде на ваш взгляд не так. Все как в стандартном процессе кодревью.
Единственное, надо учитывать формат "небольшого кусочка кода", который тяжело сделать практически полезным.
Вот и сам код:
Комментатора с самым большим количеством корректно отмеченных проблем упомянем в завтрашнем посте с разбором.
Раз, два, три, код в порядок приведи!
Critique your decisions. Stay cool.
#опытным
Как-то мы обходили стороной некоторые обновления в стандартной concurrency библиотеке С++.
Можно было бы начать прям сразу, но зайдем с небольшого интерактива в рамках рубрики #ревью.
Все просто: мы даем небольшой кусочек кода, а вы накидываетесь и оставляете комменты о том, что в этом коде на ваш взгляд не так. Все как в стандартном процессе кодревью.
Единственное, надо учитывать формат "небольшого кусочка кода", который тяжело сделать практически полезным.
Вот и сам код:
#include <atomic>
#include <mutex>
#include <queue>
#include <thread>

struct Worker {
    Worker()
        : t([](std::stop_source st) {
              while (!st.stop_requested()) {
                  std::lock_guard<std::mutex> lock(m);
                  q.push(1);
              }
          }) {}

    std::thread t;
    std::mutex m;
    std::queue<int> q;
};

int main() {
    Worker w;
}
Комментатора с самым большим количеством корректно отмеченных проблем упомянем в завтрашнем посте с разбором.
Раз, два, три, код в порядок приведи!
Critique your decisions. Stay cool.

❤15👍6🔥4😁2❤🔥1
Результаты ревью
#опытным
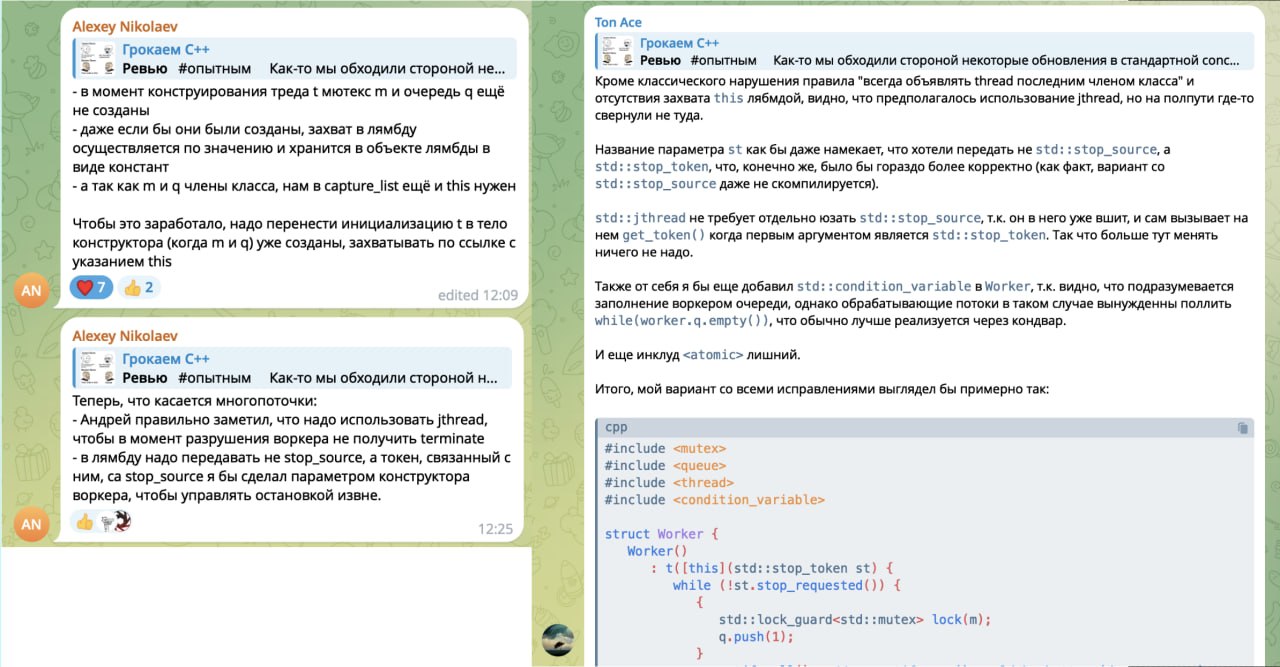
Спасибо всем комментаторам за актив и зоркие глаза! Да, да, ревью - это не только про знания, но еще и про умение замечать все мельчайшие недочеты. Но это лирика, погнали по проблемам. Напомню код:
Начнем с простых и дойдем до серьезных:
🔞 Лишний хэдэр, соответственно лишнее время, которое тратится при компиляции на его анализ.
🔞 Внутри коллбэка используются поля класса, при этом захват у лямбды по умолчанию. Эта штука не заработает без захвата this.
🔞 Зачем-то в цикле идет захват лока, хотя никакой реальной конкурентной обработки очереди в данном конкретном случае нет. Его просто можно выкинуть.
🔞 Поток-то мы создали, а завершаться он как будет? std::thread всегда нужно мануально завершать. Но вообще говоря, токены останова сильно намекают на jthread'ы, поэтому можно их использовать и все заведется.
🔞 Коллбэк запуска потоков принимает std::stop_source. Для того, чтобы механизм остановки через стоп-сигналы из С++20 работал, коллбэку std::jthread нужно принимать std::stop_token.
🔞 Ну и основная "нетривиальная" проблема в этом коде. При создании потока в списке инициализации мы захватываем по сути еще неготовый объект. Мьютекс и очередь еще даже по умолчанию не инициализированы. И поток вполне может запуститься со ссылкой на эти неинициализированные данные. А это уже UB.
🔞 В ту же колоду отходит проблема при разрушении объекта. Даже, если мы сделаем jthread и он сможет хоть как-то разрушиться. Вызовы деструкторов полей класса происходят в порядке обратном объявлению. А значит очередь и мьютекс разрушаться до вызова деструктора потока. Что опять же приводит к dangling reference и ub.
Пофиксить просто - объявляем поток в самом низу и дело в шляпе.
Вот исправленная версия:
Спасибо, @vm05s24 и @thonease за пристальное ревью)
Fix your flaws. Stay cool.
#опытным
Спасибо всем комментаторам за актив и зоркие глаза! Да, да, ревью - это не только про знания, но еще и про умение замечать все мельчайшие недочеты. Но это лирика, погнали по проблемам. Напомню код:
#include <atomic>
#include <mutex>
#include <queue>
#include <thread>

struct Worker {
    Worker()
        : t([](std::stop_source st) {
              while (!st.stop_requested()) {
                  std::lock_guard<std::mutex> lock(m);
                  q.push(1);
              }
          }) {}

    std::thread t;
    std::mutex m;
    std::queue<int> q;
};

int main() {
    Worker w;
}
Начнем с простых и дойдем до серьезных:
🔞 Лишний хэдэр, соответственно лишнее время, которое тратится при компиляции на его анализ.
🔞 Внутри коллбэка используются поля класса, при этом захват у лямбды по умолчанию. Эта штука не заработает без захвата this.
🔞 Зачем-то в цикле идет захват лока, хотя никакой реальной конкурентной обработки очереди в данном конкретном случае нет. Его просто можно выкинуть.
🔞 Поток-то мы создали, а завершаться он как будет? std::thread всегда нужно мануально завершать. Но вообще говоря, токены останова сильно намекают на jthread'ы, поэтому можно их использовать и все заведется.
🔞 Коллбэк запуска потоков принимает std::stop_source. Для того, чтобы механизм остановки через стоп-сигналы из С++20 работал, коллбэку std::jthread нужно принимать std::stop_token.
🔞 Ну и основная "нетривиальная" проблема в этом коде. При создании потока в списке инициализации мы захватываем по сути еще неготовый объект. Мьютекс и очередь еще даже по умолчанию не инициализированы. И поток вполне может запуститься со ссылкой на эти неинициализированные данные. А это уже UB.
🔞 В ту же колоду отходит проблема при разрушении объекта. Даже, если мы сделаем jthread и он сможет хоть как-то разрушиться. Вызовы деструкторов полей класса происходят в порядке обратном объявлению. А значит очередь и мьютекс разрушаться до вызова деструктора потока. Что опять же приводит к dangling reference и ub.
Пофиксить просто - объявляем поток в самом низу и дело в шляпе.
Вот исправленная версия:
#include <queue>
#include <thread>
struct Worker {
    Worker()
        : t([this](std::stop_token st) {
              while (!st.stop_requested()) {
                  q.push(1);
              }
          }) {}
    std::queue<int> q;
    std::jthread t;
};
int main() {
    Worker w;
}
Спасибо, @vm05s24 и @thonease за пристальное ревью)
Fix your flaws. Stay cool.
❤24🔥9👍7👎1
2 способа остановки воркеров
#опытным
Более менее всех опытные плюсовики знают классический подход к graceful остановке воркера. Это атомарный флаг, цикл внутри рабочей функции с проверкой и деструктор с установкой флага. Выглядит все примерно так:
Конечно, там нужно еще куча кода, чтобы заставить воркер полезную работу делать, но сейчас это не важно.
Важно, что есть тред и есть отдельная атомарная переменная, сигнализирующая об останове.
Но мы(и С++) выросли и появился новый инструмент останова воркера - std::jthread + std::stop_token.
Да. std::jthread - это не просто тред, который джойнится в деструкторе. Это тред с вшитой функциональностью остановки.
В отличие от std::thread, jthread содержит внутреннее приватное поле типа std::stop_source, которое хранит разделяемое состояние остановки потока. Из этого stop_source можно создать токены std::stop_token, через которые можно мониторить, остановится поток или нет. Грубо говоря, std::stop_source это ручка, за которую можно дернуть и перевести все ассоциированые с ней токены в состояние "остановка запрошена".
С токенами можно и отдельно работать, а можно использовать чисто внутри jthread.
Конструктор jthread принимает функцию, первым аргументом которой является std::stop_token; этот токен будет передан объектом jthread из его внутреннего std::stop_source. Это позволяет функции проверять во время выполнения, был ли запрошен останов, и завершаться, если запрос поступил.
Ручка std::stop_source дергается в момент вызова деструктора соответствующего jthread'а и сигнализирует всем токенам, что останов запрошен.
То есть начиная с С++20 механизм останова полностью встроен внутрь самого объекта и никаких дополнительных сущностей вводить не нужно.
Evolve. Stay cool.
#cpp20 #concurrency
#опытным
Более менее всех опытные плюсовики знают классический подход к graceful остановке воркера. Это атомарный флаг, цикл внутри рабочей функции с проверкой и деструктор с установкой флага. Выглядит все примерно так:
class Worker {
public:
    Worker() : t([this] {
        while (!stop_flag.load(std::memory_order_relaxed)) {
            std::cout << "Working\n";
            std::this_thread::sleep_for(std::chrono::milliseconds(100));
        }
        std::cout << "Stopped\n";
    }) {}
    ~Worker() {
        stop();
    }
    void stop() {
        stop_flag.store(true, std::memory_order_relaxed);
        if (t.joinable()) {
            t.join();
        }
    }
private:
    std::atomic<bool> stop_flag = false;
    std::thread t;
};
Конечно, там нужно еще куча кода, чтобы заставить воркер полезную работу делать, но сейчас это не важно.
Важно, что есть тред и есть отдельная атомарная переменная, сигнализирующая об останове.
Но мы(и С++) выросли и появился новый инструмент останова воркера - std::jthread + std::stop_token.
Да. std::jthread - это не просто тред, который джойнится в деструкторе. Это тред с вшитой функциональностью остановки.
В отличие от std::thread, jthread содержит внутреннее приватное поле типа std::stop_source, которое хранит разделяемое состояние остановки потока. Из этого stop_source можно создать токены std::stop_token, через которые можно мониторить, остановится поток или нет. Грубо говоря, std::stop_source это ручка, за которую можно дернуть и перевести все ассоциированые с ней токены в состояние "остановка запрошена".
С токенами можно и отдельно работать, а можно использовать чисто внутри jthread.
class Worker {
public:
    Worker() : t([this](std::stop_token st) {
        while (!st.stop_requested()) {
            // полезная работа...
            std::cout << "Working\n";
            std::this_thread::sleep_for(std::chrono::milliseconds(100));
        }
        std::cout << "Stopped cleanly\n";
    }) {}

    // Деструктор автоматически вызовет request_stop() и join()
private:
    std::jthread t;
};
Конструктор jthread принимает функцию, первым аргументом которой является std::stop_token; этот токен будет передан объектом jthread из его внутреннего std::stop_source. Это позволяет функции проверять во время выполнения, был ли запрошен останов, и завершаться, если запрос поступил.
Ручка std::stop_source дергается в момент вызова деструктора соответствующего jthread'а и сигнализирует всем токенам, что останов запрошен.
То есть начиная с С++20 механизм останова полностью встроен внутрь самого объекта и никаких дополнительных сущностей вводить не нужно.
Evolve. Stay cool.
#cpp20 #concurrency
🔥13❤7👍5
Базовые трейты объектов
#новичкам
Трейты(или свойства объектов) - мощнейший инструмент проверки требований для исполнения кода. Вы явно в апи через sfinae или концепты можете задавать ограничения на множество типов, с которыми хотите работать, производя проверку в compile-time.
Сегодня обсудим для самой простой структуры, какими свойствами классов она удовлетворяет. Чисто, чтобы вкатиться в базовые стандартные трейты.
Проверить свойства типа можно довольно просто. static_assert + использование самого трейта:
Вообще эти трейты - это некая шаблонные структуры. У них есть статический constexpr член value, который обращается в true, если свойство присутствует у типа, и в false если нет.
Для каждого трейта определен вспомогательный шаблон переменной с суффиктом
Ну и по порядку:
✅ is_class.
✅ is_aggregate. С агрегатами можно использовать инициализацию членов через список инициализации внутри {}.
✅ is_standard_layout. Очень упрощая, ваш класс не имеет виртуальных функций, все поля также являются standard_layout с одинаковым модификатором доступа и у него нет базовых классов.
✅ is_trivially_copyable. Класс имеет хотя бы один копирующий или перемещающий специальный метод и все они сгенерированы компилятором.
✅ is_trivially_destructible, is_trivially_copy_constructible,is_trivially_move_constructible, is_trivially_copy_assignable, is_trivially_move_assignable_v - соответствующий специальный метод должен быть сгенерирован компилятором.
Есть также версия без trivially, которая просто проверяет наличие операции в классе.
✅ is_trivially_default_constructible - дефолтный конструктор сгенерен компилятором и внутри него не выполняется никакой код(все поля типа должны иметь тривиальный дефолтный контруктор, то есть состоять только из тривиальных типов).
✅ is_object - Все, что не ссылка, не функция и не
✅ is_compound - указатели, ссылки, массивы, функции, классы и объединения, перечисления, и их cv-квалификации.
Дальше пойдут трейты, которым не удовлетворяет простая структура:
🙈 is_empty - имеет хотя бы одно нестатическое поле.
🙈 is_polymorphic - есть хотя бы одна виртуальная функция
🙈 is_fundamental_v - арифметические типы, void и
🙈 is_scalar - все, что можно представить числом. Числа, указатели, перечисления.
В следующем посте можем обсудить, как ситуация изменится, если чуть подкрутить начальную структуру.
Know your traits. Stay cool.
#template #cppcore
#новичкам
Трейты(или свойства объектов) - мощнейший инструмент проверки требований для исполнения кода. Вы явно в апи через sfinae или концепты можете задавать ограничения на множество типов, с которыми хотите работать, производя проверку в compile-time.
Сегодня обсудим для самой простой структуры, какими свойствами классов она удовлетворяет. Чисто, чтобы вкатиться в базовые стандартные трейты.
Проверить свойства типа можно довольно просто. static_assert + использование самого трейта:
struct A {
    int a;
    int b;
    int c;
};

// --- true ---
static_assert(std::is_class_v<A>, "A is a class");
static_assert(std::is_aggregate_v<A>, "A is aggregate");
static_assert(std::is_standard_layout_v<A>, "A is standard-layout");

static_assert(std::is_trivially_copyable_v<A>, "A is trivially copyable");
static_assert(std::is_trivially_destructible_v<A>, "A trivially destructible");
static_assert(std::is_trivially_copy_constructible_v<A>, "A trivial copy ctor");
static_assert(std::is_trivially_move_constructible_v<A>, "A trivial move ctor");
static_assert(std::is_trivially_copy_assignable_v<A>, "A trivial copy assign");
static_assert(std::is_trivially_move_assignable_v<A>, "A trivial move assign");

static_assert(std::is_default_constructible_v<A>, "A default constructible");
static_assert(std::is_trivially_default_constructible_v<A>, "A trivial default ctor");

static_assert(std::is_object_v<A>, "A is object");
static_assert(std::is_compound_v<A>, "A is compound");

// --- false ---
static_assert(!std::is_empty_v<A>, "A is NOT empty (has members)");
static_assert(!std::is_polymorphic_v<A>, "A is NOT polymorphic");
static_assert(!std::is_fundamental_v<A>, "A is NOT fundamental");
static_assert(!std::is_scalar_v<A>, "A is NOT scalar");
Вообще эти трейты - это некая шаблонные структуры. У них есть статический constexpr член value, который обращается в true, если свойство присутствует у типа, и в false если нет.
Для каждого трейта определен вспомогательный шаблон переменной с суффиктом
_v, который хранит непосредственно булево значение.Ну и по порядку:
✅ is_class.
A действительно является полноценным классом с точки зрения С++. Структуры и классы в этом смысле не отличаются.✅ is_aggregate. С агрегатами можно использовать инициализацию членов через список инициализации внутри {}.
✅ is_standard_layout. Очень упрощая, ваш класс не имеет виртуальных функций, все поля также являются standard_layout с одинаковым модификатором доступа и у него нет базовых классов.
✅ is_trivially_copyable. Класс имеет хотя бы один копирующий или перемещающий специальный метод и все они сгенерированы компилятором.
✅ is_trivially_destructible, is_trivially_copy_constructible,is_trivially_move_constructible, is_trivially_copy_assignable, is_trivially_move_assignable_v - соответствующий специальный метод должен быть сгенерирован компилятором.
Есть также версия без trivially, которая просто проверяет наличие операции в классе.
✅ is_trivially_default_constructible - дефолтный конструктор сгенерен компилятором и внутри него не выполняется никакой код(все поля типа должны иметь тривиальный дефолтный контруктор, то есть состоять только из тривиальных типов).
✅ is_object - Все, что не ссылка, не функция и не
void, то объект. Интересно, что A - это и класс, и объект. Вот такое ООП в плюсах, которые мы заслужили.✅ is_compound - указатели, ссылки, массивы, функции, классы и объединения, перечисления, и их cv-квалификации.
Дальше пойдут трейты, которым не удовлетворяет простая структура:
🙈 is_empty - имеет хотя бы одно нестатическое поле.
🙈 is_polymorphic - есть хотя бы одна виртуальная функция
🙈 is_fundamental_v - арифметические типы, void и
std::nullptr_t.🙈 is_scalar - все, что можно представить числом. Числа, указатели, перечисления.
В следующем посте можем обсудить, как ситуация изменится, если чуть подкрутить начальную структуру.
Know your traits. Stay cool.
#template #cppcore

👍16❤9🔥8
Базовые трейты объектов. Ч2
#новичкам
В прошлый раз у нас была довольно простая С-like структура, для которой мы смотрели стандартные свойства.
Сегодня посмотрим, какие свойства типа изменятся, если совсем чуть-чуть изменить структуру.
🔀 Добавим просто std::string в качестве поля структуры.
Из-за того, что у std::string нетривиальные специальное методы классов, то это автоматически делает нетривиальными специальные методы у
🔀 Добавим виртуальный метод
Очевидно, тип сразу же стал полиморфным. Но и много чего потерял. Чисто по определению некоторых свойств полиморфный тип не может им удовлетворять. Это:
👉🏿 std::is_standard_layout - грубо говоря, тип становится невместим с С
👉🏿 std::is_trivially_copyable - тривиальное копирование подразумевает простое копирование по байтам. Копирование полиморфного типа нельзя производить побайтово. Компилятор обязан либо скопировать vptr как есть (если это тот же тип), либо установить правильный vptr нового типа (если копируем через базовый класс — slicing). Это уже нетривиальная логика.
👉🏿 std::is_trivially_default_constructible - конструктор по умолчанию не тривиальный, так как надо инициализировать vptr в правильную vtable.
👉🏿 std::is_aggregate - как только у класса появляется приватный метод(vptr в данном случае), он уже не может быть агрегатом.
🔀 Более менее понятно, что будет, если добавить пользовательский конструктор. А что если добавить кастомный деструктор?
Он никак не влияет на layout объекта и на способность объекта быть созданным агрегацией. Однако объект перестает быть тривиально копируемым и создаваемым копией или перемещением. С перемещением понятно - оно не генерится с кастомным деструктором.
А с копированием интересно. Стандарт говорит, что при установке требований на создание объекта нужно учитывать и разрушение объекта. Поэтому объект типа А нельзя создать тривиально копией(хотя конструктор копирования продолжает генериться компилятором и быть тривиальным).
Для is_trivially_copyable нужен дефолтный деструктор, чтобы не было никакой дополнительной логики освобождения ресурсов при побайтовом копировании одного объекта в другой.
Это все звучит, как ненужные и неважные детали. Но мы здесь грокаем С++. И просто интересно, почему, с точки зрения архитектуры языка, ломается тривиальность дефолтного конструктора при добавлении виртуальной функции.
Know your traits. Stay cool.
#template #cppcore
#новичкам
В прошлый раз у нас была довольно простая С-like структура, для которой мы смотрели стандартные свойства.
struct A {
    int a;
    int b;
    int c;
};
Сегодня посмотрим, какие свойства типа изменятся, если совсем чуть-чуть изменить структуру.
🔀 Добавим просто std::string в качестве поля структуры.
struct A {
    int a;
    int b;
    int c;
    std::string s;
};
Из-за того, что у std::string нетривиальные специальное методы классов, то это автоматически делает нетривиальными специальные методы у
A, поэтому отличие будет только в следующих трейтах:static_assert(!std::is_trivially_copyable_v<A>);
static_assert(!std::is_trivially_destructible_v<A>);
static_assert(!std::is_trivially_copy_constructible_v<A>);
static_assert(!std::is_trivially_move_constructible_v<A>);
static_assert(!std::is_trivially_copy_assignable_v<A>);
static_assert(!std::is_trivially_move_assignable_v<A>);
static_assert(!std::is_trivially_default_constructible_v<A>);
🔀 Добавим виртуальный метод
struct A {
    int a;
    int b;
    int c;
    virtual void foo() {}
};
Очевидно, тип сразу же стал полиморфным. Но и много чего потерял. Чисто по определению некоторых свойств полиморфный тип не может им удовлетворять. Это:
👉🏿 std::is_standard_layout - грубо говоря, тип становится невместим с С
👉🏿 std::is_trivially_copyable - тривиальное копирование подразумевает простое копирование по байтам. Копирование полиморфного типа нельзя производить побайтово. Компилятор обязан либо скопировать vptr как есть (если это тот же тип), либо установить правильный vptr нового типа (если копируем через базовый класс — slicing). Это уже нетривиальная логика.
👉🏿 std::is_trivially_default_constructible - конструктор по умолчанию не тривиальный, так как надо инициализировать vptr в правильную vtable.
👉🏿 std::is_aggregate - как только у класса появляется приватный метод(vptr в данном случае), он уже не может быть агрегатом.
static_assert(std::is_polymorphic_v<Poly>);
static_assert(!std::is_standard_layout_v<Poly>);
static_assert(!std::is_trivially_copyable_v<Poly>);
static_assert(!std::is_trivially_default_constructible_v<Poly>);
static_assert(!std::is_aggregate_v<Poly>);
🔀 Более менее понятно, что будет, если добавить пользовательский конструктор. А что если добавить кастомный деструктор?
struct A {
    int a;
    int b;
    int c;
    ~A() {}
};

static_assert(!std::is_trivially_destructible_v<A>);
static_assert(!std::is_trivially_copyable_v<A>);
static_assert(!std::is_trivially_copy_constructible_v<A>);
static_assert(!std::is_trivially_move_constructible_v<A>);
static_assert(std::is_aggregate_v<A>);
static_assert(std::is_standard_layout_v<A>);
Он никак не влияет на layout объекта и на способность объекта быть созданным агрегацией. Однако объект перестает быть тривиально копируемым и создаваемым копией или перемещением. С перемещением понятно - оно не генерится с кастомным деструктором.
А с копированием интересно. Стандарт говорит, что при установке требований на создание объекта нужно учитывать и разрушение объекта. Поэтому объект типа А нельзя создать тривиально копией(хотя конструктор копирования продолжает генериться компилятором и быть тривиальным).
Для is_trivially_copyable нужен дефолтный деструктор, чтобы не было никакой дополнительной логики освобождения ресурсов при побайтовом копировании одного объекта в другой.
Это все звучит, как ненужные и неважные детали. Но мы здесь грокаем С++. И просто интересно, почему, с точки зрения архитектуры языка, ломается тривиальность дефолтного конструктора при добавлении виртуальной функции.
Know your traits. Stay cool.
#template #cppcore
👍11❤8🔥4
Безопасный memcpy
#новичкам
memcpy — это один из самых быстрых способов скопировать данные и один из самых быстрых способов получить UB. Функция принимает
В прошлых постах мы поговорили о трейтах. Для заданного типа они определяют, обладает ли тип определенным свойством или нет.
Давайте применим трейты на практике. Ограничим через них доступ к самописной обертке memcpy.
И в этом нам помогут концепты. Если трейты - это свойство типа, то концепт - это требование для типа.
Определим концепт, который требует, чтобы тип был объектом(не функцией и не ссылкой) и был тривиально копируемым:
И вот теперь мы говорим в шаблонном функции, что хотим потребовать от типа выполнения условия SafeForMemcpy. Это можно сделать разными способами, вот самый простой:
Вместо ключевых слов
Теперь при использовании нетривиально копируемых типов будет появляться ошибка компиляции с нормальным сообщением о том, что тип не удовлетворяет концепту.
В будущих постах будет разбирать концепты чуть подробнее.
Require the best conditions. Stay cool.
#cpp20 #template
#новичкам
memcpy — это один из самых быстрых способов скопировать данные и один из самых быстрых способов получить UB. Функция принимает
void* и size_t и радостно съест всё, что вы ей дадите: полиморфный тип, std::string, объект с нетривиальным деструктором. Компилятор не скажет ни слова, а программа сломается в самом неожиданном месте.В прошлых постах мы поговорили о трейтах. Для заданного типа они определяют, обладает ли тип определенным свойством или нет.
Давайте применим трейты на практике. Ограничим через них доступ к самописной обертке memcpy.
И в этом нам помогут концепты. Если трейты - это свойство типа, то концепт - это требование для типа.
Определим концепт, который требует, чтобы тип был объектом(не функцией и не ссылкой) и был тривиально копируемым:
template <typename T>
concept SafeForMemcpy = std::is_object_v<T> && std::is_trivially_copyable_v<T>;
И вот теперь мы говорим в шаблонном функции, что хотим потребовать от типа выполнения условия SafeForMemcpy. Это можно сделать разными способами, вот самый простой:
template <SafeForMemcpy T>
void safe_memcpy(T* dest, const T* src) {
    static_assert(sizeof(T) > 0, "Cannot copy incomplete type");
    std::memcpy(dest, src, sizeof(T));
}
Вместо ключевых слов
typename или class используется имя концепта. Теперь при использовании нетривиально копируемых типов будет появляться ошибка компиляции с нормальным сообщением о том, что тип не удовлетворяет концепту.
В будущих постах будет разбирать концепты чуть подробнее.
Require the best conditions. Stay cool.
#cpp20 #template

❤25👍12🔥7
std::find vs std::ranges::find
#опытным
С++20 библиотека диапазонов принесла нам много новых полезных алгоритмов и способов управления данными. Но не только это. Рэнджи задублировали и привычные нам "древние" стандартные алгоритмы.
Хотя кажется "что какая разница, использовать новое апи или старое?" - разница все-таки есть. И сегодня поговорим об одном конкретном кейсе.
Что делает std::find? Ищет элемент в промежутке между итератором начала и конца последовательности и возвращает на него итератор на этот элемент:
Если элемент не найден, то find просто возвращает итератор на конец диапазона.
Ровно такую же строчку можно написать с std::ranges::find и это заработает:
Однако здесь открываются новые возможности. Все потому, что второй аргумент алгоритм - конец диапазона - не обязан быть того же типа, что и итератор начала:
По шаблонным параметрам видно, что во втором случае first и last могут быть разных типов, в отличие от std::find.
Это позволяет использовать кастомный тип ограничителя последовательности, который позволит сделать поиск несколько эффективнее.
std::find реализован примерно вот так:
На каждой итерации цикла идет проверка, не дошли ли мы до конца. Это нужно, чтобы мы не вышли за границы последовательности при поиске.
Но что, если у нас данные в таком формате, что мы точно знаем о существовании там нужного элемента?
Пусть мы парсим какие-то данные в заданном формате. Например, csv. Мы четко знаем, что между элементами всегда есть разделитель. Это либо запятая, либо символ конца строки.
При чтении каждого отдельного элемента мы точно знаем, что он закончится либо запятой, либо символом конца строки. В этом случае при поиске разделителя мы точно не выйдем за границы диапазона, ведь мы четко знаем, что он там будет.
В этом случае было бы довольно полезным просто выкинуть проверку на окончание диапазона. Это бы дано очень несущественный, но все же импакт в скорость программы, особенно для больших файлов.
И ограничитель std::unreachable_sentinel фактически позволяет это сделать. Причина в том, что операция проверки на равенство для него всегда возвращает false.
И хоть алгоритм std::ranges::find не сильно отличается по реализации от std::find (там тоже есть проверка конца последовательности), компилятор видит, что проверка конца всегда возвращает false и выкидывает ее из кода.
Таким образом мы экономим одну операцию при проверке очередного элемента последовательности.
Однако здесь есть очевидная проблема. Если нужный элемент по какой-то причине не будет найден в пределах заданного диапазона, то мы получаем выход за границы и выстрел UB в упор. Поэтому использовать std::unreachable_sentinel нужно очень осторожно и только в случае полной уверенности в формате данных.
Be sure. Stay cool.
#cpp20 #optimization
#опытным
С++20 библиотека диапазонов принесла нам много новых полезных алгоритмов и способов управления данными. Но не только это. Рэнджи задублировали и привычные нам "древние" стандартные алгоритмы.
Хотя кажется "что какая разница, использовать новое апи или старое?" - разница все-таки есть. И сегодня поговорим об одном конкретном кейсе.
Что делает std::find? Ищет элемент в промежутке между итератором начала и конца последовательности и возвращает на него итератор на этот элемент:
auto it = std::find(vec.begin(), vec.end(), 42);
Если элемент не найден, то find просто возвращает итератор на конец диапазона.
Ровно такую же строчку можно написать с std::ranges::find и это заработает:
auto it = std::ranges::find(vec.begin(), vec.end(), 42);
Однако здесь открываются новые возможности. Все потому, что второй аргумент алгоритм - конец диапазона - не обязан быть того же типа, что и итератор начала:
// std::find
template< class InputIt, class T >
InputIt find( InputIt first, InputIt last, const T& value );

// std::ranges::find
template< std::input_iterator I, std::sentinel_for<I> S,
          class T, class Proj = std::identity >
    requires std::indirect_binary_predicate
                 <ranges::equal_to, std::projected<I, Proj>, const T*>
constexpr I find( I first, S last, const T& value, Proj proj = {} );
По шаблонным параметрам видно, что во втором случае first и last могут быть разных типов, в отличие от std::find.
Это позволяет использовать кастомный тип ограничителя последовательности, который позволит сделать поиск несколько эффективнее.
std::find реализован примерно вот так:
template<class InputIt, class T = typename std::iterator_traits<InputIt>::value_type>
constexpr InputIt find(InputIt first, InputIt last, const T& value)
{
    for (; first != last; ++first)
        if (*first == value)
            return first;

    return last;
}
На каждой итерации цикла идет проверка, не дошли ли мы до конца. Это нужно, чтобы мы не вышли за границы последовательности при поиске.
Но что, если у нас данные в таком формате, что мы точно знаем о существовании там нужного элемента?
Пусть мы парсим какие-то данные в заданном формате. Например, csv. Мы четко знаем, что между элементами всегда есть разделитель. Это либо запятая, либо символ конца строки.
При чтении каждого отдельного элемента мы точно знаем, что он закончится либо запятой, либо символом конца строки. В этом случае при поиске разделителя мы точно не выйдем за границы диапазона, ведь мы четко знаем, что он там будет.
В этом случае было бы довольно полезным просто выкинуть проверку на окончание диапазона. Это бы дано очень несущественный, но все же импакт в скорость программы, особенно для больших файлов.
И ограничитель std::unreachable_sentinel фактически позволяет это сделать. Причина в том, что операция проверки на равенство для него всегда возвращает false.
template<std::weakly_incrementable I>
friend constexpr bool operator==( unreachable_sentinel_t, const I& ) noexcept
{ return false; }
И хоть алгоритм std::ranges::find не сильно отличается по реализации от std::find (там тоже есть проверка конца последовательности), компилятор видит, что проверка конца всегда возвращает false и выкидывает ее из кода.
Таким образом мы экономим одну операцию при проверке очередного элемента последовательности.
Однако здесь есть очевидная проблема. Если нужный элемент по какой-то причине не будет найден в пределах заданного диапазона, то мы получаем выход за границы и выстрел UB в упор. Поэтому использовать std::unreachable_sentinel нужно очень осторожно и только в случае полной уверенности в формате данных.
Be sure. Stay cool.
#cpp20 #optimization

❤11👍7🔥5
Виртуальный шаблонный метод
#опытным
Во влажных мечтах С++ программистов всегда находится место для возможностей одновременного использования статического и динамического полиморфизмов. И тут прям напрашивается иметь виртуальный шаблонный метод. Давайте напишем:
Выглядит привычно, пробуем скомпилировать.... И оно не билдится.
С++ не разрешает вам иметь виртуальный шаблонный метод.
Но почему?
Надо понимать, как под капотом работают виртуальные и шаблонные функции.
При определении шаблона, никакой низкоуровневый код не генерируется. Код генерируется только, когда компилятор видит использование шаблона с каким-то конкретным типом. Подробнее можно тут почитать.
Так вот реальный код инстанциаций шаблона может быть раскидан по очень большому множеству единиц трансляции.
Теперь про виртуальные функции. В абсолютном большинстве компиляторов они реализованы через vtable. Подробнее тут. Но вкратце: во время компиляции класса с виртуальным формируется статический массив, состоящий из адресов скомпилированных виртуальных методов. Порядок нахождения в массиве определяется порядком объявления методов в классе.
Почему вообще возможна такая генерация? Потому что компилятор уже в этой конкретной единице трансляции знает весь набор виртуальных методов в базовом классе и в наследнике. Поэтому он заранее может выбрать правильный размер vtable.
Теперь пытаемся совместить. Для генерации vtable на этапе компиляции нам нужно знать весь набор виртульных методов. И это прямо противоречит тому факту, что шаблон ничего не знает о своих потенциальных инстанциациях, которые разбросаны по куче единиц трансляции. Каждая единица трансляции компилируется независимо, поэтому получить информацию об адресах конкретных инстанциаций из других TU невозможно.
Хорошо, что в С++ есть множество других инструментов и концепций, которые помогут решить вашу техническую проблему в без виртуальных шаблонных методов. Это type erasure, crtp, visitor, std::function и std::any.
Combine the incompatible. Stay cool.
#cppcore #interview
#опытным
Во влажных мечтах С++ программистов всегда находится место для возможностей одновременного использования статического и динамического полиморфизмов. И тут прям напрашивается иметь виртуальный шаблонный метод. Давайте напишем:
struct Base
{
    template <typename T>
    virtual void do_something(T arg) = 0;

    virtual ~Base() = default;
};

struct Derived : Base
{
    template <typename T>
    void do_something(T arg) override
    {
        // do something
    }
};
Выглядит привычно, пробуем скомпилировать.... И оно не билдится.
С++ не разрешает вам иметь виртуальный шаблонный метод.
Но почему?
Надо понимать, как под капотом работают виртуальные и шаблонные функции.
При определении шаблона, никакой низкоуровневый код не генерируется. Код генерируется только, когда компилятор видит использование шаблона с каким-то конкретным типом. Подробнее можно тут почитать.
Так вот реальный код инстанциаций шаблона может быть раскидан по очень большому множеству единиц трансляции.
Теперь про виртуальные функции. В абсолютном большинстве компиляторов они реализованы через vtable. Подробнее тут. Но вкратце: во время компиляции класса с виртуальным формируется статический массив, состоящий из адресов скомпилированных виртуальных методов. Порядок нахождения в массиве определяется порядком объявления методов в классе.
Почему вообще возможна такая генерация? Потому что компилятор уже в этой конкретной единице трансляции знает весь набор виртуальных методов в базовом классе и в наследнике. Поэтому он заранее может выбрать правильный размер vtable.
Теперь пытаемся совместить. Для генерации vtable на этапе компиляции нам нужно знать весь набор виртульных методов. И это прямо противоречит тому факту, что шаблон ничего не знает о своих потенциальных инстанциациях, которые разбросаны по куче единиц трансляции. Каждая единица трансляции компилируется независимо, поэтому получить информацию об адресах конкретных инстанциаций из других TU невозможно.
Хорошо, что в С++ есть множество других инструментов и концепций, которые помогут решить вашу техническую проблему в без виртуальных шаблонных методов. Это type erasure, crtp, visitor, std::function и std::any.
Combine the incompatible. Stay cool.
#cppcore #interview
❤15👍5🔥4
std::source_location
#новичкам
Если вы до сих пор не знали, как платформонезависимо(безо всяких PRETTY_FUNCTION) получать человеческий доступ к имени файла, имени функции и строчке кода, где вы сейчас находитесь, то пост для вас.
В С++20 появился класс std::source_location, который инкапсулирует в себе информацию о точке исходного кода, где был создан соответствующий объект.
Применение до боли простое. У класса есть набор методов, которые в сумме и дают понимание о том, где был создан объект. Вы просто создаете объект через единственный статический метод std::source_location::current и получаете, что нужно. Пример:
В момент вызова функции log компилятор должен вычислить все параметры, переданные в функцию. Поэтому параметр location с дефолтным параметром std::source_location::current() как раз и делает нужный трюк - location неявно присваивается расположение вызова функции в коде всякий раз, когда кто-то ее дергает.
После чего нужно сериализовать location через вызовы методов в нужном порядке и вуаля, красивый лог:
В больших фреймворках, типа userver вам конечно же не нужно о таком беспокоиться. Но если вы пилите что-то свое кастомное, то std::source_location - хорошая тула для дебаггинга и логирования.
Define your place. Stay cool.
#cpp20
#новичкам
Если вы до сих пор не знали, как платформонезависимо(безо всяких PRETTY_FUNCTION) получать человеческий доступ к имени файла, имени функции и строчке кода, где вы сейчас находитесь, то пост для вас.
В С++20 появился класс std::source_location, который инкапсулирует в себе информацию о точке исходного кода, где был создан соответствующий объект.
Применение до боли простое. У класса есть набор методов, которые в сумме и дают понимание о том, где был создан объект. Вы просто создаете объект через единственный статический метод std::source_location::current и получаете, что нужно. Пример:
#include <iostream>
#include <source_location>
#include <string_view>

void log(const std::string_view message,
         const std::source_location location =
               std::source_location::current()) {
    std::clog << "file: "
              << location.file_name() << '('
              << location.line() << ':'
              << location.column() << ") `"
              << location.function_name() << "`: "
              << message << '\n';
}

int main() {
    log("Hello world!");
}
В момент вызова функции log компилятор должен вычислить все параметры, переданные в функцию. Поэтому параметр location с дефолтным параметром std::source_location::current() как раз и делает нужный трюк - location неявно присваивается расположение вызова функции в коде всякий раз, когда кто-то ее дергает.
После чего нужно сериализовать location через вызовы методов в нужном порядке и вуаля, красивый лог:
file: /app/example.cpp(17:8) int main(): Hello world!
В больших фреймворках, типа userver вам конечно же не нужно о таком беспокоиться. Но если вы пилите что-то свое кастомное, то std::source_location - хорошая тула для дебаггинга и логирования.
Define your place. Stay cool.
#cpp20
❤20👍10🔥5🐳1
Агенты добрались до продакшена
Про AI-агентов сейчас не говорит только ленивый. Обычно это выглядит так: «мы прикрутили LLM, дали ей пару тулов, теперь она сама все делает».
А потом это пытаются выкатить в прод, и внезапно оказывается, что агент — это не чатик с промптом, а распределенная система с дорогущими GPU, долгими запросами, динамическим графом исполнения, ретраями, которые нельзя просто так делать, и метриками качества, которые надо в принципе уметь измерять и делать это каждый день.
На недавнем deep tech night прошел показательный доклад «От поиска к агентам: путь Алисы», который я глянул.
Круто, когда говорят не про то, как ллм и агенты делают космолеты, а какие вызовы несет в себе их использование и как сделать работу с языковыми моделями надежной, отслеживаемой и универсальной в рамках большой компании.
Изыскания ребят привели их к AGTS - агентской транспортной системе.
Если коротко, это сервис-медиатор между агентами, тулами и моделями. Все общаются не напрямую друг с другом, а через AGTS.
И вот тут начинается нормальный backend:
🔸 агенты и тулы могут быть написаны на разных языках — Python, C++, Java/Kotlin, Go;
🔸 можно переиспользовать одну инфраструктуру для прода и приемки качества;
🔸 есть «железные пользователи» — агенты, которые имитируют пользовательское поведение;
🔸 LLM-as-a-judge - модели оценки качества "услуг агентов" - тоже живут как агенты на той же платформе;
🔸 AGTS кэширует запросы и ответы к моделям и тулам, чтобы при сбое не перезапускать всю дорогую LLM-мясорубку с нуля.
Последний пункт особенно важен.
Агент упал не в самом начале, а где-нибудь на пятой минуте размышлений? Не надо снова жечь GPU и молиться. Система делает fast-forward по закэшированным данным до точки падения и продолжает оттуда.
Пожалуй один из главных поинтов доклада: harness > model.
То есть качество можно серьезно растить не только заменой модели на новую большую и дорогую, а обвязкой вокруг нее. И эти обвязки централизовано добавляются и управляются в AGTS.
Вот некоторые достижения харнесса:
🔥 +9 п.п. на BrowseComp за счет фильтрации поисковой выдачи перед подачей в модель;
🔥 +8,5 п.п. на GAIA после добавления работы с файлами, мультимодальности и OCR;
🔥 стоимость запроса снизили в 6,6 раза;
🔥 latency p90 ужали с 30 минут до 2,5 минут;
🔥 GPU на проде стало нужно в 5 раз меньше.
В общем, очень ценный доклад именно с точки зрения раскрытия внутрянки такой сложной системы. Без AI мы уже никуда, но включение человека всё еще необходимо, чтобы заставить его работать с профитом и предсказуемостью на больших масштабах.
Про AI-агентов сейчас не говорит только ленивый. Обычно это выглядит так: «мы прикрутили LLM, дали ей пару тулов, теперь она сама все делает».
А потом это пытаются выкатить в прод, и внезапно оказывается, что агент — это не чатик с промптом, а распределенная система с дорогущими GPU, долгими запросами, динамическим графом исполнения, ретраями, которые нельзя просто так делать, и метриками качества, которые надо в принципе уметь измерять и делать это каждый день.
На недавнем deep tech night прошел показательный доклад «От поиска к агентам: путь Алисы», который я глянул.
Круто, когда говорят не про то, как ллм и агенты делают космолеты, а какие вызовы несет в себе их использование и как сделать работу с языковыми моделями надежной, отслеживаемой и универсальной в рамках большой компании.
Изыскания ребят привели их к AGTS - агентской транспортной системе.
Если коротко, это сервис-медиатор между агентами, тулами и моделями. Все общаются не напрямую друг с другом, а через AGTS.
И вот тут начинается нормальный backend:
🔸 агенты и тулы могут быть написаны на разных языках — Python, C++, Java/Kotlin, Go;
🔸 можно переиспользовать одну инфраструктуру для прода и приемки качества;
🔸 есть «железные пользователи» — агенты, которые имитируют пользовательское поведение;
🔸 LLM-as-a-judge - модели оценки качества "услуг агентов" - тоже живут как агенты на той же платформе;
🔸 AGTS кэширует запросы и ответы к моделям и тулам, чтобы при сбое не перезапускать всю дорогую LLM-мясорубку с нуля.
Последний пункт особенно важен.
Агент упал не в самом начале, а где-нибудь на пятой минуте размышлений? Не надо снова жечь GPU и молиться. Система делает fast-forward по закэшированным данным до точки падения и продолжает оттуда.
Пожалуй один из главных поинтов доклада: harness > model.
То есть качество можно серьезно растить не только заменой модели на новую большую и дорогую, а обвязкой вокруг нее. И эти обвязки централизовано добавляются и управляются в AGTS.
Вот некоторые достижения харнесса:
🔥 +9 п.п. на BrowseComp за счет фильтрации поисковой выдачи перед подачей в модель;
🔥 +8,5 п.п. на GAIA после добавления работы с файлами, мультимодальности и OCR;
🔥 стоимость запроса снизили в 6,6 раза;
🔥 latency p90 ужали с 30 минут до 2,5 минут;
🔥 GPU на проде стало нужно в 5 раз меньше.
В общем, очень ценный доклад именно с точки зрения раскрытия внутрянки такой сложной системы. Без AI мы уже никуда, но включение человека всё еще необходимо, чтобы заставить его работать с профитом и предсказуемостью на больших масштабах.
🔥7❤3👍3
Identity объекта
#опытным
На пространстве интернетов мне попался шортс, где довольно опытный в С++ чувак рассказывает про некий "трюк" в контексте такой задачи:
трюк в том, что если вам нужен идентификатор объекта, то вы можете использовать его уникальный адрес. Приводился такой пример:
Выглядит с первого взгляда круто. Действительно, у каждого объекта свой уникальный адрес. Два объекта в программе не могут занимать одну ячейку памяти. Получается, что адрес можно использовать как id и это "просто работает".
Только вот сходу можно назвать кучу проблем, к которому ведет этот подход:
🔞 id объекта меняется, если он перемещается
🔞 id объекта меняется, если он копируется(должны ли такие объекты копироваться и перемещать вообще - это вопрос, но проблемы остаются)
🔞 такой айди тесно связан с временем жизни объекта и не существует о отрыве объекта в программе
🔞 id переиспользуется другими объектами и на стеке, и на куче. Как только разрушился объект, новый объект может получить тот же самый id. И как различить объекты в таком случае непонятно.
🔞 id нельзя безопасно использовать как внешний идентификатор, аля передавать в другие сервисы или сохранять в хранилища.
Я понимаю, что скорее всего на интервью, где-то в отдельных модулях приложения или в каких-то игрушечных проектах такой подход может сработать. Но в каких-то больших распределенных системах вряд ли. Хотя мир большой и вы в комментариях расскажете, где такой подход применяется на практике.
Если хочется что-то простое и на коленке сделанное, то можно использовать приватный статический(потенциально атомарный) счетчик внутри класса и при создании объекта инкрементировать его:
При копировании, мувах Id не меняется(но это можно исправить, если надо), а чтобы новый объект заимел тот же айди нужно 100500 лет.
Однако при рестарте приложения, счетчик все еще обнуляется и будут дубли. Если вам критично, чтобы не существовало двух объектов с одинаковым id, можно использовать UUIDv7. Там 2¹²² вариантов айдишников, вероятностью совпадения при использовании uuid обычно пренебрегают.
Have your own identity. Stay cool.
#design
#опытным
На пространстве интернетов мне попался шортс, где довольно опытный в С++ чувак рассказывает про некий "трюк" в контексте такой задачи:
По сути, нужно построить центральный сервис, который отправляет обновления цен на станции, но новые желаемые цены могут поступать, пока старые обновления ещё в пути. Вас волнует только то, чтобы каждая станция в конечном итоге получила самую последнюю желаемую цену, при этом подтверждения (acknowledgements) должны приходить по порядку, а лишние обновления следует избегать. Таким образом, обновления, которые вы отправляете, могут прибывать на станцию не по порядку, но подтверждения, которые вы получаете обратно, всегда должны быть правильно упорядочены в том порядке, в котором станция применила обновление цены. И, по сути, спроектировать класс так, чтобы минимизировать время и тд.
трюк в том, что если вам нужен идентификатор объекта, то вы можете использовать его уникальный адрес. Приводился такой пример:
struct StationClient {
    [[nodiscard]] uintptr_t ClientId() const {
        return reinterpret_cast<uintptr_t>(this);
    }
};
Выглядит с первого взгляда круто. Действительно, у каждого объекта свой уникальный адрес. Два объекта в программе не могут занимать одну ячейку памяти. Получается, что адрес можно использовать как id и это "просто работает".
Только вот сходу можно назвать кучу проблем, к которому ведет этот подход:
🔞 id объекта меняется, если он перемещается
🔞 id объекта меняется, если он копируется(должны ли такие объекты копироваться и перемещать вообще - это вопрос, но проблемы остаются)
🔞 такой айди тесно связан с временем жизни объекта и не существует о отрыве объекта в программе
🔞 id переиспользуется другими объектами и на стеке, и на куче. Как только разрушился объект, новый объект может получить тот же самый id. И как различить объекты в таком случае непонятно.
🔞 id нельзя безопасно использовать как внешний идентификатор, аля передавать в другие сервисы или сохранять в хранилища.
Я понимаю, что скорее всего на интервью, где-то в отдельных модулях приложения или в каких-то игрушечных проектах такой подход может сработать. Но в каких-то больших распределенных системах вряд ли. Хотя мир большой и вы в комментариях расскажете, где такой подход применяется на практике.
Если хочется что-то простое и на коленке сделанное, то можно использовать приватный статический(потенциально атомарный) счетчик внутри класса и при создании объекта инкрементировать его:
struct StationClient {
    StationClient() {
        id = Id.fetch_add(1);
    }
    [[nodiscard]] std::size_t ClientId() const {
        return id;
    }
private:
    static inline std::atomic<std::size_t> Id = 0;
    int id;
};
При копировании, мувах Id не меняется(но это можно исправить, если надо), а чтобы новый объект заимел тот же айди нужно 100500 лет.
Однако при рестарте приложения, счетчик все еще обнуляется и будут дубли. Если вам критично, чтобы не существовало двух объектов с одинаковым id, можно использовать UUIDv7. Там 2¹²² вариантов айдишников, вероятностью совпадения при использовании uuid обычно пренебрегают.
Have your own identity. Stay cool.
#design
❤11👍7❤🔥2🔥1