Forwarded from Библиотека собеса по Data Science | вопросы с собеседований
Библиотека CatBoost завоевала огромную популярность в DS.
Какую уникальную математическую фичу использует CatBoost под капотом, чтобы кодировать категории?
Какую уникальную математическую фичу использует CatBoost под капотом, чтобы кодировать категории?
Anonymous Quiz
31%
Он автоматически преобразует каждую текстовую строку в вектор эмбеддинга с помощью BERT
18%
Он игнорирует категории, в которых встречается меньше 5% данных, пропуски
33%
Он использует «онлайн-кодирование»
7%
Он автоматически чистит данные перед обучением
10%
Не знаю
«Онлайн-кодирование» в контексте машинного обучения (ML) — это процесс преобразования категориальных признаков в числовые значения непосредственно в процессе обучения модели, не требующий предварительного полного сканирования всех данных (batch-обучение).
Онлайн-методы кодирования, такие как целевое кодирование (target encoding) или хэш-кодирование (hashing trick), позволяют кодировать новые данные с минимальными затратами ресурсов.
Онлайн-методы кодирования, такие как целевое кодирование (target encoding) или хэш-кодирование (hashing trick), позволяют кодировать новые данные с минимальными затратами ресурсов.
Attention Is All You Need = Назар аудару - саған керек жалғыз нәрсе
* Deep Learning - терең оқыту;
* Dataset - дерекқоржын;
* Vanishing Gradient - жоғалып бара жатқан градиент;
* Exploding Gradient - жарылып жатқан градиент;
* Softmax - жұмсақ максимум;
* K Nearest Neighbors - K жақын көршілер;
* RandomForest - кездейсоқ орман;
* DecisionTree - шешуші ағаш;
* Pooling Layer - біріктіру қабаты;
* Hidden Layer - жасырын қабат;
* Dropout - тастап кету;
* Multi-headed Attention - көп-басты назар;
* Multi-armed Bandit - көп-қолды қарақшы;
* Backpropagation - кері таралу;
* Weight Decay - салмақтың ыдырауы;
* Loss Function - шығын функциясы;
* Chain-of-Thought - ойтізбек;
* Feature Extraction - белгісуыру;
#ml_terms_in_kazakh
👍1
Forwarded from Machinelearning
MiniCPM5-1B теперь полностью open source: открыты веса, обучающие данные и код для деплоя. 🚀
1B параметров, первое место на Artificial Analysis среди всех открытых моделей меньше 2B параметров - 17.9 балла.
Обходит Qwen3.5-2B, у которой 16.3 балла, при вдвое меньшем числе параметров. Также превосходит Qwen3.5-0.8B и LFM2.5-1.2B-Thinking в задачах на знания, математику, код и использование инструментов.
INT4-версия занимает 0.5 ГБ. Запускается на телефонах, в браузерах и на edge-устройствах.
Обучена с помощью ForgeTrain - первого production-grade фреймворка для pretraining LLM, полностью написанного ИИ: без human-программистов и на 10% быстрее NVIDIA Megatron.
🤖 https://modelscope.cn/models/OpenBMB/MiniCPM5-1B
@ai_machinelearning_big_data
👍1
Machinelearning
MiniCPM5-1B теперь полностью open source: открыты веса, обучающие данные и код для деплоя. 🚀 1B параметров, первое место на Artificial Analysis среди всех открытых моделей меньше 2B параметров - 17.9 балла. Обходит Qwen3.5-2B, у которой 16.3 балла, при вдвое…
huggingface.co
openbmb/MiniCPM5-1B · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
👍1
Forwarded from Proggy-Buggy Contest (bot for editing and posting)
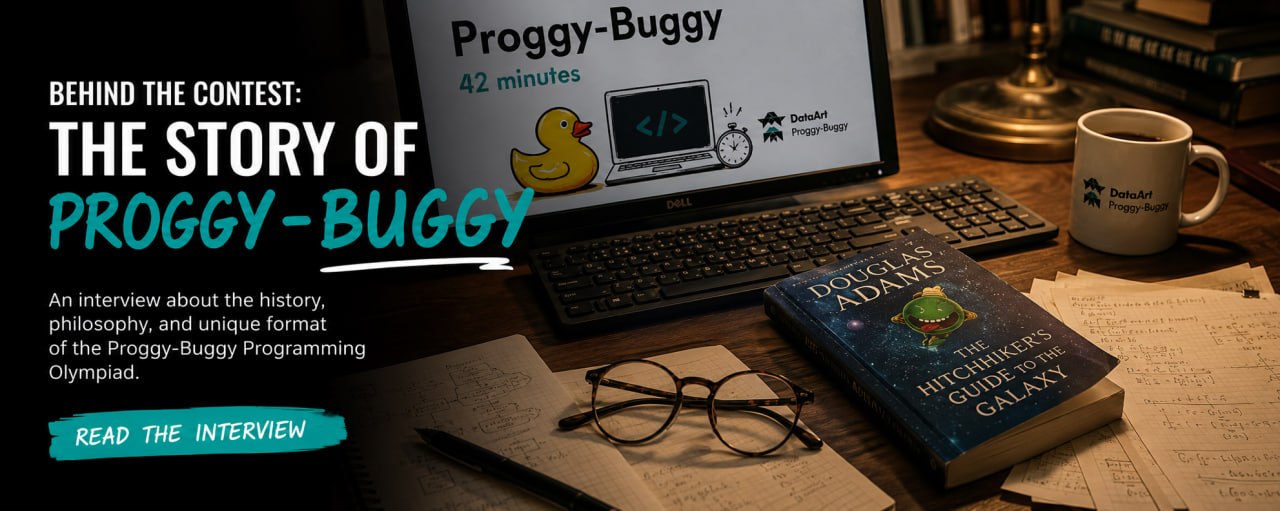
At first glance, Proggy-Buggy looks slightly unserious 👀
⏱️ 42 minutes
🧩 13 problems
🤯 Towels
And tasks that sometimes literally have no solution
But somehow this chaos has existed for more than 10 years — and gathers thousands of participants every year 🔥
So… what’s actually going on here?
In this interview, Proggy-Buggy creator Oleksandr Khizha explains:
— ❓ why this contest even exists
— 🧠 why some problems are intentionally “UNDECIDABLE”
— ⚡️ why thinking faster beats thinking longer
— ♟ why Proggy-Buggy feels more like blitz chess than a programming contest
If you’ve ever thought: “Wait… what is this thing?” 🤨 —or wondered why people keep coming back to it—
this is for you 👇
Forwarded from Kazakhstan CP Federation
This media is not supported in your browser
VIEW IN TELEGRAM
#champinshipkz
ЧРК қатысушыларына мерч сыйлаймыз 🏆
Қатысу үшін:
— 29 мамыр, 16:00-ге дейін 3-кезеңге тіркел
— 31 мамырдағы контестке қатыс
— белсенді бол
Кездейсоқ таңдалған қатысушыларға мерч сыйлаймыз 🎁
Әлі тіркелмедің бе? Тіркелу 🔗
—
Дарим фирменный мерч участникам ЧРК 🏆
Что нужно сделать?
— зарегистрироваться на 3-й этап ЧРК до 29 мая, 16:00
— участвовать на контесте 31 мая
— быть активным участником контеста
Несколько рандомных участников получат фирменный мерч 🎁
Еще не зарегистрировался?
Самое время это исправить — регистрация 🔗
Problem Solving with Arman (ML+Algo)
#Andrej_Karpathy #tweet_discussion
1. Что такое "Код" в понимании Карпатого?
Карпатый утверждает, что веса нейронной сети (миллиарды чисел) — это тоже код. Просто этот код написан не на языке Python, а на языке математических матриц.
* Software 1.0: Код пишет человек (инструкция за инструкцией).
* Software 2.0: Код "пишет" градиентный спуск (Gradient Descent), подбирая такие веса, которые решают задачу лучше, чем любой алгоритм, написанный вручную.
2. Разница между "пространством текста" и "пространством представлений"
* Распределенное пространство представлений (Distributed Representation Space): Это то, о чем был твит 2017 года. Градиентный спуск "программирует" внутренние связи нейросети. Он находит такие сложные зависимости в данных, которые человек никогда не смог бы описать правилами (hard-code). В этом смысле градиентный спуск — более эффективный "программист", чем человек.
* Пространство текста (Regular Text Space): Это то, что делают современные LLM (ChatGPT, Claude). Они буквально пишут код на Python или С++, имитируя человека. Карпатый иронизирует, что в 2017 году он имел в виду математику, а теперь ИИ реально пишет текстовый код 😅
~ Разбор сделан при помощи Gemini Flash (очень круто по полочкам разобрал - мне понравилось) :)
❤3
❤1
Kind reminder (ods.ai event): https://ods.ai/events/fest2026-almaty-30may
Problem Solving with Arman (ML+Algo)
https://youtu.be/kYkIdXwW2AE?si=lKaiSG9Fhr_RZ-Un
YouTube
Yann LeCun's $1B Bet Against LLMs [Part 2]
Huge thanks to KiwiCo for sponsoring today’s video! Go to https://www.kiwico.com/welchlabs and use code WELCHLABS for 50% off your first monthly crate or for 20% off your first Panda Crate!
Welch Labs Book: https://www.welchlabs.com/resources/ai-book-ezrzm…
Welch Labs Book: https://www.welchlabs.com/resources/ai-book-ezrzm…
🧠 Time to Trivia!
If you love random facts, history deep-dives, or just want to test your trivia-skills -> Encyclopædia Britannica has a massive repository of trivia quizzes covering absolutely everything:
🎬 Pop Culture & Movies
🏛️ World History & Mythology
🧬 Science & Tech
🌍 Geography & Nature
👉 Tap here to test your knowledge: https://www.britannica.com/quiz/browse
Encyclopedia Britannica
Trivia Quizzes | Britannica
Take these quizzes at Encyclopedia Britannica to test your knowledge on a variety of fun and interesting topics including Animals, Art, Music, Pop Culture, Science, History and more!
Calculate Number of Parameters in Neural Network:
For ML engineers knowing the parameter count is vital because it determines a model's memory footprint and computational requirements, ensuring it can actually run on target hardware like GPUs or mobile devices.
Trainable parameters in a neural network are the internal variables (primarily weights and biases) that the model automatically adjusts during training to learn from data and improve its accuracy.
It serves as a direct measure of model capacity, helping engineers balance the complexity of the architecture to prevent overfitting while maintaining efficient training and inference speeds.
> Problem link (implement using numpy ~ recommended): https://www.deep-ml.com/problems/291
Dense layer:
CNN layer:
Embedding layer:
For ML engineers knowing the parameter count is vital because it determines a model's memory footprint and computational requirements, ensuring it can actually run on target hardware like GPUs or mobile devices.
Trainable parameters in a neural network are the internal variables (primarily weights and biases) that the model automatically adjusts during training to learn from data and improve its accuracy.
It serves as a direct measure of model capacity, helping engineers balance the complexity of the architecture to prevent overfitting while maintaining efficient training and inference speeds.
> Problem link (implement using numpy ~ recommended): https://www.deep-ml.com/problems/291
Dense layer:
trainable_params = input_size * out_size + out_size * int(use_bias)
CNN layer:
trainable_params = kernel_width * kernel_height * in_channels * out_channels + out_channels * int(use_bias)
Embedding layer:
trainable_params = num_embeddings * embedding_dim
Deep-Ml
Calculate Number of Parameters in Neural Network | Deep-ML
Solve "Calculate Number of Parameters in Neural Network" — a medium Deep Learning coding challenge on Deep-ML. Practice your ML skills with hands-on problems.
def test():
    try:
        ans = "repeat" * 3.14
        return ans
    except:
        return "exceptional"
    finally:
        return "finally over"

print(test())
#python_code_trivia