آکادمی تحلیل آماری ایران
کارگاه مقدماتی تا پیشرفته اس پی اس اس ۱۴تا۱۸تیرماه با تدریس دکتر محسن مرادی و گواهینامه بین المللی از اتریش هزینه دانشجویی ۵۰۰هزارتومان رزرو ارسال نام خانوادگی ظرفیت محدود
همراهان عزیز اکادمی با تقدیر از استقبال شما از دوره های ما
به اطلاع میرسانم دوره اس پی اس اس تاریخهای ۱۴تا۱۸تیرماه تکمیل ظرفیت شده دیگه واریز نفرمایید و از هم اکنون برای دوره مرداد اقدام بفرمایید
به اطلاع میرسانم دوره اس پی اس اس تاریخهای ۱۴تا۱۸تیرماه تکمیل ظرفیت شده دیگه واریز نفرمایید و از هم اکنون برای دوره مرداد اقدام بفرمایید
اکادمی تحلیل آماری ایران برگزار میکند:
کارگاه جامع تحلیل کیفی با نرم افزار مکس کیو دی ای تاریخهای چهارم تا هفتم مردادبا هزینه دانشجویی ۵۰۰هزارتومان و گواهینامه بین المللی اتریش
کارگاه چهارروزه صفر تا صد ایموس و اسمارت پی ال اس تاریخهای شانزدهم هفدهم هیجدهم و نوزدهم مرداد به هزینه دانشجویی ۵۰۰هزارتومان
کارگاه مقدماتی تا پیشرفته اس پی اس اس تاریخهای ۲۷،۲۸،۲۹،۳۰،۳۱ مردادماه با هزینه دانشجویی ۵۰۰هزارتومان و گواهینامه بین المللی اتریش
و تدریس دکتر محسن مرادی
رزرو با ۰۹۱۰۰۰۷۱۸۰۴
کارگاه جامع تحلیل کیفی با نرم افزار مکس کیو دی ای تاریخهای چهارم تا هفتم مردادبا هزینه دانشجویی ۵۰۰هزارتومان و گواهینامه بین المللی اتریش
کارگاه چهارروزه صفر تا صد ایموس و اسمارت پی ال اس تاریخهای شانزدهم هفدهم هیجدهم و نوزدهم مرداد به هزینه دانشجویی ۵۰۰هزارتومان
کارگاه مقدماتی تا پیشرفته اس پی اس اس تاریخهای ۲۷،۲۸،۲۹،۳۰،۳۱ مردادماه با هزینه دانشجویی ۵۰۰هزارتومان و گواهینامه بین المللی اتریش
و تدریس دکتر محسن مرادی
رزرو با ۰۹۱۰۰۰۷۱۸۰۴
آکادمی تحلیل آماری ایران
کارگاه دو روزه فراتحلیل با نرم افزار CMA2 در اکادمی تحلیل اماری ایران با تدریس دکتر محسن مرادی و گواهینامه بین المللی از اتریش هزینه دانشجویی ۳۰۰هزارتومان رزرو ارسال نام خانوادگی ظرفیت محدود
همراهان گرامی کارگاه فراتحلیل تیر ماه با استقبال بی نظیرتان تکمیل ظرفیت شده است لطفا واریز برای این دوره از این به بعد انجام ندهید دوره آتی را شنبه خدمتتون اعلام مینماییم بینهایت سپاسگزارتون
آکادمی تحلیل آماری ایران
کارگاه مدلسازی معادلات ساختاری با نرم افزارهای ایموس و اسمارت پی ال اس تاریخهای ۱۶تا۱۹ مرداد با گواهینامه بین المللی هزینه دانشجویی ۵۰۰هزارتومان مدرس دکتر مرادی ظرفیت محدود رزرو با ارسال نام خانوادگی
همراهان گرامی با عرض ادب کارگاه ایموس و اسمارت پی ال اس تاریخهای ۱۶تا۱۹ مرداد تکمیل ظرفیت شده دیگه واریز نفرمایید
فقط برای دوره مقدماتی تا پیشرفته اس پی اس اس تاریخهای ۲۷تا۳۱مردادماه و کارگاه فراتحلیل تاریخهای ۸و۹شهریور هم اکنون تا پر نشده اقدام بفرمایید
بینهایت ممنونم
فقط برای دوره مقدماتی تا پیشرفته اس پی اس اس تاریخهای ۲۷تا۳۱مردادماه و کارگاه فراتحلیل تاریخهای ۸و۹شهریور هم اکنون تا پر نشده اقدام بفرمایید
بینهایت ممنونم
http://analysisacademy.com/wp-content/uploads/2016/12/R-SQUARE.png
شاخص ضریب تعیین و ضریب تعیین تعدیل شده
یکی از چالش برانگیزترین شاخص های ارزیابی مدلهای علی شاخص ضریب تعیین و ضریب تعیین تعدیل شده است متاسفانه گاهی فراموش می شود که این شاخص ها در فرضیات علی محقق به دنبال پیش بینی رفتار متغییر مکنون درونزا است و بسیاری از ژورنالها از این شاخص ها برای ارزیابی کیفیت تدوین مدل در مرحله پیش از ورود به نرم افزار استفاده می کنند. در واقع اگر بخواهیم با توجه به دوره های مدلسازی معادلات ساختاری درآکادمی تحلیل آماری ایران این مبحث را تشریح نماییم رایج ترین سنجه مورد استفاده برای ارزیابی مدل ساختاری ضریب تعیین یا همان مقدار R2 است. این ضریب سنجه دقت پیش بینی مدل است و برابر با توان دوم همبستگی میان مقادیر واقعی و پیش بینی شده یک سازه درونزای معین است. این ضریب اثرات چندگانه متغییرهای مکنون برونزا بر متغییر مکنون درونزا را معین می کند. از انجا که این ضریب توان دوم همبستگی مقادیر واقعی و پیش بینی شده است، مقدار واریانس سازه های درونزا را که به وسیله همه سازه های برونزای متناظر شرح داده می شود را نشان می دهد.
دامنه تغییرات R2 از صفر تا یک است و مقادیر بزرگتر سطح پیش بینی بالاتر را نشان می دهد. مساله مهم ارائه قاعده ایی قابل قبول برای ضریب تعیین در بین محققین و داوران مجلات مختلف علمی است زیرا این مقدار بستگی به پیچیدگی مدل و رشته مورد مطالعه دارد مثلا ۰/۲ در رشته هایی نظیر رفتار مصرف کننده بالا در نظر گرفته می شود در حالی که در برخی دیگر از رشته ها مثل علوم اجتماعی یا روانشناسی محققان انتظار مقادیر بالاتر از ۰/۵ را دارند بنابراین در طی این سالها محققین بسیاری مقادیر مختلفی را برای سنجش قدرت تبیین واریانس متغییرهای درونزا گزارش کرده اند.(hair,2010)
مثلا در مطالعه چین در سال ۱۹۹۸ مقادیر ۰/۱۹، ۰/۳۳ و ۰/۶۷ به ترتیب دقت کم، متوسط و زیاد پیش بینی را بیان می کند یا هیر و همکارانش در سال ۲۰۱۱ و نیز هنسلر و همکارانش در سال ۲۰۰۹ مقدار R2 برابر ۰/۲۵ ، ۰/۵۰ و ۰/۷۵ را برای مطالعات بازاریابی بیان می کنند و یا عده ایی دیگر از محققین مثل سارستد و دیگران(۲۰۱۳) معتقدند که سه مقدار هیر و همکارانش برای متغییرهای مکنون درونزایی مناسب است که با بیش از پنج متغییر مکنون برونزا تبیین رفتار می شوند.(مرادی،۱۳۹۶)
مشکلات اغلب به دلیل استفاده از مقدار R2 برای مقایسه مدلهایی که به طور متفاوت تدوین شده اند اما دارای همان سازه درونزا هستند به وجود می آیند. برای مثال اگر سازه های غیرمعنادار در یک مدل ساختاری که تنها اندکی با متغییر مکنون درونزا همبستگی دارند به مدل اضافه شوند علی رغم غیر معنادار بودن اندکی مقدار R2 افزایش می دهند.
همچنین اگر حجم نمونه نزدیک به تعداد متغییرهای مکنون برونزا باشد این نوع حالت مقدار R2 قابل توجهی خواهد داشت. بنابراین اگر از مقدارR2 به عنوان تنها قاعده فهم دقت پیش بینی مدل استفاده شود، یک اریب ذاتی به سمت انتخاب مدلهایی با تعداد سازه های برونزا زیاد به وجود می آید که در بین آنها می توان سازه های غیرمعنادار را به تعداد قابل توجه مشاهده کرد.
به هر حال نمی توان کتمان کرد که از سال ۲۰۱۰ به بعد محققان با توجه به فضای علمی حاکم بر ژورنالها به دنبال مدلهایی هستند که با حداقل متغییرهای برونزا حداکثر تبیین واریانس متغییر درونزا را داشته باشند، چنین مدلهایی را مدلهای مقتصد یا اقتصادی می نامند.
همانند رگرسیون چندگانه مقدار R2 تعدیل شده یاadj R2 می تواند به عنوان معیاری برای اجتناب از اریب به سمت مدلهای پیچیده استفاده شود. این معیار بر اساس تعداد سازه های برونزا نصب به حجم نمونه تعدیل شده است. مقدار adj R2 به صورت زیر تعریف می شود
R2adj = 1- (1- R2) * [(n-1) / (n-k-1)]
در این فرمول n حجم نمونه و k تعداد متغییرهای مکنون برونزای پیش بینی کننده رفتار متغییر مکنون درونزای تحت بررسی می باشد.
ضریب تعیین تعدیل شده مقدار R2 را به وسیله تعداد سازه های برونزا و حجم نمونه کاهش و تعدیل می کند.البته باید توجه داشت بسیاری از محققین معتقد هستند که نمی توان آن را همانند R2 تفسیر کرد.
از کپی کردن مطالب سایت یا کانال بدون ذکر منبع خودداری شود.
آدرس کانال تلگرام: https://telegram.me/analysisacademy
شاخص ضریب تعیین و ضریب تعیین تعدیل شده
یکی از چالش برانگیزترین شاخص های ارزیابی مدلهای علی شاخص ضریب تعیین و ضریب تعیین تعدیل شده است متاسفانه گاهی فراموش می شود که این شاخص ها در فرضیات علی محقق به دنبال پیش بینی رفتار متغییر مکنون درونزا است و بسیاری از ژورنالها از این شاخص ها برای ارزیابی کیفیت تدوین مدل در مرحله پیش از ورود به نرم افزار استفاده می کنند. در واقع اگر بخواهیم با توجه به دوره های مدلسازی معادلات ساختاری درآکادمی تحلیل آماری ایران این مبحث را تشریح نماییم رایج ترین سنجه مورد استفاده برای ارزیابی مدل ساختاری ضریب تعیین یا همان مقدار R2 است. این ضریب سنجه دقت پیش بینی مدل است و برابر با توان دوم همبستگی میان مقادیر واقعی و پیش بینی شده یک سازه درونزای معین است. این ضریب اثرات چندگانه متغییرهای مکنون برونزا بر متغییر مکنون درونزا را معین می کند. از انجا که این ضریب توان دوم همبستگی مقادیر واقعی و پیش بینی شده است، مقدار واریانس سازه های درونزا را که به وسیله همه سازه های برونزای متناظر شرح داده می شود را نشان می دهد.
دامنه تغییرات R2 از صفر تا یک است و مقادیر بزرگتر سطح پیش بینی بالاتر را نشان می دهد. مساله مهم ارائه قاعده ایی قابل قبول برای ضریب تعیین در بین محققین و داوران مجلات مختلف علمی است زیرا این مقدار بستگی به پیچیدگی مدل و رشته مورد مطالعه دارد مثلا ۰/۲ در رشته هایی نظیر رفتار مصرف کننده بالا در نظر گرفته می شود در حالی که در برخی دیگر از رشته ها مثل علوم اجتماعی یا روانشناسی محققان انتظار مقادیر بالاتر از ۰/۵ را دارند بنابراین در طی این سالها محققین بسیاری مقادیر مختلفی را برای سنجش قدرت تبیین واریانس متغییرهای درونزا گزارش کرده اند.(hair,2010)
مثلا در مطالعه چین در سال ۱۹۹۸ مقادیر ۰/۱۹، ۰/۳۳ و ۰/۶۷ به ترتیب دقت کم، متوسط و زیاد پیش بینی را بیان می کند یا هیر و همکارانش در سال ۲۰۱۱ و نیز هنسلر و همکارانش در سال ۲۰۰۹ مقدار R2 برابر ۰/۲۵ ، ۰/۵۰ و ۰/۷۵ را برای مطالعات بازاریابی بیان می کنند و یا عده ایی دیگر از محققین مثل سارستد و دیگران(۲۰۱۳) معتقدند که سه مقدار هیر و همکارانش برای متغییرهای مکنون درونزایی مناسب است که با بیش از پنج متغییر مکنون برونزا تبیین رفتار می شوند.(مرادی،۱۳۹۶)
مشکلات اغلب به دلیل استفاده از مقدار R2 برای مقایسه مدلهایی که به طور متفاوت تدوین شده اند اما دارای همان سازه درونزا هستند به وجود می آیند. برای مثال اگر سازه های غیرمعنادار در یک مدل ساختاری که تنها اندکی با متغییر مکنون درونزا همبستگی دارند به مدل اضافه شوند علی رغم غیر معنادار بودن اندکی مقدار R2 افزایش می دهند.
همچنین اگر حجم نمونه نزدیک به تعداد متغییرهای مکنون برونزا باشد این نوع حالت مقدار R2 قابل توجهی خواهد داشت. بنابراین اگر از مقدارR2 به عنوان تنها قاعده فهم دقت پیش بینی مدل استفاده شود، یک اریب ذاتی به سمت انتخاب مدلهایی با تعداد سازه های برونزا زیاد به وجود می آید که در بین آنها می توان سازه های غیرمعنادار را به تعداد قابل توجه مشاهده کرد.
به هر حال نمی توان کتمان کرد که از سال ۲۰۱۰ به بعد محققان با توجه به فضای علمی حاکم بر ژورنالها به دنبال مدلهایی هستند که با حداقل متغییرهای برونزا حداکثر تبیین واریانس متغییر درونزا را داشته باشند، چنین مدلهایی را مدلهای مقتصد یا اقتصادی می نامند.
همانند رگرسیون چندگانه مقدار R2 تعدیل شده یاadj R2 می تواند به عنوان معیاری برای اجتناب از اریب به سمت مدلهای پیچیده استفاده شود. این معیار بر اساس تعداد سازه های برونزا نصب به حجم نمونه تعدیل شده است. مقدار adj R2 به صورت زیر تعریف می شود
R2adj = 1- (1- R2) * [(n-1) / (n-k-1)]
در این فرمول n حجم نمونه و k تعداد متغییرهای مکنون برونزای پیش بینی کننده رفتار متغییر مکنون درونزای تحت بررسی می باشد.
ضریب تعیین تعدیل شده مقدار R2 را به وسیله تعداد سازه های برونزا و حجم نمونه کاهش و تعدیل می کند.البته باید توجه داشت بسیاری از محققین معتقد هستند که نمی توان آن را همانند R2 تفسیر کرد.
از کپی کردن مطالب سایت یا کانال بدون ذکر منبع خودداری شود.
آدرس کانال تلگرام: https://telegram.me/analysisacademy

http://analysisacademy.com/wp-content/uploads/2018/07/validity.jpg
کد گذاری توصیفی، درون متنی و فرایندی پژوهش کیفی
دانشجویان دوره های کیفی آکادمی تحلیل آماری ایران پس از آشنایی با پارادایم ها و استراتژی های متناسب کیفی برای حل مسئله پژوهش و نیز انتخاب تاکتیک های مناسب برای تجزیه و تحلیل اطلاعات، با اناوع فرمت های داده های کیفی مثل عکس، فیلم، صوت، متن و … مواجه می شوند. اما مطابق با نظر اووه فلیک در سال ۲۰۰۵ در کتاب خود، بحثی با عنوان استخراج نظریه از متن را ارائه نمود. به عبارتی او معتقد بود که نظریه از متن پیاده سازی شده استخراج می شود. یعنی یکی از مهمترین فرمت های داده های کیفی در تحقیقات کد گذاری و تجزیه تحلیل درون متون است. البته پیش از این در سایت و کانال آکادمی تحلیل آماری ایران به تفصیل انواع کد گذاری مورد بحث قرار گرفت. در حقیقت زمانی که دادهها در قالب واژه درآمدند باید اطلاعات معنیدار و مرتبط با اهداف و پرسشهای پژوهش را از آنها استخراج کرد. بنابراین نیاز به ساختارهای مشخصی وجود دارد که توسط کدها ایجاد میشوند.
کدها برچسبهایی معنادار هستند که به مجموعه ای از واقعیات بیان شده در متون که به مفهومی مشخص اشاره می کنند، داده می شود. این واقعیات در قالب یک واژه، جمله، پاراگراف، یا هر قسمت از متن هستند که معنایی مشخص برای پژوهش و پژوهشگر دارند. این برچسبها ممکن است توصیفی سرراست از متن باشند و یا مانند یک استعاره تداعیکننده و پیچیده باشند. به عبارت دیگر، کدها به پژوهشگر کمک میکنند تا تکههای مشابه از متن را بیابد، آنها را در کنار هم قرار دهد، و سپس از آنها برای پاسخگویی به پرسشهای پژوهش استفاده کند.
کدگذاری در واقع همان فرایند تجزیه کردن بخشهای داده های کیفی و تحلیل آنها است که مواد موردنیاز را برای دستهبندی موضوعی دادهها بر اساس اهداف پژوهش فراهم میآورد. این کار به شکلگیری فهم پژوهشگر از مفاهیم و الگوهای داده کمک میکند. به عنوان نمونه فرض نمایید که جملاتی را در یک پاراگراف داریم.
مثلا : من صبح زود از خواب بیدار می شوم، مسواک می زنم، ورزش می کنم و صبحانه ای مغذی می خورم.
این چند تکه به مفهوم توجه به سلامتی اشاره می کنند. بنابراین برچسبی معنادار یا همان کد به این چند جمله زده می شود و کد توجه به سلامتی خوانده می شود.
ایجاد یا اصلاح کدها، و زمان آن تا هنگامی که یکنواختی مفهومی و ساختاری آنها برقرار باشد، مهم نیست. کدها باید بهم مرتبط، و در مسیر مطالعه باشند و ساختار منسجم آنها رعایت شود. نکتۀ دیگری که وجود دارد این است که کدهای از پیش موجود یا کدهایی که در طول مسیر پژوهش ایجاد شدهاند، باید به روشنی تعریف شوند تا پژوهشگر یا پژوهشگران درگیر در پژوهش در طول زمان معنای یکسانی را از کدها برداشت کنند.
«سالدانا» فرایند کدگذاری را به دو مرحله تقسیم کرده است:
• کدگذاری دور نخست (first cycle)
• و کدگذاری دور دوم (second cycle)
این دو مرحله به پژوهشگر در ساختار بخشیدن به دادهها و سپس سازماندهی آنها برای رسیدن به الگوها کمک میکنند.
در دور نخست، برای خلاصهسازی اولیۀ داده کدهایی به آنها اختصاص مییابند. این کار میتواند با ۳ رویکرد مختلف انجام شود، که هر کدام عملکرد و هدف مشخصی را به دنبال خواهند داشت. پژوهشگر میتواند با توجه به نیاز خود از این رویکردها یا ترکیبی از آنها استفاده کند. بنابراین محققین کیفی عزیز به این سه رویکرد توجه نمایند. البته همچنان با قدرت همانطور که در کلاس های آکادمی تحلیل آماری بیان نمودیم تنها دانشجویانی موفق خواهند بود که این فرایند ها را به صورت صحیح انجام دهند که هم به روش پژوهش کیفی و هم به روش پژوهش کمی تسلط داشته باشند. قطعا محققی که نمی تواند پیش بینی نماید پرسش نامه، متغیر ها و یا مدل های برآمده از این رویکرد های کیفی چه آینده ای در تعمیم آن به یک نمونه بزرگ در قالب روش پژوهش کمی خواهد داشت ابدا موفق نخواهد بود. یعنی انتخاب کد ها باید با دیدگاهی کمی و پنهان در ذهن محقق همراه باشد و محقق کاملا به مفاهیم بیان شده در دوره های کمی تسلط داشته باشد. چه بسیاری محققینی که در این ۶ سال پژوهش های کیفی خود را انجام داده و مدل هایی متفاوت در این حوزه ارائه نموده اند اما حتی یکی از این پژوهش ها از آزمون های رویکرد کمی که در ادامه پژوهش در راستای پژوهشی آمیخته انجام گرفته است، سربلند بیرون نیامده است. باید این پارادایم شیفت در ذهن محققین انجام گیرد که هدف حل مسئله است و این رویکرد ها و روش ها و تاکتیک ها در مقام ابزار در دستان محقق قرار دارد و هدف پژوهش نیست(مرادی، ۱۳۹۶).
اما این سه نوع کر گذاری عبارت از کد گذاری توصیفی، کد گذاری درون متنی و کد گذاری فرایندی می باشد.
کد گذاری توصیفی، درون متنی و فرایندی پژوهش کیفی
دانشجویان دوره های کیفی آکادمی تحلیل آماری ایران پس از آشنایی با پارادایم ها و استراتژی های متناسب کیفی برای حل مسئله پژوهش و نیز انتخاب تاکتیک های مناسب برای تجزیه و تحلیل اطلاعات، با اناوع فرمت های داده های کیفی مثل عکس، فیلم، صوت، متن و … مواجه می شوند. اما مطابق با نظر اووه فلیک در سال ۲۰۰۵ در کتاب خود، بحثی با عنوان استخراج نظریه از متن را ارائه نمود. به عبارتی او معتقد بود که نظریه از متن پیاده سازی شده استخراج می شود. یعنی یکی از مهمترین فرمت های داده های کیفی در تحقیقات کد گذاری و تجزیه تحلیل درون متون است. البته پیش از این در سایت و کانال آکادمی تحلیل آماری ایران به تفصیل انواع کد گذاری مورد بحث قرار گرفت. در حقیقت زمانی که دادهها در قالب واژه درآمدند باید اطلاعات معنیدار و مرتبط با اهداف و پرسشهای پژوهش را از آنها استخراج کرد. بنابراین نیاز به ساختارهای مشخصی وجود دارد که توسط کدها ایجاد میشوند.
کدها برچسبهایی معنادار هستند که به مجموعه ای از واقعیات بیان شده در متون که به مفهومی مشخص اشاره می کنند، داده می شود. این واقعیات در قالب یک واژه، جمله، پاراگراف، یا هر قسمت از متن هستند که معنایی مشخص برای پژوهش و پژوهشگر دارند. این برچسبها ممکن است توصیفی سرراست از متن باشند و یا مانند یک استعاره تداعیکننده و پیچیده باشند. به عبارت دیگر، کدها به پژوهشگر کمک میکنند تا تکههای مشابه از متن را بیابد، آنها را در کنار هم قرار دهد، و سپس از آنها برای پاسخگویی به پرسشهای پژوهش استفاده کند.
کدگذاری در واقع همان فرایند تجزیه کردن بخشهای داده های کیفی و تحلیل آنها است که مواد موردنیاز را برای دستهبندی موضوعی دادهها بر اساس اهداف پژوهش فراهم میآورد. این کار به شکلگیری فهم پژوهشگر از مفاهیم و الگوهای داده کمک میکند. به عنوان نمونه فرض نمایید که جملاتی را در یک پاراگراف داریم.
مثلا : من صبح زود از خواب بیدار می شوم، مسواک می زنم، ورزش می کنم و صبحانه ای مغذی می خورم.
این چند تکه به مفهوم توجه به سلامتی اشاره می کنند. بنابراین برچسبی معنادار یا همان کد به این چند جمله زده می شود و کد توجه به سلامتی خوانده می شود.
ایجاد یا اصلاح کدها، و زمان آن تا هنگامی که یکنواختی مفهومی و ساختاری آنها برقرار باشد، مهم نیست. کدها باید بهم مرتبط، و در مسیر مطالعه باشند و ساختار منسجم آنها رعایت شود. نکتۀ دیگری که وجود دارد این است که کدهای از پیش موجود یا کدهایی که در طول مسیر پژوهش ایجاد شدهاند، باید به روشنی تعریف شوند تا پژوهشگر یا پژوهشگران درگیر در پژوهش در طول زمان معنای یکسانی را از کدها برداشت کنند.
«سالدانا» فرایند کدگذاری را به دو مرحله تقسیم کرده است:
• کدگذاری دور نخست (first cycle)
• و کدگذاری دور دوم (second cycle)
این دو مرحله به پژوهشگر در ساختار بخشیدن به دادهها و سپس سازماندهی آنها برای رسیدن به الگوها کمک میکنند.
در دور نخست، برای خلاصهسازی اولیۀ داده کدهایی به آنها اختصاص مییابند. این کار میتواند با ۳ رویکرد مختلف انجام شود، که هر کدام عملکرد و هدف مشخصی را به دنبال خواهند داشت. پژوهشگر میتواند با توجه به نیاز خود از این رویکردها یا ترکیبی از آنها استفاده کند. بنابراین محققین کیفی عزیز به این سه رویکرد توجه نمایند. البته همچنان با قدرت همانطور که در کلاس های آکادمی تحلیل آماری بیان نمودیم تنها دانشجویانی موفق خواهند بود که این فرایند ها را به صورت صحیح انجام دهند که هم به روش پژوهش کیفی و هم به روش پژوهش کمی تسلط داشته باشند. قطعا محققی که نمی تواند پیش بینی نماید پرسش نامه، متغیر ها و یا مدل های برآمده از این رویکرد های کیفی چه آینده ای در تعمیم آن به یک نمونه بزرگ در قالب روش پژوهش کمی خواهد داشت ابدا موفق نخواهد بود. یعنی انتخاب کد ها باید با دیدگاهی کمی و پنهان در ذهن محقق همراه باشد و محقق کاملا به مفاهیم بیان شده در دوره های کمی تسلط داشته باشد. چه بسیاری محققینی که در این ۶ سال پژوهش های کیفی خود را انجام داده و مدل هایی متفاوت در این حوزه ارائه نموده اند اما حتی یکی از این پژوهش ها از آزمون های رویکرد کمی که در ادامه پژوهش در راستای پژوهشی آمیخته انجام گرفته است، سربلند بیرون نیامده است. باید این پارادایم شیفت در ذهن محققین انجام گیرد که هدف حل مسئله است و این رویکرد ها و روش ها و تاکتیک ها در مقام ابزار در دستان محقق قرار دارد و هدف پژوهش نیست(مرادی، ۱۳۹۶).
اما این سه نوع کر گذاری عبارت از کد گذاری توصیفی، کد گذاری درون متنی و کد گذاری فرایندی می باشد.

کد گذاری توصیفی (Descriptive coding): در کد گذاری توصیفی، موضوع اصلی متن در قالب یک واژه یا عبارت کوتاه (بیشتر اسمی) خلاصه میشود. این کار به تدریج انباشتهای از موضوعهای مورد پوشش را فراهم میکند که پژوهشگر را در امر برچسب دهی و ساخت مقولات یاری میرساند. با این روش میتوان به راحتی محیط اجتماعی را توصیف کرد، البته دیگر نمیتوان با آن یک فرایند اجتماعی را نشان داد مثلا به جمله زیر دقت نمایید:
در بسته بندی محصولات لبنی شرکت کاله تیم تحقیق توسعه شرکت طلاش کرد که از رنگ های جذاب و گیرا و با طیف رنگی بسیار متنوع بجای طیفی از رنگ های ساده استفاده نماید.
کد انتخابی با رویکرد توصیفی در اینجا یک اسم است که به تکه های به هم اتصال یافته در این جمله که اشاره به واقعیاتی می کند برچسب می خود. کد " رنگ " انتخاب محقق برای کد گذاری اولیه در این جمله با رویکرد توصیفی است.(مرادی، ۱۳۹۶)
کد گذاری درون متنی( In vivo coding) : یکی از روشهای شناخته شده است که در آن از واژهها و عبارتهای درون متن به عنوان کد استفاده میشوند. این روش را میتوان برای تمامی مطالعههای کیفی استفاده کرد. توصیه میشود که پژوهشگران تازه کار برای آشنایی با کدگذاری از این روش استفاده کنند. البته همانطور که در دوره های نرم افزار های کیفی بیان شد اساس تجزیه و تحلیل نرم افزار های تحلیل متن، تحلیل های همپوشانی برای مفاهیم است و این نوع کد گذاری در استراتژی گراندد تئوری محقق را از نظر نرم افزاری با مشکلات زیادی روبرو می کند. مثلا در جمله قبل اگر از این نوع کد گذاری استفاده گردد از درون متن کد " طیف رنگی" خود به تنهایی بار یک مفهوم را به دوش می کشد و می تواند به عنوان کد و برچسبی معنادار استفاده گردد(مرادی، ۱۳۹۶)
کد گذاری فرایندی(Process coding ): در کدگذاری فرایندی از اسم مصدر (فعلهایی که تبدیل به اسم شدهاند مانند فهمیدن، دیدن) برای اشاره به عمل یا فرایندی در داده استفاده میشود. این روش هم در تمامی مطالعههای کیفی کاربرد دارد، به ویژه پژوهشهای گراندد تئوری که هدف آنها استخراج عمل/ تعامل مشارکتکننده و پیامدهای آن است. مثلا در مثال قبل کد "بکار بردن رنگ های گیرا" یک کد فرایندی برای کد گذاری جمله ذکر شده است که از اسم مصدر به کار بردن استفاده نموده است و در حقیقت یک عمل کنشگر تحقیق کیفی را نشان می دهد. در مقالات بعدی روش های دیگری از کد گذاری اولیه متون را مورد بحث قرار می دهیم تا محققین عزیز آن ها را در تحقیقات خود رعایت نمایند. ضمنا دانشجویان فراموش نکنند که این نوع کد گذاری برای استخراج گزاره های اولیه و زدن برچسب معنادار یعنی کد به آن ها است و با استخراج آن ها می توان کد گذاری باز یا محوری و یا گزینشی را ادامه داد.(مرادی، ۱۳۹۶)
مقالات مرتبط زیر را بخوانید:
کدگذاری دادهها در نظریهپردازی دادهبنیاد (Grounded Theory)
انواع کدگذاری در تحقیق کیفی
آیا باید از نرم افزار های تحلیل داده های کیفی استفاده کرد؟
از کپی کردن مطالب سایت یا کانال بدون ذکر منبع خودداری شود.
آدرس کانال تلگرام: https://telegram.me/analysisacademy
در بسته بندی محصولات لبنی شرکت کاله تیم تحقیق توسعه شرکت طلاش کرد که از رنگ های جذاب و گیرا و با طیف رنگی بسیار متنوع بجای طیفی از رنگ های ساده استفاده نماید.
کد انتخابی با رویکرد توصیفی در اینجا یک اسم است که به تکه های به هم اتصال یافته در این جمله که اشاره به واقعیاتی می کند برچسب می خود. کد " رنگ " انتخاب محقق برای کد گذاری اولیه در این جمله با رویکرد توصیفی است.(مرادی، ۱۳۹۶)
کد گذاری درون متنی( In vivo coding) : یکی از روشهای شناخته شده است که در آن از واژهها و عبارتهای درون متن به عنوان کد استفاده میشوند. این روش را میتوان برای تمامی مطالعههای کیفی استفاده کرد. توصیه میشود که پژوهشگران تازه کار برای آشنایی با کدگذاری از این روش استفاده کنند. البته همانطور که در دوره های نرم افزار های کیفی بیان شد اساس تجزیه و تحلیل نرم افزار های تحلیل متن، تحلیل های همپوشانی برای مفاهیم است و این نوع کد گذاری در استراتژی گراندد تئوری محقق را از نظر نرم افزاری با مشکلات زیادی روبرو می کند. مثلا در جمله قبل اگر از این نوع کد گذاری استفاده گردد از درون متن کد " طیف رنگی" خود به تنهایی بار یک مفهوم را به دوش می کشد و می تواند به عنوان کد و برچسبی معنادار استفاده گردد(مرادی، ۱۳۹۶)
کد گذاری فرایندی(Process coding ): در کدگذاری فرایندی از اسم مصدر (فعلهایی که تبدیل به اسم شدهاند مانند فهمیدن، دیدن) برای اشاره به عمل یا فرایندی در داده استفاده میشود. این روش هم در تمامی مطالعههای کیفی کاربرد دارد، به ویژه پژوهشهای گراندد تئوری که هدف آنها استخراج عمل/ تعامل مشارکتکننده و پیامدهای آن است. مثلا در مثال قبل کد "بکار بردن رنگ های گیرا" یک کد فرایندی برای کد گذاری جمله ذکر شده است که از اسم مصدر به کار بردن استفاده نموده است و در حقیقت یک عمل کنشگر تحقیق کیفی را نشان می دهد. در مقالات بعدی روش های دیگری از کد گذاری اولیه متون را مورد بحث قرار می دهیم تا محققین عزیز آن ها را در تحقیقات خود رعایت نمایند. ضمنا دانشجویان فراموش نکنند که این نوع کد گذاری برای استخراج گزاره های اولیه و زدن برچسب معنادار یعنی کد به آن ها است و با استخراج آن ها می توان کد گذاری باز یا محوری و یا گزینشی را ادامه داد.(مرادی، ۱۳۹۶)
مقالات مرتبط زیر را بخوانید:
کدگذاری دادهها در نظریهپردازی دادهبنیاد (Grounded Theory)
انواع کدگذاری در تحقیق کیفی
آیا باید از نرم افزار های تحلیل داده های کیفی استفاده کرد؟
از کپی کردن مطالب سایت یا کانال بدون ذکر منبع خودداری شود.
آدرس کانال تلگرام: https://telegram.me/analysisacademy
Telegram
آکادمی تحلیل آماری ایران
Analysis Academy
http://analysisacademy.com/wp-content/uploads/2018/06/single.item_.png
متغییرهای تک سوالی
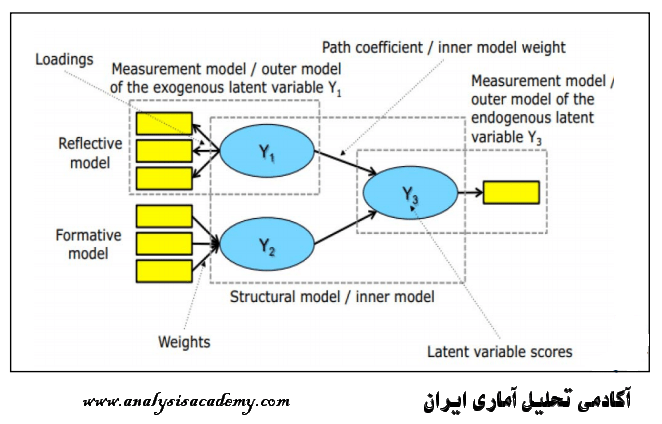
معمولا در دوره های مدلسازی معادلات ساختاری آکادمی تحلیل آماری ایران زمانی که تفاوتهای دو دسته از نرم افزار کواریانس محور و واریانس محور بیان می شود مشاهده می شود یکی از این تفاوتها این است که تنها نرم افزار واریانس محور اسمارت پی ال اس است که می تواند گونه خاصی از سازه ها را برآورد نماید که تنها توسط یک سوال یا سنجه اندازه گیری می شود. همواره دانشجویان آکادمی تحلیل آماری سوالاتی پیرامون این نوع متغییرهای تک سوالی در ذهن دارند که بهتر دیدیم در مطلبی جداگانه از پروفسور هیر آن را تشریح نماییم.
نسبت به استفاده از متغییرهای چند سواله برای سنجش یک سازه، برخی مواقع محققان استفاده از یک آیتم را انتخاب می کنند. متغییرهای تک سوالی مزایای عملی مثل سادگی کاربرد، اختصار و هزینه های پایین تر مرتبط با استفاده از آن را دارد. بر خلاف مقیاس های طولانی و پیچیده که اغلب منجر به درک پایین و خستگی ذهنی پاسخگویان می شوند، متغییرهای تک سوالی نرخ پاسخگویی بالاتر را از آنجا که سوالات به سادگی و به سرعت پاسخ داده می شوند، تشویق می کند(فاچز و دیامنتوپولوس،۲۰۰۹؛ سارستد و ویلزینسکی،۲۰۰۹). به هر حالمتغییرهای تک سوالی به ندرت پیشنهاد می شوند.
برای مثال متغییرهای تک سوالی محققان را با درجه آزادی کمتر هنگام افراز داده به زیرگروه ها، تنها می گذارد. زیرا برای تخصیص مشاهدات به گروه ها، مقادیر فقط از یک متغییر در دسترس هستند. به طور مشابه، هنگام استفاده از روش های ایمپیوت برای برخورد با مقادیر گمشده اطلاعات اندکی وجود دارد. در پایان از دیدگاه روان سنجی، متغییرهای تک سوالی امکان تنظیم خطای اندازه گیری را نمی دهند(چیزی که برای متغییرهای چند سواله وجود دارد) ، و این عموما پایایی آنها را کاهش می دهد. توجه داشته باشید که بر خلاف باورهای عموم، متغییر تک سوالی قابل برآورد است.(لو،۲۰۰۲؛ ونوس و دیگران،۱۹۹۷).
امید بستن به متغییر تک سوالی در بیشتر زمینه های تجربی وقتی درصدد روایی پیش بین هستیم تصمیم خطرناکی است. بخصوص، بسیار بعید است که در عمل رخ دهند. این نتیجه گیری حتی بیشتر برای PLS وارد است، زیرا به کارگیری تعداد اندکی از آیتم ها برای اندازه گیری سازه(در نهایت، استفاده از متغییر تک سوالی) با خواست کاهش گرایش PLS به گسترش برآوردهای اریبی دار(بیش برآورد روابط مدل اندازه گیری و کم برآورد روابط مدل ساختاری؛ اریبی PLS) ناسازگار است.
به یاد داشته باشید که با PLS وقتی تعداد معرف ها و یا تعداد مشاهدات افزایش می یابد این اریبی کاهش می یابد(سازگاری در بزرگی). طبق دستورالعمل دیامنتوپولوس و دیگران(۲۰۱۲) متغییرهای تک سوالی تنها زمانی باید مورد ملاحظه قرار گیرند که
• حجم نمونه کم باشد(کمتر از ۵۰)
• انتظار ضرایب مسیری(ضرایب پیوند سازه ها در مدل ساختاری) ۰٫۳ یا کمتر وجود داشته باشد
• آیتم های مقیاس چند سوالی اساسا بسیار همگن باشند(آلفای کرونباخ بیشتر از ۰٫۹)
• آیتم ها دارای افزونگی معنایی زیادی هستند.
از کپی کردن مطالب سایت یا کانال بدون ذکر منبع خودداری شود.
آدرس کانال تلگرام: https://telegram.me/analysisacademy
متغییرهای تک سوالی
معمولا در دوره های مدلسازی معادلات ساختاری آکادمی تحلیل آماری ایران زمانی که تفاوتهای دو دسته از نرم افزار کواریانس محور و واریانس محور بیان می شود مشاهده می شود یکی از این تفاوتها این است که تنها نرم افزار واریانس محور اسمارت پی ال اس است که می تواند گونه خاصی از سازه ها را برآورد نماید که تنها توسط یک سوال یا سنجه اندازه گیری می شود. همواره دانشجویان آکادمی تحلیل آماری سوالاتی پیرامون این نوع متغییرهای تک سوالی در ذهن دارند که بهتر دیدیم در مطلبی جداگانه از پروفسور هیر آن را تشریح نماییم.
نسبت به استفاده از متغییرهای چند سواله برای سنجش یک سازه، برخی مواقع محققان استفاده از یک آیتم را انتخاب می کنند. متغییرهای تک سوالی مزایای عملی مثل سادگی کاربرد، اختصار و هزینه های پایین تر مرتبط با استفاده از آن را دارد. بر خلاف مقیاس های طولانی و پیچیده که اغلب منجر به درک پایین و خستگی ذهنی پاسخگویان می شوند، متغییرهای تک سوالی نرخ پاسخگویی بالاتر را از آنجا که سوالات به سادگی و به سرعت پاسخ داده می شوند، تشویق می کند(فاچز و دیامنتوپولوس،۲۰۰۹؛ سارستد و ویلزینسکی،۲۰۰۹). به هر حالمتغییرهای تک سوالی به ندرت پیشنهاد می شوند.
برای مثال متغییرهای تک سوالی محققان را با درجه آزادی کمتر هنگام افراز داده به زیرگروه ها، تنها می گذارد. زیرا برای تخصیص مشاهدات به گروه ها، مقادیر فقط از یک متغییر در دسترس هستند. به طور مشابه، هنگام استفاده از روش های ایمپیوت برای برخورد با مقادیر گمشده اطلاعات اندکی وجود دارد. در پایان از دیدگاه روان سنجی، متغییرهای تک سوالی امکان تنظیم خطای اندازه گیری را نمی دهند(چیزی که برای متغییرهای چند سواله وجود دارد) ، و این عموما پایایی آنها را کاهش می دهد. توجه داشته باشید که بر خلاف باورهای عموم، متغییر تک سوالی قابل برآورد است.(لو،۲۰۰۲؛ ونوس و دیگران،۱۹۹۷).
امید بستن به متغییر تک سوالی در بیشتر زمینه های تجربی وقتی درصدد روایی پیش بین هستیم تصمیم خطرناکی است. بخصوص، بسیار بعید است که در عمل رخ دهند. این نتیجه گیری حتی بیشتر برای PLS وارد است، زیرا به کارگیری تعداد اندکی از آیتم ها برای اندازه گیری سازه(در نهایت، استفاده از متغییر تک سوالی) با خواست کاهش گرایش PLS به گسترش برآوردهای اریبی دار(بیش برآورد روابط مدل اندازه گیری و کم برآورد روابط مدل ساختاری؛ اریبی PLS) ناسازگار است.
به یاد داشته باشید که با PLS وقتی تعداد معرف ها و یا تعداد مشاهدات افزایش می یابد این اریبی کاهش می یابد(سازگاری در بزرگی). طبق دستورالعمل دیامنتوپولوس و دیگران(۲۰۱۲) متغییرهای تک سوالی تنها زمانی باید مورد ملاحظه قرار گیرند که
• حجم نمونه کم باشد(کمتر از ۵۰)
• انتظار ضرایب مسیری(ضرایب پیوند سازه ها در مدل ساختاری) ۰٫۳ یا کمتر وجود داشته باشد
• آیتم های مقیاس چند سوالی اساسا بسیار همگن باشند(آلفای کرونباخ بیشتر از ۰٫۹)
• آیتم ها دارای افزونگی معنایی زیادی هستند.
از کپی کردن مطالب سایت یا کانال بدون ذکر منبع خودداری شود.
آدرس کانال تلگرام: https://telegram.me/analysisacademy
با عرض ادب
برخی از دوستان شهرستانی عزیز و بزرگوار که در جستجو پانسیون دخترانه و پسرانه اطراف مطهری بودند پیشنهادات زیر برایشان وجود دارد:
اقامتگاه دخترانه سهروردی
۸۸۴۱۷۰۹۹
اقامتگاه دخترانه ونوس
میدان ارژانتین
۸۸۷۳۱۸۱۰
اقامتگاه دخترانه مفتح
۸۸۳۰۲۵۳۶
پانسیون دخترانه ارمغان
مطهری خیابان قایم مقام
۸۸۳۰۶۶۱۷
۰۹۳۷۴۲۱۱۰۵۰
اخریه خیلی نزدیکه محل کلاسه اصلا پنج دقیقه راه
خوابگاه پسرانه اسمان
خیابان مطهری خ میرزای شیرازی کوچه مقدم پلاک پنج
شماره تماس۸۸۵۵۲۵۰۵
پانسیون پسرانه خانه سفید
مترو هفت تیر خیابان قایم مقام کوچه شیوا شماره سه
شماره تماس ۸۸۸۴۳۳۶۵
پانسیون پسرانه فرزام
خیابان بهشتی خ میرعمادکوچه ۱۱پلاک ۲۸
شماره تماس ۸۸۷۵۴۷۶۳
برخی از دوستان شهرستانی عزیز و بزرگوار که در جستجو پانسیون دخترانه و پسرانه اطراف مطهری بودند پیشنهادات زیر برایشان وجود دارد:
اقامتگاه دخترانه سهروردی
۸۸۴۱۷۰۹۹
اقامتگاه دخترانه ونوس
میدان ارژانتین
۸۸۷۳۱۸۱۰
اقامتگاه دخترانه مفتح
۸۸۳۰۲۵۳۶
پانسیون دخترانه ارمغان
مطهری خیابان قایم مقام
۸۸۳۰۶۶۱۷
۰۹۳۷۴۲۱۱۰۵۰
اخریه خیلی نزدیکه محل کلاسه اصلا پنج دقیقه راه
خوابگاه پسرانه اسمان
خیابان مطهری خ میرزای شیرازی کوچه مقدم پلاک پنج
شماره تماس۸۸۵۵۲۵۰۵
پانسیون پسرانه خانه سفید
مترو هفت تیر خیابان قایم مقام کوچه شیوا شماره سه
شماره تماس ۸۸۸۴۳۳۶۵
پانسیون پسرانه فرزام
خیابان بهشتی خ میرعمادکوچه ۱۱پلاک ۲۸
شماره تماس ۸۸۷۵۴۷۶۳
آکادمی تحلیل آماری ایران
کارگاه مقدماتی تا پیشرفته اس پی اس اس با رویکرد نگارش مقالات تاریخهای ۲۷تا۳۱مردادماه وگواهینامه بین المللی از اتریش وتدریس بینظیر دکترمحسن مرادی با ظرفیت محدود رزرو ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴
همراهان همیشگی آکادمی تحلیل آماری ایران این کلاس تکمیل ظرفیت شد لطفا دیگه واریز نفرمایید
شنبه تاریخ جدید شهریور اعلام میکنم خدمتتتون
بینهایت ممنونم
شنبه تاریخ جدید شهریور اعلام میکنم خدمتتتون
بینهایت ممنونم
پکیج ویژه پایان شهریور آکادمی تحلیل اماری ایران:
۱.دوره پنج روزه مقدماتی تا پیشرفته spss با رویکرد نگارش مقالات isi و گواهینامه بین المللی از اتریش و تدریس دکتر محسن مرادی ۱۹تا۲۳ شهریور
۲.دوره چهار روزه صفرتا صد مدلسازی معادلات ساختاری با نرم افزارهای ایموس و اسمارت پی ال اس ۲۷،۲۸،۲۹،۳۰شهریور همراه با گواهینامه بین المللی از اتریش و تدریس دکتر محسن مرادی هر چهارروز دوره تعطیل است
ساعت دوره ها ۱۳:۳۰تا۲۱:۳۰ می باشد و. هزینه دانشجویی هر دوره ۵۰۰هزارتومان است
ظرفیت محدود رزرو ارسال نام خانوادگی
۱.دوره پنج روزه مقدماتی تا پیشرفته spss با رویکرد نگارش مقالات isi و گواهینامه بین المللی از اتریش و تدریس دکتر محسن مرادی ۱۹تا۲۳ شهریور
۲.دوره چهار روزه صفرتا صد مدلسازی معادلات ساختاری با نرم افزارهای ایموس و اسمارت پی ال اس ۲۷،۲۸،۲۹،۳۰شهریور همراه با گواهینامه بین المللی از اتریش و تدریس دکتر محسن مرادی هر چهارروز دوره تعطیل است
ساعت دوره ها ۱۳:۳۰تا۲۱:۳۰ می باشد و. هزینه دانشجویی هر دوره ۵۰۰هزارتومان است
ظرفیت محدود رزرو ارسال نام خانوادگی