Forwarded from عکس نگار
📊 کارگاه مقدماتی تا پیشرفته spss
🗓هفتم تا یازدهم فروردین ماه ۹۷
👈 در آکادمی تحلیل آماری ایران
✍️ تدریس : دکتر محسن مرادی
💎 هزینه ۵۰۰هزارتومان
🎓باگواهینامه ANCCP ایتالیا
📩 رزرو با ارسال نام خانوادگی به 👇
📱۰۹۱۰۰۰۷۱۸۰۴
جهت ارائه مطالب بیشتر در کانال زیر عضو شوید👇👇
https://t.me/joinchat/AAAAAD_sZ0PdgM2YaSnLvw
🗓هفتم تا یازدهم فروردین ماه ۹۷
👈 در آکادمی تحلیل آماری ایران
✍️ تدریس : دکتر محسن مرادی
💎 هزینه ۵۰۰هزارتومان
🎓باگواهینامه ANCCP ایتالیا
📩 رزرو با ارسال نام خانوادگی به 👇
📱۰۹۱۰۰۰۷۱۸۰۴
جهت ارائه مطالب بیشتر در کانال زیر عضو شوید👇👇
https://t.me/joinchat/AAAAAD_sZ0PdgM2YaSnLvw

Forwarded from Aida Miralmasi
نوبهار است در آن کوش که خوشدل باشی🌷
سالی پر از زیبایی و سلامت رابرای شما همراهان عزیز آرزومندیم.♥️
سالی پر از زیبایی و سلامت رابرای شما همراهان عزیز آرزومندیم.♥️
آکادمی تحلیل آماری ایران
کارگاه۰تا۱۰۰ ایموس با رویکرد نگارش پایان نامه و مقالات isi وتدریس دکتر مرادی ،گواهینامه بین المللی ۲۴،۲۵فروردین با هزینه دانشجویی ۲۵۰هزارتومان رزرو ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴ظرفیت کاملا محدود
ساعت دوره۱۳:۳۰تا ۲۱:۳۰ است
و در روز جمعه و شنبه می باشد که البته شنبه تعطیل رسمی است
و در روز جمعه و شنبه می باشد که البته شنبه تعطیل رسمی است
آکادمی تحلیل آماری ایران
آکادمی تحلیل آماری برگزار می کند:دوره صفر تا صد اسمارت پی ال اس ۶،۷اردیبهشت ، دوره صفر تا صد تحلیل کیفی با نرم افزار مکس کیو دی ای تاریخهای ۱۱،۱۲،۱۳،۱۴ اردیبهشت و دوره جامع فراتحلیل۲۰،۲۱اردیبهشت
دوره صفر تا صد اسمارت پی ال اس با رویکرد نگارش مقالات و رساله های دکتری با هزینه دانشجویی ۲۵۰هزارتومان ششم و هفتم اردیبهشت ماه ساعت ۱۳:۳۰ تا ۲۱:۳۰ با تدریس دکتر محسن مرادی و گواهینامه بین المللی ظرفیت محدود و با اولویت واریز رزرو ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴
آکادمی تحلیل آماری ایران
آکادمی تحلیل آماری برگزار می کند:دوره صفر تا صد اسمارت پی ال اس ۶،۷اردیبهشت ، دوره صفر تا صد تحلیل کیفی با نرم افزار مکس کیو دی ای تاریخهای ۱۱،۱۲،۱۳،۱۴ اردیبهشت و دوره جامع فراتحلیل۲۰،۲۱اردیبهشت
دوره جامع تحلیل کیفی با نرم افزارmaxqda
تاریخهای ۱۱،۱۲،۱۳،۱۴اردیبهشت سه شنبه تا جمعه ساعت ۱۳:۳۰ تا ۲۱:۳۰ و تدریس دکتر محسن مرادی ،گواهینامه بین المللی و هزینه دانشجویی ۵۰۰هزارتومان ظرفیت کاملا محدود و براساس اولویت واریز رزرو با ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴
تاریخهای ۱۱،۱۲،۱۳،۱۴اردیبهشت سه شنبه تا جمعه ساعت ۱۳:۳۰ تا ۲۱:۳۰ و تدریس دکتر محسن مرادی ،گواهینامه بین المللی و هزینه دانشجویی ۵۰۰هزارتومان ظرفیت کاملا محدود و براساس اولویت واریز رزرو با ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴
آکادمی تحلیل آماری ایران
آکادمی تحلیل آماری برگزار می کند:دوره صفر تا صد اسمارت پی ال اس ۶،۷اردیبهشت ، دوره صفر تا صد تحلیل کیفی با نرم افزار مکس کیو دی ای تاریخهای ۱۱،۱۲،۱۳،۱۴ اردیبهشت و دوره جامع فراتحلیل۲۰،۲۱اردیبهشت
دوره جامع فراتحلیل با نرم افزار CMA2
تاریخ ۲۰و۲۱ اردیبهشت ماه ساعت ۱۳:۳۰ تا ۲۱:۳۰با تدریس دکتر محسن مرادی و گواهینامه بین المللی ظرفیت محدود و براساس اولویت واریز هزینه دانشجویی ۳۰۰هزارتومان رزرو ارسال نام و نام خانوادگی به۰۹۱۰۰۰۷۱۸۰۴
تاریخ ۲۰و۲۱ اردیبهشت ماه ساعت ۱۳:۳۰ تا ۲۱:۳۰با تدریس دکتر محسن مرادی و گواهینامه بین المللی ظرفیت محدود و براساس اولویت واریز هزینه دانشجویی ۳۰۰هزارتومان رزرو ارسال نام و نام خانوادگی به۰۹۱۰۰۰۷۱۸۰۴
آکادمی تحلیل آماری ایران
آکادمی تحلیل آماری برگزار می کند:دوره صفر تا صد اسمارت پی ال اس ۶،۷اردیبهشت ، دوره صفر تا صد تحلیل کیفی با نرم افزار مکس کیو دی ای تاریخهای ۱۱،۱۲،۱۳،۱۴ اردیبهشت و دوره جامع فراتحلیل۲۰،۲۱اردیبهشت
دوره پنج روزه مقدماتی تا پیشرفته spss با رویکرد نگارش مقالات و رساله های دکتری و ارشد ۲۵،۲۶،۲۷،۲۸،۲۹اردیبهشت ماه ساعت ۱۳:۳۰ تا ۲۱:۳۰ در آکادمی تحلیل آماری ایران با تدریس دکتر محسن مرادی و گواهینامه بین المللی ظرفیت محدود و براساس اولویت واریز هزینه دانشجویی ۵۰۰هزارتومان رزرو ارسال نام و نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴
http://analysisacademy.com/wp-content/uploads/2018/04/meta-analysis-steps.jpg
آموزش مراحل انجام فراتحلیل
مراحل انجام فراتحليل از نظر پژوهشگران اين عرصه كم وبيش يكسان است و سير فرايند انجام فراتحليل را به شش مرحل ه متوالي تقسيم « راث » و « شل » . مشخصي دارد كرده اند:
1. بيان روشن و واضح مسئله و فرضيه ها،
2. تعيين معيارهاي ورود مطالعات مستقل به فراتحليل،
3. جست وجو و بازيابي منابع و مطالعات مرتبط،
4. كدگذاري داده ها و تحليل هاي آماري مطالعات انتخاب شده،
5. تلخيص و گزارش نتايج،
6. تبيين كاربردهاي نتايج حاصل .
هر نوع تصميم گيري در هر يك از اين مراحل نقشي تعيين كننده در نتايج فراتحليل دارد(راث و شل، ۱۹۹۲). در اين بخش، اين مراحل بيشتر با تكيه بر نظرات آنکلم، ۲۰۰۸ تشريح مي شوند.
فراتحليل گر ابتدا بر حسب علاقه و توانايي خود، حوزه اي خاص را برمي گزيند كه نتايج مطالعات مختلف در باب مسائل آن حوزه متناقض و نيازمند واكاوي جامع باشد . بنابراين، در اين مرحله چنين فرض مي شود كه فراتحليل گر تا حدي از حوز ه پژوهشي، مسئله موردنظر و متون منتشرشده در آن آگاهي دارد و خلأ ها و تناقضات را مي شناسد .
سپس وي براساس اهداف فراتحليل به تدوين سؤال هايي معين و فرضيه هاي واضح براي پژوهش مي پردازد. اين سؤال ها بايد علمي، مبتني بر نظريه و آزمون شدني باشند و پاسخ به آنها در عرصه عمل به كار آيد. براي كاهش احتمال سوگيري در مراحل بعد، فراتحليل گر به تدوين پروتكل پژوهش اقدام مي كند كه روش هاي جست وجو و انتخاب متون، و طرز استخراج و تحليل داده ها را به تفصيل دربردارد. وي در ادامه، به جست وجو و گردآوري مطالعات لازم براي ورود به تحليل اقدام مي كند.
تدوين راهبردهايي دقيق و جامع براي جست وجوي متون پژوهشي مرتبط با هدف فراتحليل در اين مرحله لازم است. هرچه اين راهبردها دقيق و مناسب طرح شوند، احتمال بازيابي متون مرتبط بيشتر مي شود و يافته هاي حاصل از فراتحليل اطمينان پذيري بيشتري مي يابند. در مرحله جست وجو و بازيابي متون مرتبط جست وجويي جامع لازم است . بايد تمامي پايگاه ها ي اطلاعاتي تمام متن و كتابشناسي ها، نمايه نامه ها و چكيده نامه ها را براي بازيابي متون مربوط به مسئله پژوهشي ماخذ مطالعات مد نظر جست وجو كرد. براي اطمينان بيشتر حتي لازم است منابع و ماخذ بازیابی شده را هم جستجوكرد. جست وجوي ناقص متون نتايج حاصل از فراتحليل را مخدوش مي كند.
همزمان، معيارهاي ورود مطالعات بازيابي شده به فراتحليل تعيين مي شوند . مسئله پژوهشي و تعاريف متغيرهاي ملحوظ در فرضيه هاي مورد آزمون در فراتحليل اين معيارها را تعيين مي كنند. از جمله اين معيارها مي توان به مطرح شدن جزئيات روش شناختي مرتبط با متغيرهاي مورد بررسي در فراتحلیل، ذكرشدن ابزارهاي گردآوري داده ها و نمونه گيري، و عرضه كافي نتايج در قالب اطلاعات آماري اشاره كرد . همچنين كيفيت مطالعات وارد شده به فراتحليل نيز از نظر نوع مدرك، تخصص نويسندگان، طرز نمونه گيري، اندازه نمونه، روايي و پايايي ابزارهاي به كاررفته در آنها و غيره وارسي مي شود. معمولاً كيفيت اين مطالعات را چندين (حداقل دو نفر ) ارزياب مستقل بررسي مي كنند تا سوگيري احتمالي ناشي از وارسي ارزيابي منتفي شود . در بررسي كيفيت مطالعات دو عامل روايي دروني (درستي روش پژوهش و نبود سوگيري) و روايي بيروني (قابليت تعميم پذيري و درستي نتايج) بسيار اهميت دارند .
تعداد مطالعات وارد شده به فراتحليل مي تواند حداقل دو مطالعه هم باشد، اين تعداد برحسب تعداد متغيرها و نوع روابط مطرح بين آنها، از قبيل تفاوت ميانگين ها و روابط همبستگي بين متغيرها متفاوت است.(هانتر و همکاران، ۱۹۸۲ پیشنهاد می کنند که تعداد این مطالعات حداقل باید ۲۰ تا باشد.
اكنون بايد داده هاي لازم را از مطالعات مستقل انتخاب شده استخراج و خلاصه كرد. اين مرحله به دقت كافي نياز دارد و بهتر است براي كاهش خطا با استفاده از سياهه وارسي مناسبي، دست كم دو نفر به استخراج و تلخيص نتايج مورد نظر بپردازند. براي اينكه بتوان نتايجي معقول و درست از مطالعات به دست آورد، لازم است تمامي مطالعات مرتبط از اين نظر به دقت بررسي شوند. نه تنها بايد متغيرهاي يكسان را در اين مطالعات وارسي كرد، بلكه آنها بايد در واحدهاي قابل مقايسه نيز اندازه گيري شوند تا بتوان نتايج را به صورت منطقي تركيب كرد. اكنون زمان انجام مرحله آماري فراتحليل فرا مي رسد. رويكرد آماري به فراتحليل و مهم ترين روش هاي آماري مورد استفاده در آن در زير خلاصه شده اند.
در مقالات دیگر و همچنین دوره های فراتحلیل با نرم افزار cma2 که در آکادمی تحلیل آماری ایران برگزار می شود پیرامون مباحث آماری و کاربرد های آن و چگونگی نگارش مقاله یا فصل چهارم رساله ها بر اساس آن مفصل بحث خواهد شد.
آموزش مراحل انجام فراتحلیل
مراحل انجام فراتحليل از نظر پژوهشگران اين عرصه كم وبيش يكسان است و سير فرايند انجام فراتحليل را به شش مرحل ه متوالي تقسيم « راث » و « شل » . مشخصي دارد كرده اند:
1. بيان روشن و واضح مسئله و فرضيه ها،
2. تعيين معيارهاي ورود مطالعات مستقل به فراتحليل،
3. جست وجو و بازيابي منابع و مطالعات مرتبط،
4. كدگذاري داده ها و تحليل هاي آماري مطالعات انتخاب شده،
5. تلخيص و گزارش نتايج،
6. تبيين كاربردهاي نتايج حاصل .
هر نوع تصميم گيري در هر يك از اين مراحل نقشي تعيين كننده در نتايج فراتحليل دارد(راث و شل، ۱۹۹۲). در اين بخش، اين مراحل بيشتر با تكيه بر نظرات آنکلم، ۲۰۰۸ تشريح مي شوند.
فراتحليل گر ابتدا بر حسب علاقه و توانايي خود، حوزه اي خاص را برمي گزيند كه نتايج مطالعات مختلف در باب مسائل آن حوزه متناقض و نيازمند واكاوي جامع باشد . بنابراين، در اين مرحله چنين فرض مي شود كه فراتحليل گر تا حدي از حوز ه پژوهشي، مسئله موردنظر و متون منتشرشده در آن آگاهي دارد و خلأ ها و تناقضات را مي شناسد .
سپس وي براساس اهداف فراتحليل به تدوين سؤال هايي معين و فرضيه هاي واضح براي پژوهش مي پردازد. اين سؤال ها بايد علمي، مبتني بر نظريه و آزمون شدني باشند و پاسخ به آنها در عرصه عمل به كار آيد. براي كاهش احتمال سوگيري در مراحل بعد، فراتحليل گر به تدوين پروتكل پژوهش اقدام مي كند كه روش هاي جست وجو و انتخاب متون، و طرز استخراج و تحليل داده ها را به تفصيل دربردارد. وي در ادامه، به جست وجو و گردآوري مطالعات لازم براي ورود به تحليل اقدام مي كند.
تدوين راهبردهايي دقيق و جامع براي جست وجوي متون پژوهشي مرتبط با هدف فراتحليل در اين مرحله لازم است. هرچه اين راهبردها دقيق و مناسب طرح شوند، احتمال بازيابي متون مرتبط بيشتر مي شود و يافته هاي حاصل از فراتحليل اطمينان پذيري بيشتري مي يابند. در مرحله جست وجو و بازيابي متون مرتبط جست وجويي جامع لازم است . بايد تمامي پايگاه ها ي اطلاعاتي تمام متن و كتابشناسي ها، نمايه نامه ها و چكيده نامه ها را براي بازيابي متون مربوط به مسئله پژوهشي ماخذ مطالعات مد نظر جست وجو كرد. براي اطمينان بيشتر حتي لازم است منابع و ماخذ بازیابی شده را هم جستجوكرد. جست وجوي ناقص متون نتايج حاصل از فراتحليل را مخدوش مي كند.
همزمان، معيارهاي ورود مطالعات بازيابي شده به فراتحليل تعيين مي شوند . مسئله پژوهشي و تعاريف متغيرهاي ملحوظ در فرضيه هاي مورد آزمون در فراتحليل اين معيارها را تعيين مي كنند. از جمله اين معيارها مي توان به مطرح شدن جزئيات روش شناختي مرتبط با متغيرهاي مورد بررسي در فراتحلیل، ذكرشدن ابزارهاي گردآوري داده ها و نمونه گيري، و عرضه كافي نتايج در قالب اطلاعات آماري اشاره كرد . همچنين كيفيت مطالعات وارد شده به فراتحليل نيز از نظر نوع مدرك، تخصص نويسندگان، طرز نمونه گيري، اندازه نمونه، روايي و پايايي ابزارهاي به كاررفته در آنها و غيره وارسي مي شود. معمولاً كيفيت اين مطالعات را چندين (حداقل دو نفر ) ارزياب مستقل بررسي مي كنند تا سوگيري احتمالي ناشي از وارسي ارزيابي منتفي شود . در بررسي كيفيت مطالعات دو عامل روايي دروني (درستي روش پژوهش و نبود سوگيري) و روايي بيروني (قابليت تعميم پذيري و درستي نتايج) بسيار اهميت دارند .
تعداد مطالعات وارد شده به فراتحليل مي تواند حداقل دو مطالعه هم باشد، اين تعداد برحسب تعداد متغيرها و نوع روابط مطرح بين آنها، از قبيل تفاوت ميانگين ها و روابط همبستگي بين متغيرها متفاوت است.(هانتر و همکاران، ۱۹۸۲ پیشنهاد می کنند که تعداد این مطالعات حداقل باید ۲۰ تا باشد.
اكنون بايد داده هاي لازم را از مطالعات مستقل انتخاب شده استخراج و خلاصه كرد. اين مرحله به دقت كافي نياز دارد و بهتر است براي كاهش خطا با استفاده از سياهه وارسي مناسبي، دست كم دو نفر به استخراج و تلخيص نتايج مورد نظر بپردازند. براي اينكه بتوان نتايجي معقول و درست از مطالعات به دست آورد، لازم است تمامي مطالعات مرتبط از اين نظر به دقت بررسي شوند. نه تنها بايد متغيرهاي يكسان را در اين مطالعات وارسي كرد، بلكه آنها بايد در واحدهاي قابل مقايسه نيز اندازه گيري شوند تا بتوان نتايج را به صورت منطقي تركيب كرد. اكنون زمان انجام مرحله آماري فراتحليل فرا مي رسد. رويكرد آماري به فراتحليل و مهم ترين روش هاي آماري مورد استفاده در آن در زير خلاصه شده اند.
در مقالات دیگر و همچنین دوره های فراتحلیل با نرم افزار cma2 که در آکادمی تحلیل آماری ایران برگزار می شود پیرامون مباحث آماری و کاربرد های آن و چگونگی نگارش مقاله یا فصل چهارم رساله ها بر اساس آن مفصل بحث خواهد شد.

http://analysisacademy.com/wp-content/uploads/2018/04/cluster-sampling.png
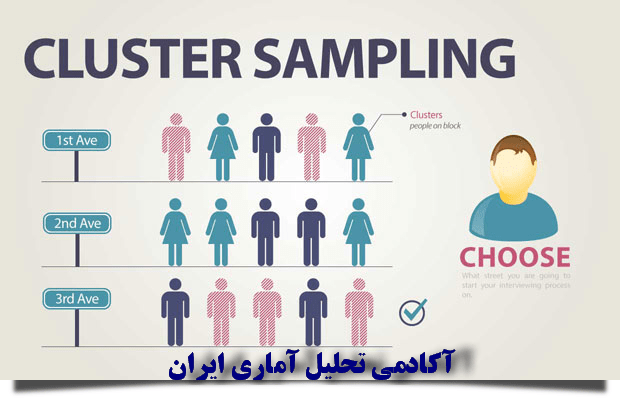
نمونه گیری خوشه ای
اگر در گروه بندی جامعه، واریانس بین طبقات کم ولی در داخل طبقات زیاد باشد(عکس نمونه گیری مطبق)، از روش نمونه گیری خوشه ای استفاده می شود . یعنی اگر در گروه بندی جامعه بین طبقات مختلف تفاوت زیادی وجود نداشته باشد، ولی بین افراد هر طبقه تفاوت زیادی وجود داشته باشد در این صورت از روش نمونه گیری خوشه ای بهره می گیریم در این جا هر طبقه را خوشه می نامند. بر عکس نمونه گیری تصادفی طبقه ای که در آن گروههای همگن هستند در نمونه گیری خوشه ای گروهها ناهمگن هستند و به ویژه این روش زمانی به کار می رود که فهرستی از افراد جامعه در دسترس نیست و یا توزیع جغرافیایی افراد بسیار پراکنده و گسترده است در این نمونه گیری واحد نمونه گیری فرد نیست بلکه شامل گروه یا خوشه ای از افراد است.(میزانی؛۱۳۸۸)
در این نمونه گیری خوشه ای، واحد انتخابی مثل بقیه افراد نیست، بلکه گروهی از افراد می باشد. یعنی تعدادی از افراد بر اساس خصوصیات، متغییرهای مورد مطالعه گروهی را تشکیل می دهند. البته نمونه گیری خوشه ای از نظر اجرا به دو صورت تقسیم می شوند:
۱-نمونه گیری خوشه ای یک مرحله ای که در آنها خوشه ها در مرحله اول انتخاب و از همه عناصر خوشه های انتخاب شده استفاده می شود
۲-نمونه گیری خوشه ای چند مرحله ای که خوشه ها در بیش از یک مرحله اجرا می شوند و در طی مرحله ها برای انتخاب عناصر هر یک از خوشه های انتخاب شده از فن نمونه گیری تصادفی استفاده می شود.
به عنوان مثال اگر قرار است که در بین افراد بالای ۱۵ سال شهروندان تهرانی نظرسنجی به عمل آید می توانیم از میان کل ۲۲ منطقه تهران مثلا ۵ منطقه را به عنوان نمونه خوشه ای انتخاب کرده و به همین ترتیب در داخل هر منطقه یک یا دو حوزه و در داخل هر حوزه یک یا دو بلوک و داخل هر بلوک، از چند خانوار نظرسنجی کنیم.
البته نمونه گیری خوشه ای دقت، ظرافت و اعتبار انواع دیگر نمونه گیری تصافی را ندارد ولی می توان تا حدودی این نقیصه را با انتخاب نمونه های بزرگتر جبران کرد.
نمونه گیری خوشه ای
اگر در گروه بندی جامعه، واریانس بین طبقات کم ولی در داخل طبقات زیاد باشد(عکس نمونه گیری مطبق)، از روش نمونه گیری خوشه ای استفاده می شود . یعنی اگر در گروه بندی جامعه بین طبقات مختلف تفاوت زیادی وجود نداشته باشد، ولی بین افراد هر طبقه تفاوت زیادی وجود داشته باشد در این صورت از روش نمونه گیری خوشه ای بهره می گیریم در این جا هر طبقه را خوشه می نامند. بر عکس نمونه گیری تصادفی طبقه ای که در آن گروههای همگن هستند در نمونه گیری خوشه ای گروهها ناهمگن هستند و به ویژه این روش زمانی به کار می رود که فهرستی از افراد جامعه در دسترس نیست و یا توزیع جغرافیایی افراد بسیار پراکنده و گسترده است در این نمونه گیری واحد نمونه گیری فرد نیست بلکه شامل گروه یا خوشه ای از افراد است.(میزانی؛۱۳۸۸)
در این نمونه گیری خوشه ای، واحد انتخابی مثل بقیه افراد نیست، بلکه گروهی از افراد می باشد. یعنی تعدادی از افراد بر اساس خصوصیات، متغییرهای مورد مطالعه گروهی را تشکیل می دهند. البته نمونه گیری خوشه ای از نظر اجرا به دو صورت تقسیم می شوند:
۱-نمونه گیری خوشه ای یک مرحله ای که در آنها خوشه ها در مرحله اول انتخاب و از همه عناصر خوشه های انتخاب شده استفاده می شود
۲-نمونه گیری خوشه ای چند مرحله ای که خوشه ها در بیش از یک مرحله اجرا می شوند و در طی مرحله ها برای انتخاب عناصر هر یک از خوشه های انتخاب شده از فن نمونه گیری تصادفی استفاده می شود.
به عنوان مثال اگر قرار است که در بین افراد بالای ۱۵ سال شهروندان تهرانی نظرسنجی به عمل آید می توانیم از میان کل ۲۲ منطقه تهران مثلا ۵ منطقه را به عنوان نمونه خوشه ای انتخاب کرده و به همین ترتیب در داخل هر منطقه یک یا دو حوزه و در داخل هر حوزه یک یا دو بلوک و داخل هر بلوک، از چند خانوار نظرسنجی کنیم.
البته نمونه گیری خوشه ای دقت، ظرافت و اعتبار انواع دیگر نمونه گیری تصافی را ندارد ولی می توان تا حدودی این نقیصه را با انتخاب نمونه های بزرگتر جبران کرد.
http://analysisacademy.com/wp-content/uploads/2018/04/regression.png
انواع آزمون های رگرسیون
انواع آزمون های رگرسیون : رگرسیون آزمونی است آماری که به بررسی و مدلسازی میان دو متغیر (مستقل و وابسته) میپردازد. انواع آزمون های رگرسیون به دنبال سنجش تأثیر و میزان اثرگذاری متغیر(های) مستقل بر وابسته است. بنابراین، از طریق رگرسیون میتوان پی برد که آیا میتوان متغیر وابسته را از روی متغیر مستقل پیش بینی کرد، و میزان این بیش بینی احتمالاً چقدر است. انواع آزمون های رگرسیون برای شرایط متفاوت پیشبینی شده است. در هرکدام از این انواع، ممکن است ضریب رگرسیون معنادار نباشد، یعنی آنکه متغیر مستقل تأثیری معنادار روی متغیر وابسته نداشته باشد.که پیش از این در دوره های spss آکادمی تحلیل آماری پیرامون معناداری این ضرایب بحث مفصل انجام گرفته است. در ادامه، به رایجترین انواع رگرسیون اشاره خواهد شد.
رگرسیون خطی ساده (Simple Linear Regression) زمانی از این آزمون استفاده میشود که پژوهشگر میخواهد تأثیر «یک» متغیر مستقل بر روی «یک» متغیر وابسته را مورد سنجش قرار دهد. به این آزمون «رگرسیون دومتغیره» (Bivariate Regression) هم گفته میشود. پژوهشگر باید توجه داشته باشد، زمانی میتوان از آزمون رگرسیون (ساده و چندگانه) استفاده کرد که اولاً مقیاس گردآوری داده فاصلهای یا نسبی باشد و دوماً ارتباط میان دو متغیر به لحاظ آماری معنادار باشد که البته نرم افزار spss قبل از بررسی تاثیر این رابطه را بررسی می کند
رگرسیون چندمتغیره (Multiple Regression): زمانی که تعداد متغیرهای مستقل دو و یا بیشتر باشد، دیگر رگرسیون خطی ساده نمیتواند نتایج دقیقی از تأثیر این متغیرها بهدست دهد. در چنین شرایطی از رگرسیون چندمتغیره استفاده میشود. رگرسیون چندمتغیره با نام «رگرسیون چندگانه» نیز شهرت دارد. همانطور که در دوره های آکادمی بیان شد متغیر های مستقل به ۵ روش متفاوت وارد مدل رگرسیونی می شوند و هر یک از این روش ها کاربرد متفاوتی خواهد داشت. روش همزمان (Enter Method)، روش گامبهگام (Stepwise Method)، روش حذفی (Remove Method)، روش پس رونده (Backward method)، و روش پیش رونده (Forward Method) این ۵ روش ورود متغیر های مستقل به مدل رگرسیونی می باشد.
رگرسیون لجستیک (Logestic Regression) دو وجهی و چند وجهی: اما گاهی اوقات اتفاق می افتد که متغییر وابسته تحقیق در مقیاس فاصله ای/نسبی نبوده و مقیاس آن به صورت اسمی( دووجهی یا چندوجهی) است. یکی از سوالات شرکت کنندگان در دوره های کاربردی SPSS آکادمی تحلیل آماری شرکت می کنند این است که در چنین حالتی با توجه به اینکه پیش فرض اساسی تحلیل رگرسیون مقیاس فاصله ای /نسبی متغییر وابسته است چه باید کرد. رگرسیون لجستیک پیش بینی کننده متغیر وابسته دو وجهی و یا چند وجهی اسمی خواهد بود. البته با توجه به بحث های گسترده در دوره های آکادمی تحلیل آماری بهتر است در این شرایط بجای استفاده از مدل های رگرسیون لجستیک در نرم افزار های مثل spss از نرم افزار های با تخمین های مخصوص به این شرایط مثل mplus استفاده نماییم.
رگرسیون تخمین منحنی (Curve Estimation) : رگرسیون برآورد منحنی از خانواده تحلیل رگرسیون غیر خطی است. این نوع رگرسیون زمانی مورد استفاده قرار می گیرد که رابطه بین متغیر وابسته و متغیر های مستقل به صورت غیر خطی است و بنابراین، نمی توانیم از رگرسیون های خطی استفاده نماییم. در مقالات بعدی این نوع رگرسیون را بطور کامل آموزش خواهم داد.
رگرسیون ترتیبی (ordinal regression): در برخی از پژوهشها و بهخصوص پژوهشهای پیمایشی، ممکن است که متغیر وابسته در سطح سنجش ترتیبی باشد. یعنی شرط اول اجرای رگرسیونهای چندگانه که همانا کمی بودن(فاصلهای یا نسبی بودن) است را نداشته باشد. یعنی ما میتوانیم که به طبقات این متغیر رتبه دهیم اما هرگز نمیتوانیم فاصلهی بین رتبهها را مشخص نماییم.مثلاً متغیر رضایت بجای اینکه توسط یکسری شاخص و سؤال در پرسشنامه سنجیده شده باشد که در انتها بتوان این سؤالات را با فرایند compute به سمت یک متغیر کمی پیوسته حرکت داد، خود شامل یک طیف سه گزینهای رضایت بالا، متوسط یا پایین جهت سنجش است. در این شرایط نیز بجای استفاده از مدل های رگرسیون ترتیبی در نرم افزار های مثل spss از نرم افزار های با تخمین های مخصوص به این شرایط مثل mplus استفاده نماییم.
رگرسیون پروبیت (Probit Regression) : زمانی که خروجی یا متغیر وابسته دارای دو بعد باشد از این نوع رگرسیون استفاده خواهد شد. این نوع رگرسیون با عنوان «مدلهای پروبیت» نیز شناخته شده است. برای مثال، زمانی که بخواهیم متغیرهای مؤثر بر عضو شدن یا نشدن کاربران در کتابخانه را بررسی کنیم، این نوع رگرسیون مناسبتر خواهد بود. این رگرسیون مشابه رگرسیونهای لجستیک است.
محسن مرادی
انواع آزمون های رگرسیون
انواع آزمون های رگرسیون : رگرسیون آزمونی است آماری که به بررسی و مدلسازی میان دو متغیر (مستقل و وابسته) میپردازد. انواع آزمون های رگرسیون به دنبال سنجش تأثیر و میزان اثرگذاری متغیر(های) مستقل بر وابسته است. بنابراین، از طریق رگرسیون میتوان پی برد که آیا میتوان متغیر وابسته را از روی متغیر مستقل پیش بینی کرد، و میزان این بیش بینی احتمالاً چقدر است. انواع آزمون های رگرسیون برای شرایط متفاوت پیشبینی شده است. در هرکدام از این انواع، ممکن است ضریب رگرسیون معنادار نباشد، یعنی آنکه متغیر مستقل تأثیری معنادار روی متغیر وابسته نداشته باشد.که پیش از این در دوره های spss آکادمی تحلیل آماری پیرامون معناداری این ضرایب بحث مفصل انجام گرفته است. در ادامه، به رایجترین انواع رگرسیون اشاره خواهد شد.
رگرسیون خطی ساده (Simple Linear Regression) زمانی از این آزمون استفاده میشود که پژوهشگر میخواهد تأثیر «یک» متغیر مستقل بر روی «یک» متغیر وابسته را مورد سنجش قرار دهد. به این آزمون «رگرسیون دومتغیره» (Bivariate Regression) هم گفته میشود. پژوهشگر باید توجه داشته باشد، زمانی میتوان از آزمون رگرسیون (ساده و چندگانه) استفاده کرد که اولاً مقیاس گردآوری داده فاصلهای یا نسبی باشد و دوماً ارتباط میان دو متغیر به لحاظ آماری معنادار باشد که البته نرم افزار spss قبل از بررسی تاثیر این رابطه را بررسی می کند
رگرسیون چندمتغیره (Multiple Regression): زمانی که تعداد متغیرهای مستقل دو و یا بیشتر باشد، دیگر رگرسیون خطی ساده نمیتواند نتایج دقیقی از تأثیر این متغیرها بهدست دهد. در چنین شرایطی از رگرسیون چندمتغیره استفاده میشود. رگرسیون چندمتغیره با نام «رگرسیون چندگانه» نیز شهرت دارد. همانطور که در دوره های آکادمی بیان شد متغیر های مستقل به ۵ روش متفاوت وارد مدل رگرسیونی می شوند و هر یک از این روش ها کاربرد متفاوتی خواهد داشت. روش همزمان (Enter Method)، روش گامبهگام (Stepwise Method)، روش حذفی (Remove Method)، روش پس رونده (Backward method)، و روش پیش رونده (Forward Method) این ۵ روش ورود متغیر های مستقل به مدل رگرسیونی می باشد.
رگرسیون لجستیک (Logestic Regression) دو وجهی و چند وجهی: اما گاهی اوقات اتفاق می افتد که متغییر وابسته تحقیق در مقیاس فاصله ای/نسبی نبوده و مقیاس آن به صورت اسمی( دووجهی یا چندوجهی) است. یکی از سوالات شرکت کنندگان در دوره های کاربردی SPSS آکادمی تحلیل آماری شرکت می کنند این است که در چنین حالتی با توجه به اینکه پیش فرض اساسی تحلیل رگرسیون مقیاس فاصله ای /نسبی متغییر وابسته است چه باید کرد. رگرسیون لجستیک پیش بینی کننده متغیر وابسته دو وجهی و یا چند وجهی اسمی خواهد بود. البته با توجه به بحث های گسترده در دوره های آکادمی تحلیل آماری بهتر است در این شرایط بجای استفاده از مدل های رگرسیون لجستیک در نرم افزار های مثل spss از نرم افزار های با تخمین های مخصوص به این شرایط مثل mplus استفاده نماییم.
رگرسیون تخمین منحنی (Curve Estimation) : رگرسیون برآورد منحنی از خانواده تحلیل رگرسیون غیر خطی است. این نوع رگرسیون زمانی مورد استفاده قرار می گیرد که رابطه بین متغیر وابسته و متغیر های مستقل به صورت غیر خطی است و بنابراین، نمی توانیم از رگرسیون های خطی استفاده نماییم. در مقالات بعدی این نوع رگرسیون را بطور کامل آموزش خواهم داد.
رگرسیون ترتیبی (ordinal regression): در برخی از پژوهشها و بهخصوص پژوهشهای پیمایشی، ممکن است که متغیر وابسته در سطح سنجش ترتیبی باشد. یعنی شرط اول اجرای رگرسیونهای چندگانه که همانا کمی بودن(فاصلهای یا نسبی بودن) است را نداشته باشد. یعنی ما میتوانیم که به طبقات این متغیر رتبه دهیم اما هرگز نمیتوانیم فاصلهی بین رتبهها را مشخص نماییم.مثلاً متغیر رضایت بجای اینکه توسط یکسری شاخص و سؤال در پرسشنامه سنجیده شده باشد که در انتها بتوان این سؤالات را با فرایند compute به سمت یک متغیر کمی پیوسته حرکت داد، خود شامل یک طیف سه گزینهای رضایت بالا، متوسط یا پایین جهت سنجش است. در این شرایط نیز بجای استفاده از مدل های رگرسیون ترتیبی در نرم افزار های مثل spss از نرم افزار های با تخمین های مخصوص به این شرایط مثل mplus استفاده نماییم.
رگرسیون پروبیت (Probit Regression) : زمانی که خروجی یا متغیر وابسته دارای دو بعد باشد از این نوع رگرسیون استفاده خواهد شد. این نوع رگرسیون با عنوان «مدلهای پروبیت» نیز شناخته شده است. برای مثال، زمانی که بخواهیم متغیرهای مؤثر بر عضو شدن یا نشدن کاربران در کتابخانه را بررسی کنیم، این نوع رگرسیون مناسبتر خواهد بود. این رگرسیون مشابه رگرسیونهای لجستیک است.
محسن مرادی

http://analysisacademy.com/wp-content/uploads/2018/04/Criterion-validity.jpg
روایی ملاک چیست؟
در روایی ملاک(Criterion validity) برای نشان دادن درستی یک سازه از پاره ای از استاندارد ها یا معیارها استفاده می کند. روایی ملاک، از راه مقایسهی یک معرف یا سنجه با سنجه ی دیگری که مورد اعتماد پژوهشگر بوده و برای اندازه گیری همان سازه بکار می رود معلوم می شود. روایی ملاک به دو دسته تقسیم می شوند:
1. روایی توافق یا همزمان (Concurrent validity)
2. روایی پیش بین (Predictive validity)
روایی توافق یا همزمان: برای وجود روایی توافق یا همزمان یک نشانگر یا سنجه باید با نشانگر از پیش تایید شده ی دیگری (که دارای روایی صوری است) متجانس باشد. برای مثال فرض کنید پرسش نامه ای برای اندازه گیری متغیر هوش تهیه می کنیم. برای اینکه این آزمون دارای روایی توافق باشد باید با پرسش نامه های دیگر برای سنجش متغیر هوش بسیار همگن و متجانس باشد( البته با این فرض که هوش در معنای مشابهی در با هم در نظر گرفته شده باشد) این امر بدان معناست که بیشتر افرادی که به سوالات پرسش نامه قلی نمره بالایی را می دهند باید به سنجه های این پرسش نامه نیز نمره بالایی دهند. و برعکس.
این دو دسته سنجه شاید کاملا از یک جنس و همگن نباشند اما اگر همان سازه یا سازه مشابهی را اندازه گیری نمایند، از لحاظ منطقی باید نتایج مشابهی داشته باشد.
روایی پیش بین: هنگامی که یک سنجه یا گویه وقایعی از آینده را پیش بینی می کند که از لحاظ منطقی با یک سازه مرتبط هستند، دارای روایی پیش بین هستند.این نوع روایی نمی تواند برای همه سنجه ها یا سوالات بکار رود. سنجه یا فعالیتی که پیش بینی می شود باید معرف همان سازه، اما از آن متمایز باشد. همچنین روایی پیش بین نباید با بحث پیش بینی متغیر های وابسته در فرضیات علی از جانب سازه ها یا متغیر مستقل اشتباه گرفته شود.
برای مثال آزمون ارزیابی علمی (SAT) که در آمریکا، از بسیاری از دانش آموزان دبیرستانی گرفته می شود، استعداد علمی دانش آموزان و توانایی آنان برای عملکرد خوب در دانشگاه ها را می سنجد. یعنی در حقیقت سنجه های این آزمون عملکرد دانش آموزان را در دانشگاه پیش بینی خواهند کرد. اگر این آزمون روایی پیش بین بالایی داشته باشد، دانش آموزانی که نمره بالایی را در این آزمون کسب می کنند باید در آینده در دانشگاه عملکرد خوبی داشته باشند. اما اگر دانش آموزانی که در این آزمون نمره بالا، متوسط و پایینی کسب می کنند در آینده در دانشگاه عملکرد مشابهی داشته باشند و یا چه بسا دانش آموزان با نمره کمتر عملکرد بهتری هم داشته باشند، یعنی این آزمون دارای روایی پیش بین پایینی است.
روش دیگر برای آزمون روایی پیش بین آن است که گروهی از افراد که ویژگی های خاص دارند انتخاب شوند و نمره آنان با توجه به سازه مورد نظر پیش بینی شود(بسیار پایین یا بسیار بالا). مثلا سنجه های پرسش نامه ای برای اندازه گیری محافظه کاری سیاسی را در نظر بگیرید، بر اساس پیش بینی من، اعضای گروه محافظه کار نمره بالایی در آن کسب می کنند در حالی که گروه لیبرال ها نمرات بسیار پایینی خواهند داشت. اگر روایی پیش بین سنجه های اندازه گیری کننده این مفهوم با این آزمایش و مقایسه بین این دو گروه تایید شود، آنگاه می توان پرسش نامه را برای عموم مردم استفاده نمود.(نیومن، ۲۰۰۶)
روایی ملاک چیست؟
در روایی ملاک(Criterion validity) برای نشان دادن درستی یک سازه از پاره ای از استاندارد ها یا معیارها استفاده می کند. روایی ملاک، از راه مقایسهی یک معرف یا سنجه با سنجه ی دیگری که مورد اعتماد پژوهشگر بوده و برای اندازه گیری همان سازه بکار می رود معلوم می شود. روایی ملاک به دو دسته تقسیم می شوند:
1. روایی توافق یا همزمان (Concurrent validity)
2. روایی پیش بین (Predictive validity)
روایی توافق یا همزمان: برای وجود روایی توافق یا همزمان یک نشانگر یا سنجه باید با نشانگر از پیش تایید شده ی دیگری (که دارای روایی صوری است) متجانس باشد. برای مثال فرض کنید پرسش نامه ای برای اندازه گیری متغیر هوش تهیه می کنیم. برای اینکه این آزمون دارای روایی توافق باشد باید با پرسش نامه های دیگر برای سنجش متغیر هوش بسیار همگن و متجانس باشد( البته با این فرض که هوش در معنای مشابهی در با هم در نظر گرفته شده باشد) این امر بدان معناست که بیشتر افرادی که به سوالات پرسش نامه قلی نمره بالایی را می دهند باید به سنجه های این پرسش نامه نیز نمره بالایی دهند. و برعکس.
این دو دسته سنجه شاید کاملا از یک جنس و همگن نباشند اما اگر همان سازه یا سازه مشابهی را اندازه گیری نمایند، از لحاظ منطقی باید نتایج مشابهی داشته باشد.
روایی پیش بین: هنگامی که یک سنجه یا گویه وقایعی از آینده را پیش بینی می کند که از لحاظ منطقی با یک سازه مرتبط هستند، دارای روایی پیش بین هستند.این نوع روایی نمی تواند برای همه سنجه ها یا سوالات بکار رود. سنجه یا فعالیتی که پیش بینی می شود باید معرف همان سازه، اما از آن متمایز باشد. همچنین روایی پیش بین نباید با بحث پیش بینی متغیر های وابسته در فرضیات علی از جانب سازه ها یا متغیر مستقل اشتباه گرفته شود.
برای مثال آزمون ارزیابی علمی (SAT) که در آمریکا، از بسیاری از دانش آموزان دبیرستانی گرفته می شود، استعداد علمی دانش آموزان و توانایی آنان برای عملکرد خوب در دانشگاه ها را می سنجد. یعنی در حقیقت سنجه های این آزمون عملکرد دانش آموزان را در دانشگاه پیش بینی خواهند کرد. اگر این آزمون روایی پیش بین بالایی داشته باشد، دانش آموزانی که نمره بالایی را در این آزمون کسب می کنند باید در آینده در دانشگاه عملکرد خوبی داشته باشند. اما اگر دانش آموزانی که در این آزمون نمره بالا، متوسط و پایینی کسب می کنند در آینده در دانشگاه عملکرد مشابهی داشته باشند و یا چه بسا دانش آموزان با نمره کمتر عملکرد بهتری هم داشته باشند، یعنی این آزمون دارای روایی پیش بین پایینی است.
روش دیگر برای آزمون روایی پیش بین آن است که گروهی از افراد که ویژگی های خاص دارند انتخاب شوند و نمره آنان با توجه به سازه مورد نظر پیش بینی شود(بسیار پایین یا بسیار بالا). مثلا سنجه های پرسش نامه ای برای اندازه گیری محافظه کاری سیاسی را در نظر بگیرید، بر اساس پیش بینی من، اعضای گروه محافظه کار نمره بالایی در آن کسب می کنند در حالی که گروه لیبرال ها نمرات بسیار پایینی خواهند داشت. اگر روایی پیش بین سنجه های اندازه گیری کننده این مفهوم با این آزمایش و مقایسه بین این دو گروه تایید شود، آنگاه می توان پرسش نامه را برای عموم مردم استفاده نمود.(نیومن، ۲۰۰۶)

http://analysisacademy.com/wp-content/uploads/2018/04/slide_1.jpg
اندازه گیری در پژوهش کمی و کیفی
هم پژوهش گرهای کمی و هم پژوهشگرهای کیفی، از روش های دقیق و نظام مندی برای گردآوری داده های با کیفیت استفاده می کنند. در هر دو شیوه کمی و کیفی داده ها شواهد تجربی مفاهیم هستند که از راه اندازه گیری به یکدیگر مرتبط می شوند. ولی تفاوت در شیوه پژوهش و نوع داده ها به معنای تفاوت در نگاه به فرآیند اندازه گیری است و طراحی سنجه ها برای اندازه گیری متغییرها مرحله مهمی در طرح ریزی یک پژوهش کمی است. پژوهشگرهای کیفی برای اندازه گیری از شیوه های متنوع تری استفاده می کنند. این دو رویکرد سه تفاوت اساسی با یکدیگر دارند:
یکی از تفاوتهای میان این دو به زمان بندی باز می گردد. پژوهش گرهای کمی ابتدا درباره متغییرها اندیشه می کند. سپس در طول مرحله برنامه ریزی که پیش از گردآوری یا تحلیل داده ها می باشد، آنها را به کنش های خاصی تبدیل می کنند. پژوهشگرهای کیفی کار اندازه گیری را در طول فرآیند گردآوری داده ها انجام می دهند.
تفاوت دوم به خود داده ها باز می گردد. پژوهشگرهای کمی از فنونی استفاده می کنند که داده ها را به ارقام تبدیل می کند. آنان قیاس را به کار می برند و از ایده ها و مفاهیم انتزاعی به سمت فنون خاص گردآوری داده ها حرکت می کنند. سپس از داده ها به اعداد و ارقام دقیق می رسند. چنین اعداد و ارقامی، ترجمان ایده های انتزاعی به زبان تجربی است. گاهی برای پژوهش گرهای کیفی داده ها به شکل عدد و رقم است اما در اغلب مواقع شامل واژگان کلامی و مکتوب، کنش ها، صداها، نمادها، اشیا مادی یا تصاویر(برای مثال نقشه ها، عکس ها، فیلم ها و مانند آن) است. پژوهشگر کیفی همه مشاهدات خود را به اعداد و ارقام تبدیل نمی کنند بلکه با استفاده از بسیاری از فرآیندهای منعطف و سیال داده ها را به صورت شکل ها و اندازه گیری های گوناگون در می آورد.
تفاوت سوم در این شیوه، به چگونگی برقراری ارتباط میان سازه و داده باز می گردد. پژوهشگرهای کمی بیش از گردآوری داده ها مفاهیمی را مدنظر قرار می دهند. آنان با استفاده از یک رشته فنون اندازه گیری پلی میان مفاهیم و داده ها برقرار می کنند.پژوهشگرهای کیفی هم پیش از گردآوری داده ها ایده هایی در ذهن دارند اما بسیاری از مفاهیم و نه همه آنها را در طول فرآیند گرداوری داده ها می سازند. آنان داده ها و مفاهیم را به طور همزمان و در تعامل با هم بررسی می کنند. پژوهش گرهای کیفی پژوهش را با گردآوری داده ها آغاز می کنند و سپس بر مبنای آنچه با آ روبه رو می شوند به سنجش آنها می پردازند. آنان به موازاتی که داده ها را گردآوری می کنند به بازاندیشی فرآیندها اقدام کرده و ایده های نویی مطرح می کنند. چنین ایده هایی به آنان جهت داده ها و راههای جدید اندازه گیری را نشان می دهد راههای جدید اندازه گیری به نوبه خود شیوه گردآوری داده ها را تعیین می کند. پژوهش گرها با این روش میان ایده ها و داده ها فرآیندی مستمر و رفت و برگشتی برقرار می کنند.
اندازه گیری در پژوهش کمی و کیفی
هم پژوهش گرهای کمی و هم پژوهشگرهای کیفی، از روش های دقیق و نظام مندی برای گردآوری داده های با کیفیت استفاده می کنند. در هر دو شیوه کمی و کیفی داده ها شواهد تجربی مفاهیم هستند که از راه اندازه گیری به یکدیگر مرتبط می شوند. ولی تفاوت در شیوه پژوهش و نوع داده ها به معنای تفاوت در نگاه به فرآیند اندازه گیری است و طراحی سنجه ها برای اندازه گیری متغییرها مرحله مهمی در طرح ریزی یک پژوهش کمی است. پژوهشگرهای کیفی برای اندازه گیری از شیوه های متنوع تری استفاده می کنند. این دو رویکرد سه تفاوت اساسی با یکدیگر دارند:
یکی از تفاوتهای میان این دو به زمان بندی باز می گردد. پژوهش گرهای کمی ابتدا درباره متغییرها اندیشه می کند. سپس در طول مرحله برنامه ریزی که پیش از گردآوری یا تحلیل داده ها می باشد، آنها را به کنش های خاصی تبدیل می کنند. پژوهشگرهای کیفی کار اندازه گیری را در طول فرآیند گردآوری داده ها انجام می دهند.
تفاوت دوم به خود داده ها باز می گردد. پژوهشگرهای کمی از فنونی استفاده می کنند که داده ها را به ارقام تبدیل می کند. آنان قیاس را به کار می برند و از ایده ها و مفاهیم انتزاعی به سمت فنون خاص گردآوری داده ها حرکت می کنند. سپس از داده ها به اعداد و ارقام دقیق می رسند. چنین اعداد و ارقامی، ترجمان ایده های انتزاعی به زبان تجربی است. گاهی برای پژوهش گرهای کیفی داده ها به شکل عدد و رقم است اما در اغلب مواقع شامل واژگان کلامی و مکتوب، کنش ها، صداها، نمادها، اشیا مادی یا تصاویر(برای مثال نقشه ها، عکس ها، فیلم ها و مانند آن) است. پژوهشگر کیفی همه مشاهدات خود را به اعداد و ارقام تبدیل نمی کنند بلکه با استفاده از بسیاری از فرآیندهای منعطف و سیال داده ها را به صورت شکل ها و اندازه گیری های گوناگون در می آورد.
تفاوت سوم در این شیوه، به چگونگی برقراری ارتباط میان سازه و داده باز می گردد. پژوهشگرهای کمی بیش از گردآوری داده ها مفاهیمی را مدنظر قرار می دهند. آنان با استفاده از یک رشته فنون اندازه گیری پلی میان مفاهیم و داده ها برقرار می کنند.پژوهشگرهای کیفی هم پیش از گردآوری داده ها ایده هایی در ذهن دارند اما بسیاری از مفاهیم و نه همه آنها را در طول فرآیند گرداوری داده ها می سازند. آنان داده ها و مفاهیم را به طور همزمان و در تعامل با هم بررسی می کنند. پژوهش گرهای کیفی پژوهش را با گردآوری داده ها آغاز می کنند و سپس بر مبنای آنچه با آ روبه رو می شوند به سنجش آنها می پردازند. آنان به موازاتی که داده ها را گردآوری می کنند به بازاندیشی فرآیندها اقدام کرده و ایده های نویی مطرح می کنند. چنین ایده هایی به آنان جهت داده ها و راههای جدید اندازه گیری را نشان می دهد راههای جدید اندازه گیری به نوبه خود شیوه گردآوری داده ها را تعیین می کند. پژوهش گرها با این روش میان ایده ها و داده ها فرآیندی مستمر و رفت و برگشتی برقرار می کنند.

آکادمی تحلیل آماری ایران
دوره صفر تا صد اسمارت پی ال اس با رویکرد نگارش مقالات و رساله های دکتری با هزینه دانشجویی ۲۵۰هزارتومان ششم و هفتم اردیبهشت ماه ساعت ۱۳:۳۰ تا ۲۱:۳۰ با تدریس دکتر محسن مرادی و گواهینامه بین المللی ظرفیت محدود و با اولویت واریز رزرو ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴
همراهان گرامی کارگاه اسمارت پی ال اس فردا و پس فردا شش و هفت اردیبهشت کاملا پر است لطفا واریز جدید نفرمایید
در حال حاضر فقط برای دوره فراتحلیل ۲۰،۲۱ اردیبهشت و اس پی اس اس ۲۵تا۲۹اردیبهشت جا داریم
برای دوره کیفی هم که ۱۱ تا ۱۴ اردیبهشت است تعداد محدودی جا هست
در حال حاضر فقط برای دوره فراتحلیل ۲۰،۲۱ اردیبهشت و اس پی اس اس ۲۵تا۲۹اردیبهشت جا داریم
برای دوره کیفی هم که ۱۱ تا ۱۴ اردیبهشت است تعداد محدودی جا هست
ضمنا با توجه به مصاحبه آزمون دکتری هماهنکی جدیدی برای دریافت مدارک از
MPT Academy
اتریش هم که id مدارک در خود سایت مرجع ثبت می نماید نیز برای هر سه دوره تحلیل کیفی فراتحلیل و اس پی اس اس انجام شد
MPT Academy
اتریش هم که id مدارک در خود سایت مرجع ثبت می نماید نیز برای هر سه دوره تحلیل کیفی فراتحلیل و اس پی اس اس انجام شد
آکادمی تحلیل آماری ایران
Photo
نمونه گواهینامه MPT academy
اتریش
اتریش