
http://analysisacademy.com/wp-content/uploads/2016/11/lisrelacademy1.png
@analysisacademy
لیزرل " مدل هاي ساختار كوواريانس"
طي 20 سال گذشته، از زماني كه كارل جورسكاگ براي اولين بار مدل ليزرل را معرفي كرد، مدل هاي ساختار كوواريانس اشتهار قابل توجهي در ميان پژوهشگرانِ بسياري از زمينه هاي تحقيقي و كاربردي كسب كرده است. اين اشتهار اساساً به دو دليل بوده است،اول اين كه اين مدل ها قادرند روابط علّي و تئوريكي را كه پژوهشگران به هنگام تفكر در مورد فراگردهاي علّي و روابط بين متغيرها در نظر دارند، به طور بسيار ساده و ملموس منعكس كنند. دوم اينكه نرم افزارهاي كامپيوتري توسعه داده شده، برآورد پارامترهاي مدل را بسيار آسان ساخته و برآورد مدل هاي بزرگ و گاهي بسيار دقيق و پيچيده را نيز در قالبي بسيار ساده امكان پذير ساخته است. در ساير مدل هاي تحليلي، روش معمولاً تعيين كننده چهره هاي مدل مورد نظر بوده و پژوهش در بسياري از موارد به وسيله روش هدايت مي شود، در حالي كه در مدل هاي ساختار كوواريانس، هدايت پژوهش از طريق تئوري صورت مي گيرد. در يك مدل ساختار كوواريانس نخست روابط بين متغيرها توسط تئوري در قالب يك نمودار مسير مشخص، و سپس پارامترهاي مربوط به آن مدل به خصوص برآورد و مورد تجزيه و تحليل قرار مي گيرند . پارامترهاي برآورد شده توسط نرم افزار كامپيوتري دقيقاً مشابه ضرايب رگرسيوني در تحليل رگرسيون چند متغيره مي باشند آناليز ساختار كوواريانس يا مدل هاي ليزرل براي اولين بار توسط باك و باگ من براي توصيف روش تحليل عاملي تأييدي بكار گرفته شد. اين روش تلاش مي كند كه روابط بين مجموعه اي از متغيرهاي عيني مشاهده شده را در قالب تعدادمحدودتري متغيرهاي نهفته ، بيان كند . كاربرد روش تحليل ساختار كوواريانس معمولاً نيازمند بكارگيري مدل ها و توابع پيچيده رياضي و بيشينه كردن توابع براي چندين متغير است. در مسير حل چنين مشكلي جورسكاگ و سوربم طي سالهاي 1976 تا 1989نرم افزارِ كامپيوتري به نام LISREL را توسعه دادند. توسعه اين نرم افزار نقشي اساسي در پذيرش و كاربرد روش تحليل ساختار كوواريانس داشته است، اين مدل ها به نام مدل هاي ليزرل مشهور شده اند.
@analysisacademy
لیزرل " مدل هاي ساختار كوواريانس"
طي 20 سال گذشته، از زماني كه كارل جورسكاگ براي اولين بار مدل ليزرل را معرفي كرد، مدل هاي ساختار كوواريانس اشتهار قابل توجهي در ميان پژوهشگرانِ بسياري از زمينه هاي تحقيقي و كاربردي كسب كرده است. اين اشتهار اساساً به دو دليل بوده است،اول اين كه اين مدل ها قادرند روابط علّي و تئوريكي را كه پژوهشگران به هنگام تفكر در مورد فراگردهاي علّي و روابط بين متغيرها در نظر دارند، به طور بسيار ساده و ملموس منعكس كنند. دوم اينكه نرم افزارهاي كامپيوتري توسعه داده شده، برآورد پارامترهاي مدل را بسيار آسان ساخته و برآورد مدل هاي بزرگ و گاهي بسيار دقيق و پيچيده را نيز در قالبي بسيار ساده امكان پذير ساخته است. در ساير مدل هاي تحليلي، روش معمولاً تعيين كننده چهره هاي مدل مورد نظر بوده و پژوهش در بسياري از موارد به وسيله روش هدايت مي شود، در حالي كه در مدل هاي ساختار كوواريانس، هدايت پژوهش از طريق تئوري صورت مي گيرد. در يك مدل ساختار كوواريانس نخست روابط بين متغيرها توسط تئوري در قالب يك نمودار مسير مشخص، و سپس پارامترهاي مربوط به آن مدل به خصوص برآورد و مورد تجزيه و تحليل قرار مي گيرند . پارامترهاي برآورد شده توسط نرم افزار كامپيوتري دقيقاً مشابه ضرايب رگرسيوني در تحليل رگرسيون چند متغيره مي باشند آناليز ساختار كوواريانس يا مدل هاي ليزرل براي اولين بار توسط باك و باگ من براي توصيف روش تحليل عاملي تأييدي بكار گرفته شد. اين روش تلاش مي كند كه روابط بين مجموعه اي از متغيرهاي عيني مشاهده شده را در قالب تعدادمحدودتري متغيرهاي نهفته ، بيان كند . كاربرد روش تحليل ساختار كوواريانس معمولاً نيازمند بكارگيري مدل ها و توابع پيچيده رياضي و بيشينه كردن توابع براي چندين متغير است. در مسير حل چنين مشكلي جورسكاگ و سوربم طي سالهاي 1976 تا 1989نرم افزارِ كامپيوتري به نام LISREL را توسعه دادند. توسعه اين نرم افزار نقشي اساسي در پذيرش و كاربرد روش تحليل ساختار كوواريانس داشته است، اين مدل ها به نام مدل هاي ليزرل مشهور شده اند.
http://analysisacademy.com/wp-content/uploads/2016/11/Capture.png
analysisacademy@
مراحل عملیاتی مدل سازی معادلات ساختاری
کلاین در کتاب مدل سازی معادلات ساختاری خود که در سال 2005 به نگارش درآورد مراحل و فرایند مدل سازی معادلات ساختاری را در قالب یک الگوریتم به صورت زیر خلاصه نمود. میتوان گفت این الگوریتم به صورتی بسیار جامع تمام فرایند های این روش آماری پیشرفته را درون خود به نمایش می گذارد.
تعیین مدل: دقت شود در این مرحله ما هنوز وارد نرم افزار خاصی نشده ایم و شرط ایجاد مدلی مناسب برای تحقیق تسلط کامل بر ادبیات و چارچوب نظری آن حوزه تحقیقاتی مورد نظر محقق است.
شناسایی سنجه های مدل (اگر به درستی سنجه ها و شاخص های ارزیابی مدل شناسایی نشده به مرحله اول بر میگردیم).در این مرحله باید دقت کنیم که مدل سازی معادلات ساختاری هم در حقیقت یک سری معادلات رگرسیون خطی است که در درون هم برآورد می شوند. بنابراین در حل این معادلات همواره باید تعداد معادلات و مجهولات با هم برابر باشد.
انتخاب مقیاس مناسب برای اندازه گیری و سنجش متغیر ها( یعنی تعریف عملیاتی مناسب برای اندازه گیری متغیر ها) و جمع آوری داده های خام در عملیت میدانی و غربال و پیش پردازش آن ها
مرحله چهارم این الگوریتم خود شامل سه بخش است.
4-1 با اجرای مدل بر مبنای مشاهدات محقق پارامتر های مدل تخمین زده شود.این تخمین می تواند در قالب روش های مختلفی مثل حداکثر درستنمایی و یا حداقل مربعات جزئی و یا حداقل مربعات غیر وزنی و غیره باشد که در بخش های مختلف سایت آکادمی تحلیل آماری ایران و نیز کارگاه های این موسسه با این روش ها و نرم افزار های آن آشنا شده ایم. سپس مدل پژوهشگر ارزیابی می گردد. یعنی باید مدل پژوهش از نقطه نظر برازش بررسی گردد و باید مشخص شود که آیا مدل محقق بر اساس مشاهدات او با مدل مورد انتظار در جامعه همخوانی دارد یا نه؟ ( اگر برازش ضعیف باشد باید به مرحله پنجم رفت)
4-2بعد از اجرای مدل در دو قالب مدل اندازه گیری و مدل ساختاری و بدست آمدن پارامتر هایی مثل بار های عاملی و ضرایب مسیر و ضرایب کواریانس و .... باید این ضرایب بر اساس شاخص های روایی و پایایی و برازش مورد تفسیر قرار گیرد.
4-3.حال بعد از تفسیر و ارزیابی و اصلاح مدل نزدیکترین مدل به مدل مورد نظر در جامعه را بر میگزینیم. در حقیقت این کار بر اساس پیشنهاداتی است که نرم افزار ها به ما ارائه می کنند و ما قبلا در دوره های آکادمی به دانشجویان عزیز آموزش داده ایم که چه پیشنهاداتی را در جهت مشخص سازی مجدد مدل باید بپذیرند. اگر مدل مشاهده شده با مدل مورد انتظار در واقعیت تطابق نداشت به مرحله 4 برمی گردیم.
6.نتایج مدل نهایی را تفسیر میکنیم.
محسن مرادی
analysisacademy@
مراحل عملیاتی مدل سازی معادلات ساختاری
کلاین در کتاب مدل سازی معادلات ساختاری خود که در سال 2005 به نگارش درآورد مراحل و فرایند مدل سازی معادلات ساختاری را در قالب یک الگوریتم به صورت زیر خلاصه نمود. میتوان گفت این الگوریتم به صورتی بسیار جامع تمام فرایند های این روش آماری پیشرفته را درون خود به نمایش می گذارد.
تعیین مدل: دقت شود در این مرحله ما هنوز وارد نرم افزار خاصی نشده ایم و شرط ایجاد مدلی مناسب برای تحقیق تسلط کامل بر ادبیات و چارچوب نظری آن حوزه تحقیقاتی مورد نظر محقق است.
شناسایی سنجه های مدل (اگر به درستی سنجه ها و شاخص های ارزیابی مدل شناسایی نشده به مرحله اول بر میگردیم).در این مرحله باید دقت کنیم که مدل سازی معادلات ساختاری هم در حقیقت یک سری معادلات رگرسیون خطی است که در درون هم برآورد می شوند. بنابراین در حل این معادلات همواره باید تعداد معادلات و مجهولات با هم برابر باشد.
انتخاب مقیاس مناسب برای اندازه گیری و سنجش متغیر ها( یعنی تعریف عملیاتی مناسب برای اندازه گیری متغیر ها) و جمع آوری داده های خام در عملیت میدانی و غربال و پیش پردازش آن ها
مرحله چهارم این الگوریتم خود شامل سه بخش است.
4-1 با اجرای مدل بر مبنای مشاهدات محقق پارامتر های مدل تخمین زده شود.این تخمین می تواند در قالب روش های مختلفی مثل حداکثر درستنمایی و یا حداقل مربعات جزئی و یا حداقل مربعات غیر وزنی و غیره باشد که در بخش های مختلف سایت آکادمی تحلیل آماری ایران و نیز کارگاه های این موسسه با این روش ها و نرم افزار های آن آشنا شده ایم. سپس مدل پژوهشگر ارزیابی می گردد. یعنی باید مدل پژوهش از نقطه نظر برازش بررسی گردد و باید مشخص شود که آیا مدل محقق بر اساس مشاهدات او با مدل مورد انتظار در جامعه همخوانی دارد یا نه؟ ( اگر برازش ضعیف باشد باید به مرحله پنجم رفت)
4-2بعد از اجرای مدل در دو قالب مدل اندازه گیری و مدل ساختاری و بدست آمدن پارامتر هایی مثل بار های عاملی و ضرایب مسیر و ضرایب کواریانس و .... باید این ضرایب بر اساس شاخص های روایی و پایایی و برازش مورد تفسیر قرار گیرد.
4-3.حال بعد از تفسیر و ارزیابی و اصلاح مدل نزدیکترین مدل به مدل مورد نظر در جامعه را بر میگزینیم. در حقیقت این کار بر اساس پیشنهاداتی است که نرم افزار ها به ما ارائه می کنند و ما قبلا در دوره های آکادمی به دانشجویان عزیز آموزش داده ایم که چه پیشنهاداتی را در جهت مشخص سازی مجدد مدل باید بپذیرند. اگر مدل مشاهده شده با مدل مورد انتظار در واقعیت تطابق نداشت به مرحله 4 برمی گردیم.
6.نتایج مدل نهایی را تفسیر میکنیم.
محسن مرادی

http://analysisacademy.com/wp-content/uploads/2016/11/modellisrel.jpg
@analysisacademy
روش های بررسی اعتبار مدل در مدل سازی معادلات ساختاری
مدل های با نمونه های چندگانه در مدل سازی معادلات ساختاری
یکی از ویژگی های مدل سازی معادله ساختاری امکان مطالعه یک مدل نظری با بیش از یک نمونه به طور همزمان است. استفاده از یک مدل نظری در بین نمونه ها می تواند برای تعیین درجه تشابه شاخص های برازش، برآورد پارامترها و خطاهای معیار مفید باشد. رویکرد نمونه های چندگانه همچنین می تواند در تحلیل داده های شبه آزمایشی، آزمایشی، مقطعی یا طولی مورد استفاده قرار گیرند. به طور کلی هنگام استفاده از نمونه های چندگانه می توان به موارد زیر دست یافت:
الف. پارامترها به طور مجزا برای هر نمونه مستقل برآورد شوند، در این حالت محقق می تواند برای هر یک از گروه ها نتایج حاصل از برآورد پارامترها، شاخص های نیکویی برازش و... را با یکدیگر مقایسه نماید. اما در این روش مقایسه های آماری برابری پارامترها در بین گروه ها نمی توانند انجام شوند.
ب. یکسانی پارامترهای تدوین شده یا ماتریس های پارامتر در بین گروه ها آزمون شوند، در این صورت می توان به لحاظ آماری تعیین کرد که آیا ماتریس های تشکیل دهنده پارامترها و یا هریک از پارامترها به طور خاص در بین گروه ها یکسان هستند یا خیر؟
ج. وجود تفاوت های میانگین گروهی برای متغیرهای مشاهده شده و یا برای هر معادله ساختاری آزمون می شود، در این مورد محقق می تواند به لحاظ آماری به این سوال پاسخ دهد که آیا تفاوتی بین میانگین ها برای متغیرهای مشاهده شده و یا معادله های ساختاری وجوددارد یا خیر؟
اعتبار متقاطع در مدل سازی معادلات ساختاری
تکرار یک مطالعه با استفاده از مجموعه ی دومی از داده ها با توجه به زمان، هزینه ی لازم و منابع در دسترس اغلب امکان پذیر نیست. یک راه حل جایگزین دو نیمه کردن داده های اصلی به طور تصادفی می باشد البته با این فرض که حجم نمونه به اندازه کافی بزرگ است. برای استفاده از این روش شاخص های مختلفی معرفی شده اند که در ادامه به معرفی آن ها می پردازیم.
شاخص ECVI براون و کادک (1989) شاخص اعتبار متقاطع را برای مقایسه مدل های جایگزین پیشنهاد کرده اند. مدل جایگزینی که کمترین مقدار ECVI را داشته باشد به عنوان باثبات ترین مدل در جامعه ارزیابی می شود.
شاخص CVI کادک و براون (1993) این شاخص اعتبار متقاطع را برای تحلیل ساختار کواریانس پیشنهاد کرده اند که با دو نیمه کردن یک نمونه حاصل می شود. نمونه فرعی اول به عنوان نمونه ملاک و دومین نمونه به عنوان نمونه اعتبار به کار می رود. در این روش ماتریس کواریانس بازتولید شده از نمونه ملاک با ماتریس کواریانس اقتباس شده از نمونه فرعی مقایسه می شود. مقادیر نزدیک به صفر برای این شاخص نشان دهنده ی وجود اعتبار متقاطع برای مدل است.
روش شبیه سازی در مدل سازی معادلات ساختاری
روش دیگر برای بررسی اعتبار مدل استفاده از داده های شبیه سازی شده می باشد. در این حالت با استفاده از روش شبیه سازی مونت کارلو و تولید داده های خام، ماتریس واریانس و کواریانس جامعه شبیه سازی می شود. به این ترتیب با استفاده از ماتریس های تولید شده و شاخص های معرفی شده در قسمت قبل در مورد اعتبار مدل می توان تصمیم گیری نمود. نرم افزارهای LISREL، Amos و EQS قابلیت شبیه سازی و مقایسه های لازم را دارا هستند.
@analysisacademy
روش های بررسی اعتبار مدل در مدل سازی معادلات ساختاری
مدل های با نمونه های چندگانه در مدل سازی معادلات ساختاری
یکی از ویژگی های مدل سازی معادله ساختاری امکان مطالعه یک مدل نظری با بیش از یک نمونه به طور همزمان است. استفاده از یک مدل نظری در بین نمونه ها می تواند برای تعیین درجه تشابه شاخص های برازش، برآورد پارامترها و خطاهای معیار مفید باشد. رویکرد نمونه های چندگانه همچنین می تواند در تحلیل داده های شبه آزمایشی، آزمایشی، مقطعی یا طولی مورد استفاده قرار گیرند. به طور کلی هنگام استفاده از نمونه های چندگانه می توان به موارد زیر دست یافت:
الف. پارامترها به طور مجزا برای هر نمونه مستقل برآورد شوند، در این حالت محقق می تواند برای هر یک از گروه ها نتایج حاصل از برآورد پارامترها، شاخص های نیکویی برازش و... را با یکدیگر مقایسه نماید. اما در این روش مقایسه های آماری برابری پارامترها در بین گروه ها نمی توانند انجام شوند.
ب. یکسانی پارامترهای تدوین شده یا ماتریس های پارامتر در بین گروه ها آزمون شوند، در این صورت می توان به لحاظ آماری تعیین کرد که آیا ماتریس های تشکیل دهنده پارامترها و یا هریک از پارامترها به طور خاص در بین گروه ها یکسان هستند یا خیر؟
ج. وجود تفاوت های میانگین گروهی برای متغیرهای مشاهده شده و یا برای هر معادله ساختاری آزمون می شود، در این مورد محقق می تواند به لحاظ آماری به این سوال پاسخ دهد که آیا تفاوتی بین میانگین ها برای متغیرهای مشاهده شده و یا معادله های ساختاری وجوددارد یا خیر؟
اعتبار متقاطع در مدل سازی معادلات ساختاری
تکرار یک مطالعه با استفاده از مجموعه ی دومی از داده ها با توجه به زمان، هزینه ی لازم و منابع در دسترس اغلب امکان پذیر نیست. یک راه حل جایگزین دو نیمه کردن داده های اصلی به طور تصادفی می باشد البته با این فرض که حجم نمونه به اندازه کافی بزرگ است. برای استفاده از این روش شاخص های مختلفی معرفی شده اند که در ادامه به معرفی آن ها می پردازیم.
شاخص ECVI براون و کادک (1989) شاخص اعتبار متقاطع را برای مقایسه مدل های جایگزین پیشنهاد کرده اند. مدل جایگزینی که کمترین مقدار ECVI را داشته باشد به عنوان باثبات ترین مدل در جامعه ارزیابی می شود.
شاخص CVI کادک و براون (1993) این شاخص اعتبار متقاطع را برای تحلیل ساختار کواریانس پیشنهاد کرده اند که با دو نیمه کردن یک نمونه حاصل می شود. نمونه فرعی اول به عنوان نمونه ملاک و دومین نمونه به عنوان نمونه اعتبار به کار می رود. در این روش ماتریس کواریانس بازتولید شده از نمونه ملاک با ماتریس کواریانس اقتباس شده از نمونه فرعی مقایسه می شود. مقادیر نزدیک به صفر برای این شاخص نشان دهنده ی وجود اعتبار متقاطع برای مدل است.
روش شبیه سازی در مدل سازی معادلات ساختاری
روش دیگر برای بررسی اعتبار مدل استفاده از داده های شبیه سازی شده می باشد. در این حالت با استفاده از روش شبیه سازی مونت کارلو و تولید داده های خام، ماتریس واریانس و کواریانس جامعه شبیه سازی می شود. به این ترتیب با استفاده از ماتریس های تولید شده و شاخص های معرفی شده در قسمت قبل در مورد اعتبار مدل می توان تصمیم گیری نمود. نرم افزارهای LISREL، Amos و EQS قابلیت شبیه سازی و مقایسه های لازم را دارا هستند.

http://analysisacademy.com/wp-content/uploads/2016/11/modellisrel.jpg
@analysisacademy
خودگردان سازی در مدل سازی معادلات ساختاری
روش خودگردان سازی با یک مجموعه داده از نمونه های تصادفی به عنوان جایگزینی برای یک جامعه برخورد می کند و برای تولید برآورد ها و خطاهای معیار خودگردان نمونه ای، به دفعات مشخصی نمونه گیری مجدد را انجام می دهد. متوسط این برآورد ها و خطاهای معیار خودگردان نمونه ای محاسبه شده و نتایج برای به دست آوردن فاصله اطمینان برآوردهای خودگردان بکار می رود. این متوسط به نام برآوردگر خودگردان نامیده می شود. این برآوردگر و فاصله اطمینان مربوط به آن برای تعیین اینکه آماره های نمونه ای به عنوان برآوردی از پارامترهای جامعه تا چه اندازه پایداری دارند مورد استفاده قرار می گیرند. واضح است که اگر نمونه اولیه تصادفی اتخاذ شده از جامعه نماینده واقعی جامعه نباشد آنگاه آماره ی نمونه ای و برآوردگر خودگردان به دست آمده از بازنمونه گیری به نتایج گمراه کننده ای می انجامد. روش خودگردان سازی زمانی در پژوهش به کار می رود که امکان گرفتن داده های نمونه ای مجدد و یا اعتبار متقاطع با دو نیمه کردن داده ها امکان پذیر نباشد. در نرم افزارهای مختلف مانند Amos ،LISREL و EQS این امکان وجود دارد.
@analysisacademy
خودگردان سازی در مدل سازی معادلات ساختاری
روش خودگردان سازی با یک مجموعه داده از نمونه های تصادفی به عنوان جایگزینی برای یک جامعه برخورد می کند و برای تولید برآورد ها و خطاهای معیار خودگردان نمونه ای، به دفعات مشخصی نمونه گیری مجدد را انجام می دهد. متوسط این برآورد ها و خطاهای معیار خودگردان نمونه ای محاسبه شده و نتایج برای به دست آوردن فاصله اطمینان برآوردهای خودگردان بکار می رود. این متوسط به نام برآوردگر خودگردان نامیده می شود. این برآوردگر و فاصله اطمینان مربوط به آن برای تعیین اینکه آماره های نمونه ای به عنوان برآوردی از پارامترهای جامعه تا چه اندازه پایداری دارند مورد استفاده قرار می گیرند. واضح است که اگر نمونه اولیه تصادفی اتخاذ شده از جامعه نماینده واقعی جامعه نباشد آنگاه آماره ی نمونه ای و برآوردگر خودگردان به دست آمده از بازنمونه گیری به نتایج گمراه کننده ای می انجامد. روش خودگردان سازی زمانی در پژوهش به کار می رود که امکان گرفتن داده های نمونه ای مجدد و یا اعتبار متقاطع با دو نیمه کردن داده ها امکان پذیر نباشد. در نرم افزارهای مختلف مانند Amos ،LISREL و EQS این امکان وجود دارد.
http://analysisacademy.com/wp-content/uploads/2016/11/analysisacademy.jpg
@analysisacademy
www.analysisacademy.com
متغییرهای مزاحم در تحقیقات تجربی
در کلاس های آکادمی تحلیل آماری ایران بارها به این نکته اشاره شده که نباید متغییر مداخله گر یا مزاحم را با متغییر تعدیلگر اشتباه گرفت زیرا متغییر مزاحم یا مداخله گر نه مثل متغییر کنترل قابلیت ثابت نگه داشتن دارد و نه مثل متغییر تعدیلگر قابلیت اندازه گیری دارد بلکه مثل یک پارازیت بر تحقیق اثرگذار است حال در این مقاله به اثر این متغییر در تحقیقات تجربی می پردازیم:
1-انتخاب اختلافی(Differential Selection):در برخی طرحهای آزمایشی، محقق ممکن است ناخواسته افراد قوی تری را برای گروه آزمایشی انتخاب کند. این امر بر نتیجه آزمایش تاثیر می گذارد.
2-آفت آزمودنی(Experimental mortality):ممکن است گاهی اوقات در طول اجرای تحقیق برخی از آزمودنی ها به دلایل مختلف از ادامه مشارکت در تحقیق خوداری کنند که این امر اثر نامطلوب بر تحقیق خواهد داشت.
3-پیش آزمون(Testing pretes):گاهی اوقات پیش آزمون موجب می شود که آزمودنی ها تجارب خود را به پس آزمون انتقال دهند، در نتیجه این عامل می تواند نتیجه نهایی پژوهش را خدشه دار کند.
4-ابزار اندازه گیری:(Instrumentation)چنانچه ابزار به کار رفته در پژوهش از قابلیت اعتماد و اعتبار لازم برخوردار نباشد بر نتایج تحقیق اثر نامطلوب خواهد داشت.
5-تداخل اعمال آزمایشی/اثر هاتورن: اگر آزمودنی های گروه کنترل مطلع شوند که عملکردشان با گروه دیگر مقایسه می شود ممکن است که برتری خود را نشان دهند.
6-همزمانی(تاریخچه)/رخدادهای همزمان(History):چنانچه طرح تحقیق همزمان با یک فعالیت مشابه به اجرا درآید در این صورت می تواند نتیجه تحقیق خدشه دار شود.
7-بلوغ/رشد/پختگی (Maturation): آزمودنی ها در جریان تحقیق ممکن است از نظر جسمانی و روانی تغییر کنند. این امر می تواند بر نتیجه آزمایش اثر گذارد و آن را خدشه دار کند.
8-اثر متقابل-تعامل و انتخاب با سایر عوامل:در برخی از طرح های آزمایشی عامل انتخاب آزمودنی ها با برخی از عوامل مانند رشد تعامل داشته و در نتیجه تحقیق تاثیر می گذارد.
9-بازگشت های آماری-رگرسیون آماری: رجعت داده های دور از میانگین به طرف میانگین تاثیر این عامل بیشتر در زمانی مشاهده می شود که پیش آزمونمورد استفاده قرار گیرد.
10-تحلیل آماری:استفاده از روش های نامناسب آماری باعث نتیجه گیری غیر دقیق در طرح های آزمایشی می شود.
11-سوگیری محقق/ گزینش:در برخی از پژوهش ها، محقق و پژوهشگر ممکن است انتظارات خود از نتایج پژوهش را به آزمودنی تلقین کند.
@analysisacademy
www.analysisacademy.com
متغییرهای مزاحم در تحقیقات تجربی
در کلاس های آکادمی تحلیل آماری ایران بارها به این نکته اشاره شده که نباید متغییر مداخله گر یا مزاحم را با متغییر تعدیلگر اشتباه گرفت زیرا متغییر مزاحم یا مداخله گر نه مثل متغییر کنترل قابلیت ثابت نگه داشتن دارد و نه مثل متغییر تعدیلگر قابلیت اندازه گیری دارد بلکه مثل یک پارازیت بر تحقیق اثرگذار است حال در این مقاله به اثر این متغییر در تحقیقات تجربی می پردازیم:
1-انتخاب اختلافی(Differential Selection):در برخی طرحهای آزمایشی، محقق ممکن است ناخواسته افراد قوی تری را برای گروه آزمایشی انتخاب کند. این امر بر نتیجه آزمایش تاثیر می گذارد.
2-آفت آزمودنی(Experimental mortality):ممکن است گاهی اوقات در طول اجرای تحقیق برخی از آزمودنی ها به دلایل مختلف از ادامه مشارکت در تحقیق خوداری کنند که این امر اثر نامطلوب بر تحقیق خواهد داشت.
3-پیش آزمون(Testing pretes):گاهی اوقات پیش آزمون موجب می شود که آزمودنی ها تجارب خود را به پس آزمون انتقال دهند، در نتیجه این عامل می تواند نتیجه نهایی پژوهش را خدشه دار کند.
4-ابزار اندازه گیری:(Instrumentation)چنانچه ابزار به کار رفته در پژوهش از قابلیت اعتماد و اعتبار لازم برخوردار نباشد بر نتایج تحقیق اثر نامطلوب خواهد داشت.
5-تداخل اعمال آزمایشی/اثر هاتورن: اگر آزمودنی های گروه کنترل مطلع شوند که عملکردشان با گروه دیگر مقایسه می شود ممکن است که برتری خود را نشان دهند.
6-همزمانی(تاریخچه)/رخدادهای همزمان(History):چنانچه طرح تحقیق همزمان با یک فعالیت مشابه به اجرا درآید در این صورت می تواند نتیجه تحقیق خدشه دار شود.
7-بلوغ/رشد/پختگی (Maturation): آزمودنی ها در جریان تحقیق ممکن است از نظر جسمانی و روانی تغییر کنند. این امر می تواند بر نتیجه آزمایش اثر گذارد و آن را خدشه دار کند.
8-اثر متقابل-تعامل و انتخاب با سایر عوامل:در برخی از طرح های آزمایشی عامل انتخاب آزمودنی ها با برخی از عوامل مانند رشد تعامل داشته و در نتیجه تحقیق تاثیر می گذارد.
9-بازگشت های آماری-رگرسیون آماری: رجعت داده های دور از میانگین به طرف میانگین تاثیر این عامل بیشتر در زمانی مشاهده می شود که پیش آزمونمورد استفاده قرار گیرد.
10-تحلیل آماری:استفاده از روش های نامناسب آماری باعث نتیجه گیری غیر دقیق در طرح های آزمایشی می شود.
11-سوگیری محقق/ گزینش:در برخی از پژوهش ها، محقق و پژوهشگر ممکن است انتظارات خود از نتایج پژوهش را به آزمودنی تلقین کند.

@analysisacademy
Www.analysisacademy.com
اطلاعیه وزارتعلوم درباره گزارش سرقتهای علمی
وزارت علوم دو هفته پس از انتشار گزارشهایی در نشریات معتبر از سرقت علمی در ایران، اقداماتی که برای مقابله با این موضوع انجام شده است را منتشر کرد.
به گزارش خبرگزاری خبرآنلاین؛ به دنبال نشر گزارش مربوط به سرقت علمی (انتحال) از سوی مجله نیچر و به منظور رسیدگی به موضوع و برخورد با متخلفان در حوزه کارکردی وزارت علوم، تحقیقات و فناوری و همچنین برخورد با تخلفات علمی، به منظور جلوگیری از تکرار این جرائم، اقدامات زیر در این وزارتخانه از مدت ها قبل آغازشده و توجه به این موضوع با جدیت ادامه دارد:
1ـ مقرر شد يك كميته حقيقت ياب به مسئوليت معاونت محترم پژوهش و فناوری تشكيل شود و با پیگیری مجدانه در این زمینه، موضوع را به طور دقیق و مستند و کارشناسانه مورد رسیدگی قرار داده و نتیجه را اعلام كند.
2ـ مقرر شد به روسای دانشگاهها ابلاغ شود کمیتهای را جهت رسیدگی به این امور تشکیل داده و ضمن پیگیری موضوع، نتیجه رسما اعلام شود.
3ـ راهکارهایی برای جلوگیری از تکرار این نوع تخلف تعریف و از طریق کنترل مقالات علمی و پایان نامهها و با استفاده از نرم افزار همانند جو، ثبت پایاننامهها و... از هرگونه سواستفاده، جلوگیری و ممانعت به عمل آيد.
4ـ همچنين در قالب آئین نامه و دستورالعمل های مختلف، عنایت ویژه به کیفیت امور تحقیقاتی، مکانیسم و ارتقای اعضای هیئت علمی صورت گرفته است.
5ـ مرجعیت وزارت علوم، تحقیقات و فناوری در کارشناسی دقیق "اصالت" مقالات علمی در این امر مورد تاکید است.
6ـ آیین نامه و شیوه نامه های برخورد با تخلفات علمی استادان و دانشجویان به دانشگاهها و مراکز آموزش عالی ارسال شده است.
7ـ لازم به ذکر است که معاونت محترم حقوقی و امور مجلس وزارت متبوع، لایحهای را در مورد سرقت ادبی و تقلب علمی تهیه و تنظیم کرده و پس از طی تشریفات قانونی، مراتب را با قید فوریت به مجلس شورای اسلامی جهت بررسی و تصویب تقدیم کرده است.
Www.analysisacademy.com
اطلاعیه وزارتعلوم درباره گزارش سرقتهای علمی
وزارت علوم دو هفته پس از انتشار گزارشهایی در نشریات معتبر از سرقت علمی در ایران، اقداماتی که برای مقابله با این موضوع انجام شده است را منتشر کرد.
به گزارش خبرگزاری خبرآنلاین؛ به دنبال نشر گزارش مربوط به سرقت علمی (انتحال) از سوی مجله نیچر و به منظور رسیدگی به موضوع و برخورد با متخلفان در حوزه کارکردی وزارت علوم، تحقیقات و فناوری و همچنین برخورد با تخلفات علمی، به منظور جلوگیری از تکرار این جرائم، اقدامات زیر در این وزارتخانه از مدت ها قبل آغازشده و توجه به این موضوع با جدیت ادامه دارد:
1ـ مقرر شد يك كميته حقيقت ياب به مسئوليت معاونت محترم پژوهش و فناوری تشكيل شود و با پیگیری مجدانه در این زمینه، موضوع را به طور دقیق و مستند و کارشناسانه مورد رسیدگی قرار داده و نتیجه را اعلام كند.
2ـ مقرر شد به روسای دانشگاهها ابلاغ شود کمیتهای را جهت رسیدگی به این امور تشکیل داده و ضمن پیگیری موضوع، نتیجه رسما اعلام شود.
3ـ راهکارهایی برای جلوگیری از تکرار این نوع تخلف تعریف و از طریق کنترل مقالات علمی و پایان نامهها و با استفاده از نرم افزار همانند جو، ثبت پایاننامهها و... از هرگونه سواستفاده، جلوگیری و ممانعت به عمل آيد.
4ـ همچنين در قالب آئین نامه و دستورالعمل های مختلف، عنایت ویژه به کیفیت امور تحقیقاتی، مکانیسم و ارتقای اعضای هیئت علمی صورت گرفته است.
5ـ مرجعیت وزارت علوم، تحقیقات و فناوری در کارشناسی دقیق "اصالت" مقالات علمی در این امر مورد تاکید است.
6ـ آیین نامه و شیوه نامه های برخورد با تخلفات علمی استادان و دانشجویان به دانشگاهها و مراکز آموزش عالی ارسال شده است.
7ـ لازم به ذکر است که معاونت محترم حقوقی و امور مجلس وزارت متبوع، لایحهای را در مورد سرقت ادبی و تقلب علمی تهیه و تنظیم کرده و پس از طی تشریفات قانونی، مراتب را با قید فوریت به مجلس شورای اسلامی جهت بررسی و تصویب تقدیم کرده است.
http://analysisacademy.com/wp-content/uploads/2016/11/validity-and-reliability.jpg
@analysisacademy
روایی وابسته به ملاک(روایی عینی،تجربی، پیوسته)- روایی پیش بین:
منظور از روایی وابسته به معیار مقایسه نمرات آزمون یا یک یا چند معیار می باشد و بدین ترتیب آزمون یا مقیاسی معتبر است که نمرات آزمون یا مقیاس با معیارهای موردنظر همبستگی بیشتری دارد.هنگامی که به اعتبار ملاکی توجه می کنیم که درصدد شناسایی برخی از معیارهای قابل مشاهده از طریق یک آزمون یا مقیاس هستیم. در این نوع روایی هدف شناخت رابطه بین ابزار اندازه گیری با نتایج بدست آمده است. در روایی وابسته به معیار فرض بر این است که اگر وسیله اندازه گیری از اعتبار کافی برخوردار باشد باید نوعی رابطه تجربی بین نتایج بدست آمده از وسایل اندازه گیری و سایر مشخصات پدیده مورد مطالعه وجود داشته باشد. روایی وابسته به معیار دو نوع است اولین نوع آن روایی پیش بین است که در این مطلب به آن پرداخته و نوع دیگر آن روایی همزمان است که در مطلب بعدی به بررسی آن می پردازیم.
روایی پیش بین: عبارت است از بررسی رابطه نمرات و نتایج حاصل از مقیاس آزمون با عملکرد و رفتار افراد در زمان آینده. به عبارت دیگر در اعتبار پیش بین ضریب همبستگی بین نتایج یک وسیله اندازه گیری با وسیله اندازه گیری دیگری به عنوان معیار یا ملاک پذیرفته شده مقایسه می شود و هر چقدر که ضریب همبستگی بیشتر باشد اعتبار پیش بین نیز بالاتر خواهد بود. در این حالت این سوال وجود دارد که آیا ابزار اندازه گیری قادر است آنچه را که ادعا می کند پیش بینی کند. ضریب اعتبار پیش بین از طریق اجرای آزمون برای همه افراد موردنظر برای یک مدت زمان معین و گردآوری نمرات ملاک و محاسبه ضریب اعتبار به دست می آید. مثلا می توانیم نتایج آزمون های آزمایشی را با نتایج کنکور سراسری مقایسه کنیم هر چقدر که نتایج کنکورهای آزمایشی به نتایج کنکور اصلی که در زمان آینده برگزار می شود نزدیکتر باشد می توان گفت که این کنکورها دارای اعتبار پیش بین بیشتری هستند و در واقع قدرت پیش بینی آنها بالاتر است.
علاوه بر وقت گیر بودن و هزینه بالای تعیین اعتبار پیش بین ابزار اندازه گیری یکی از مشکلات اصلی دیگر ملاکی است که مورد تایید و توافق همگان باشد، است. به عنوان مثال تعیین ویژگی های مناسب یک مدیر خوب به عنوان ملاکی جهت انتصاب افراد در پست های سازمانی کار چندان ساده ای نیست. به عبارت دیگر تعیین ملاک موفقیت یک مدیر مستلزم پژوهش های وسیع و دقیق در حوزه مدیریت و اقتصاد می باشد که به رغم سالها پژوهش هنوز ملاک دقیق و معتبری برای آن تعیین نشده است.
همان گونه که در تعیین اعتبار پیش بین می توان از چندین ملاک استفاده کرد استفاده از چندین آزمون پیش بین نیز این نوع روایی را افزایش می دهد و بر قدرت پیش بینی می افزاید. مثلا افزودن چند عامل پیش بینی دیگر به نمرات آزمون ورودی دانشگاه ها می تواند قدرت پیش بینی آن آزمون را افزایش دهد. یعنی به عوض تکیه بر نمرات آزمون ورودی به عنوان یک عامل واجد پیش بینی می توان از نمرات دبیرستان و نمرات نوعی آزمون استعداد تحصیلی نیز بهره برد. ترکیب این سه نوع عامل به مراتب بیشتر از نمرات یک آزمون ورودی می تواند موفقیت آتی داوطلبان ورود به دانشگاه را پیش بینی کند و در نتیجه انتخاب بهتری از داوطلبان به عمل آورد.
@analysisacademy
روایی وابسته به ملاک(روایی عینی،تجربی، پیوسته)- روایی پیش بین:
منظور از روایی وابسته به معیار مقایسه نمرات آزمون یا یک یا چند معیار می باشد و بدین ترتیب آزمون یا مقیاسی معتبر است که نمرات آزمون یا مقیاس با معیارهای موردنظر همبستگی بیشتری دارد.هنگامی که به اعتبار ملاکی توجه می کنیم که درصدد شناسایی برخی از معیارهای قابل مشاهده از طریق یک آزمون یا مقیاس هستیم. در این نوع روایی هدف شناخت رابطه بین ابزار اندازه گیری با نتایج بدست آمده است. در روایی وابسته به معیار فرض بر این است که اگر وسیله اندازه گیری از اعتبار کافی برخوردار باشد باید نوعی رابطه تجربی بین نتایج بدست آمده از وسایل اندازه گیری و سایر مشخصات پدیده مورد مطالعه وجود داشته باشد. روایی وابسته به معیار دو نوع است اولین نوع آن روایی پیش بین است که در این مطلب به آن پرداخته و نوع دیگر آن روایی همزمان است که در مطلب بعدی به بررسی آن می پردازیم.
روایی پیش بین: عبارت است از بررسی رابطه نمرات و نتایج حاصل از مقیاس آزمون با عملکرد و رفتار افراد در زمان آینده. به عبارت دیگر در اعتبار پیش بین ضریب همبستگی بین نتایج یک وسیله اندازه گیری با وسیله اندازه گیری دیگری به عنوان معیار یا ملاک پذیرفته شده مقایسه می شود و هر چقدر که ضریب همبستگی بیشتر باشد اعتبار پیش بین نیز بالاتر خواهد بود. در این حالت این سوال وجود دارد که آیا ابزار اندازه گیری قادر است آنچه را که ادعا می کند پیش بینی کند. ضریب اعتبار پیش بین از طریق اجرای آزمون برای همه افراد موردنظر برای یک مدت زمان معین و گردآوری نمرات ملاک و محاسبه ضریب اعتبار به دست می آید. مثلا می توانیم نتایج آزمون های آزمایشی را با نتایج کنکور سراسری مقایسه کنیم هر چقدر که نتایج کنکورهای آزمایشی به نتایج کنکور اصلی که در زمان آینده برگزار می شود نزدیکتر باشد می توان گفت که این کنکورها دارای اعتبار پیش بین بیشتری هستند و در واقع قدرت پیش بینی آنها بالاتر است.
علاوه بر وقت گیر بودن و هزینه بالای تعیین اعتبار پیش بین ابزار اندازه گیری یکی از مشکلات اصلی دیگر ملاکی است که مورد تایید و توافق همگان باشد، است. به عنوان مثال تعیین ویژگی های مناسب یک مدیر خوب به عنوان ملاکی جهت انتصاب افراد در پست های سازمانی کار چندان ساده ای نیست. به عبارت دیگر تعیین ملاک موفقیت یک مدیر مستلزم پژوهش های وسیع و دقیق در حوزه مدیریت و اقتصاد می باشد که به رغم سالها پژوهش هنوز ملاک دقیق و معتبری برای آن تعیین نشده است.
همان گونه که در تعیین اعتبار پیش بین می توان از چندین ملاک استفاده کرد استفاده از چندین آزمون پیش بین نیز این نوع روایی را افزایش می دهد و بر قدرت پیش بینی می افزاید. مثلا افزودن چند عامل پیش بینی دیگر به نمرات آزمون ورودی دانشگاه ها می تواند قدرت پیش بینی آن آزمون را افزایش دهد. یعنی به عوض تکیه بر نمرات آزمون ورودی به عنوان یک عامل واجد پیش بینی می توان از نمرات دبیرستان و نمرات نوعی آزمون استعداد تحصیلی نیز بهره برد. ترکیب این سه نوع عامل به مراتب بیشتر از نمرات یک آزمون ورودی می تواند موفقیت آتی داوطلبان ورود به دانشگاه را پیش بینی کند و در نتیجه انتخاب بهتری از داوطلبان به عمل آورد.

http://analysisacademy.com/wp-content/uploads/2016/11/images23.jpg
@analysisacademy
روایی وابسته به ملاک(روایی عینی،تجربی، پیوسته)- روایی همزمان:
منظور از روایی وابسته به معیار مقایسه نمرات آزمون یا یک یا چند معیار می باشد و بدین ترتیب آزمون یا مقیاسی معتبر است که نمرات آزمون یا مقیاس با معیارهای موردنظر همبستگی بیشتری دارد.هنگامی که به اعتبار ملاکی توجه می کنیم که درصدد شناسایی برخی از معیارهای قابل مشاهده از طریق یک آزمون یا مقیاس هستیم. در این نوع روایی هدف شناخت رابطه بین ابزار اندازه گیری با نتایج بدست آمده است. در روایی وابسته به معیار فرض بر این است که اگر وسیله اندازه گیری از اعتبار کافی برخوردار باشد باید نوعی رابطه تجربی بین نتایج بدست آمده از وسایل اندازه گیری و سایر مشخصات پدیده مورد مطالعه وجود داشته باشد. روایی وابسته به معیار دو نوع است اولین نوع آن روایی پیش بین است که در مطلب قبل به آن پرداختیم و نوع دیگر آن روایی همزمان است که این بخش به بررسی آن می پردازیم:
روایی همزمان:
نوعی روایی وابسته به ملاک است که از همبستگی بین نمره های آزمون و ملاک در شرایطی که هر دو اندازه در یک زمان به دست آمده باشند استفاده می کند. به عبارت دیگر این نوع اعتبار حالتی از اعتبار پیش بین می باشد که در آن به جای تعیین رابطه بین دو آزمون پس از یک فاصله زمانی رابطه بین دو آزمون به طور همزمان تعیین می شود. برای مثال آزمون چندوجهی شخصیت مینه سوتا یک آزمون تقریبا بلند شخصیت است که تا 600 سوال دارد این آزمون یک سنجه روا برای ارزیابی شخصیت افراد می باشد. حال فرض کنید یک پژوهشگرآزمون جدیدی برای سنجش شخصیت تهیه کرده است که نسبت به آزمون فوق کوتاهتر می باشد.او می تواند در مواردی که نمرات افراد استثنایی است برای اطمینان از آزمون مینه سوتا استفاده نماید در این حالت آزمون کوتاه یک پیش بینی کننده و آزمون مینه سوتا به عنوان ملاک اعتبار همزمان می باشد.
در مواردی که نتایج هر دو آزمون شبیه به یکدیگر باشد، محقق می تواند آزمون کوتاه را جایگزین آزمون بلند نماید. بنابراین می توان گفت یکی از اهداف تعیین روایی همزمان بین دو آزمون جایگزینی یکی به جای دیگری می باشد. بدیهی است چنین جانشین سازی هنگامی مفید خواهد بود که بین نمرات هر دو آزمون رابطه بالایی وجود داشته باشد و دیگر این که استفاده از آزمون جدید نسبت به آزمون قدیمی دارای مزایای قابل توجهی باشد.
@analysisacademy
روایی وابسته به ملاک(روایی عینی،تجربی، پیوسته)- روایی همزمان:
منظور از روایی وابسته به معیار مقایسه نمرات آزمون یا یک یا چند معیار می باشد و بدین ترتیب آزمون یا مقیاسی معتبر است که نمرات آزمون یا مقیاس با معیارهای موردنظر همبستگی بیشتری دارد.هنگامی که به اعتبار ملاکی توجه می کنیم که درصدد شناسایی برخی از معیارهای قابل مشاهده از طریق یک آزمون یا مقیاس هستیم. در این نوع روایی هدف شناخت رابطه بین ابزار اندازه گیری با نتایج بدست آمده است. در روایی وابسته به معیار فرض بر این است که اگر وسیله اندازه گیری از اعتبار کافی برخوردار باشد باید نوعی رابطه تجربی بین نتایج بدست آمده از وسایل اندازه گیری و سایر مشخصات پدیده مورد مطالعه وجود داشته باشد. روایی وابسته به معیار دو نوع است اولین نوع آن روایی پیش بین است که در مطلب قبل به آن پرداختیم و نوع دیگر آن روایی همزمان است که این بخش به بررسی آن می پردازیم:
روایی همزمان:
نوعی روایی وابسته به ملاک است که از همبستگی بین نمره های آزمون و ملاک در شرایطی که هر دو اندازه در یک زمان به دست آمده باشند استفاده می کند. به عبارت دیگر این نوع اعتبار حالتی از اعتبار پیش بین می باشد که در آن به جای تعیین رابطه بین دو آزمون پس از یک فاصله زمانی رابطه بین دو آزمون به طور همزمان تعیین می شود. برای مثال آزمون چندوجهی شخصیت مینه سوتا یک آزمون تقریبا بلند شخصیت است که تا 600 سوال دارد این آزمون یک سنجه روا برای ارزیابی شخصیت افراد می باشد. حال فرض کنید یک پژوهشگرآزمون جدیدی برای سنجش شخصیت تهیه کرده است که نسبت به آزمون فوق کوتاهتر می باشد.او می تواند در مواردی که نمرات افراد استثنایی است برای اطمینان از آزمون مینه سوتا استفاده نماید در این حالت آزمون کوتاه یک پیش بینی کننده و آزمون مینه سوتا به عنوان ملاک اعتبار همزمان می باشد.
در مواردی که نتایج هر دو آزمون شبیه به یکدیگر باشد، محقق می تواند آزمون کوتاه را جایگزین آزمون بلند نماید. بنابراین می توان گفت یکی از اهداف تعیین روایی همزمان بین دو آزمون جایگزینی یکی به جای دیگری می باشد. بدیهی است چنین جانشین سازی هنگامی مفید خواهد بود که بین نمرات هر دو آزمون رابطه بالایی وجود داشته باشد و دیگر این که استفاده از آزمون جدید نسبت به آزمون قدیمی دارای مزایای قابل توجهی باشد.

http://analysisacademy.com/wp-content/uploads/2016/11/Hypothesis_Squaree.jpg
@analysisacademy
تفاوت فرضیه های آماری و پژوهشی
یک فرضیه آماری معمولا گزاره هایی است درباره یک یا چند توزیع جامعه( به ویژه درباره یک یا چند پارامتر) که به وسیله آن می توان کیفیت یا کمیت یک صفت را در جامعه پیش بینی کرد. این گونه فرضیه ها با آنکه معرف یک نوع پیشامد است همواره دو وجه مکمل دارد:
1-بیان کیفیت صفت مورد آزمایش در شرایط تصادفی(فرضیه نبودن تفاوت یا نبودن ارتباط)
2-بیان نتیجه آزمایش در شرایط غیرتصادفی(فرضیه تفاوت واقعی متاثر از عوامل مورد پژوهش)
اما فرضیه علمی حدسی است زیرکانه درباره نتیجه پژوهش. معمولا گزاره ای است درباره پدیده ها، روابط میان آنها. فرضیه آماری معمولا از طریق فرضیه علمی به وجود می آید، رشد می کند یا از مفاهیم ضمنی آن مایه می گیرد اما هرگز با آنها یکی نیست.
به طور کلی می توان گفت:
فرضیه آماری رابطه بین متغییرها را بر حسب پارامترهای جامعه بیان می کند.
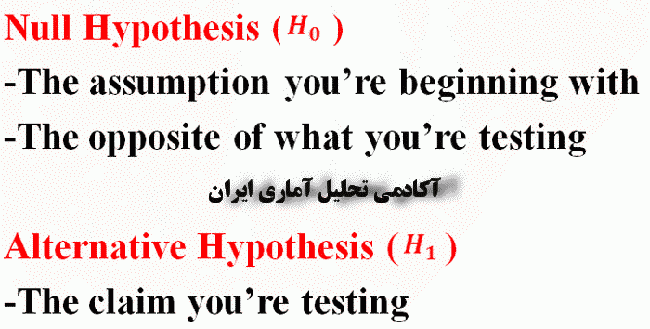
فرضیه تحقیق در فرض بدیل یا H1 منعکس می شود ولی فرض آماری یا همان فرض صفر در H0 بیان می شود. منطبق استباط آماری بدین صورت است که ما هیچگاه نمی توانیم درست بودن یک فرضیه آماری را اثبات کنیم بلکه فقط می توانیم درستی آن را بر حسب داده های در دسترس رد کرده یا تایید نماییم. در واقع محقق اگر فرض H0 خود را رد کند در واقع فرضیه تحقیق خود را پذیرفته است.
این مباحث در کلاسهای آکادمی تحلیل آماری ایران مورد نقد قرار می گیرد چرا که عمده دانشجویان از کلمه معنادار در فرضیات پروپوزال خود استفاده می کنند در حالی که این کلمه مربوط به فرضیه آماری است نه فرضیه پژوهشی اما چون به صورت غلطی رایج در کارهای پژوهشی ما وجود دارد متاسفانه بسیاری از اساتید نیز بر بودن آن در پروپوزالها تاکید می کنند.
@analysisacademy
تفاوت فرضیه های آماری و پژوهشی
یک فرضیه آماری معمولا گزاره هایی است درباره یک یا چند توزیع جامعه( به ویژه درباره یک یا چند پارامتر) که به وسیله آن می توان کیفیت یا کمیت یک صفت را در جامعه پیش بینی کرد. این گونه فرضیه ها با آنکه معرف یک نوع پیشامد است همواره دو وجه مکمل دارد:
1-بیان کیفیت صفت مورد آزمایش در شرایط تصادفی(فرضیه نبودن تفاوت یا نبودن ارتباط)
2-بیان نتیجه آزمایش در شرایط غیرتصادفی(فرضیه تفاوت واقعی متاثر از عوامل مورد پژوهش)
اما فرضیه علمی حدسی است زیرکانه درباره نتیجه پژوهش. معمولا گزاره ای است درباره پدیده ها، روابط میان آنها. فرضیه آماری معمولا از طریق فرضیه علمی به وجود می آید، رشد می کند یا از مفاهیم ضمنی آن مایه می گیرد اما هرگز با آنها یکی نیست.
به طور کلی می توان گفت:
فرضیه آماری رابطه بین متغییرها را بر حسب پارامترهای جامعه بیان می کند.
فرضیه تحقیق در فرض بدیل یا H1 منعکس می شود ولی فرض آماری یا همان فرض صفر در H0 بیان می شود. منطبق استباط آماری بدین صورت است که ما هیچگاه نمی توانیم درست بودن یک فرضیه آماری را اثبات کنیم بلکه فقط می توانیم درستی آن را بر حسب داده های در دسترس رد کرده یا تایید نماییم. در واقع محقق اگر فرض H0 خود را رد کند در واقع فرضیه تحقیق خود را پذیرفته است.
این مباحث در کلاسهای آکادمی تحلیل آماری ایران مورد نقد قرار می گیرد چرا که عمده دانشجویان از کلمه معنادار در فرضیات پروپوزال خود استفاده می کنند در حالی که این کلمه مربوط به فرضیه آماری است نه فرضیه پژوهشی اما چون به صورت غلطی رایج در کارهای پژوهشی ما وجود دارد متاسفانه بسیاری از اساتید نیز بر بودن آن در پروپوزالها تاکید می کنند.
http://analysisacademy.com/wp-content/uploads/2016/11/null12.gif
@analysisacademy
ویژگی های یک فرضیه خوب
الف)فرضیه باید قدرت تبیین حقایق را داشته باشد؛ یعنی به گونه ای ساخته شود که واقعیت مسئله یا متغیر یا روابط مورد مطالعه را منعکس کند و بتوان بر اساس آن اطلاعات را گردآوری کرده و مورد تجزیه و تحلیل قرار داد.
ب)فرضیه باید بتواند پاسخ مسئله تحقیق را بدهد؛ یعنی آنچنان با مسئله تحقیق یا سوالات فرعی آن مرتبط باشد که اطلاعات گردآوری شده پس از تجزیه و تحلیل، پاسخگوی حل مساله و قابل استفاده باشد.
ج)فرضیه باید قابلیت حذف حقایق نامرتبط با مسئله تحقیق را داشته باشد.
د)فرضیه باید شفاف، ساده و قابل فهم باشد.
ه)فرضیه باید قابلیت آزمون را داشته باشد؛ یعنی مفاهیم و متغییرهای مطرح شده در فرضیه قابل تبدیل به تعاریف عملیاتی و واجد معرف ها و شاخص هایی برای اندازه گیری، ارزیابی و سنجش باشند.
و)فرضیه نباید با حقایق و قوانین مسلم و اصول علمی تایید شده و پذیرفته شده مغایرت داشته باشد.
ز)فرضیه نباید از واژه ها و مفاهیم ارزشی استفاده کتد، بلکه باید ناظر بر واقعیت و حقیقتی باشد که محقق قصد کشف آن را دارد؛ مثلا محقق باید در تدوین فرضیه از عبارتی نظیر ایده آل است، بسیار خوب است، پرهیز کند.
ح)فرضیه باید به مطالعه و پژوهش جهت بدهد و راهنمای فعالیت های محقق باشد.
ط)فرضیه باید به صورت جمله خبری باشد تا از نحوه ارتباط متغییرها خبر بدهد.
ی)در یک فرضیه خوب اصطلاحات و واژه های اختصاصی به طور جداگانه تعریف می شوند.
ک)فرضیه ها با توجه به چهارچوب نظری تحقیق تدوی می شوند؛ بنابراین تعداد ابعاد و رابطه های موجود بین متغییرها در چارچوب نظری می تواند ملاک عمل برای تعداد فرضیه ها باشد.
ل)فرضیه ها باید مختص مطالعه موردی مسئله تحقیق باشند.
م)باید بین فرضیه ها و سوالهای ویژه یا فرعی تحقیق تناظر صوری و محتوایی وجود داشته باشد.
منظور از تناظر صوری این است که اولا به تعداد سوالهای فرعی، فرضیه تدوین شود و ثانیا هر فرضیه در مقابل سوال مربوط به آن قرار گیرد. منظور از تناسب و تناظر محتوایی این است که معنا و مفهوم هر فرضیه با معنا و مفهوم سوال مربوط به آن تناسب داشته باشد، به عبارت دیگر فرضیه و سوال به لحاظ محتوایی با هم ارتباط منطقی داشته باشد.
ن)بنابراین مفاهیم و متغییرها و روابط آنها در چارچوب فرضیه باید به گونه ای جفت و جور شده و سامان داده شده باشند که امکان پردازش ابزار سنجش و گردآوری اطلاعات را فراهم آورد.
س)چنانچه موضوع پژوهش فاقد سوالات فرعی یا ویژه باش و به عبارتی فقط دارای یک سوال (یعنی سوال اصلی) باشد، بنابراین موضوع پژوهش فقط دارای یک فرضیه انفرادی یا زوجی خواهد بود.
@analysisacademy
ویژگی های یک فرضیه خوب
الف)فرضیه باید قدرت تبیین حقایق را داشته باشد؛ یعنی به گونه ای ساخته شود که واقعیت مسئله یا متغیر یا روابط مورد مطالعه را منعکس کند و بتوان بر اساس آن اطلاعات را گردآوری کرده و مورد تجزیه و تحلیل قرار داد.
ب)فرضیه باید بتواند پاسخ مسئله تحقیق را بدهد؛ یعنی آنچنان با مسئله تحقیق یا سوالات فرعی آن مرتبط باشد که اطلاعات گردآوری شده پس از تجزیه و تحلیل، پاسخگوی حل مساله و قابل استفاده باشد.
ج)فرضیه باید قابلیت حذف حقایق نامرتبط با مسئله تحقیق را داشته باشد.
د)فرضیه باید شفاف، ساده و قابل فهم باشد.
ه)فرضیه باید قابلیت آزمون را داشته باشد؛ یعنی مفاهیم و متغییرهای مطرح شده در فرضیه قابل تبدیل به تعاریف عملیاتی و واجد معرف ها و شاخص هایی برای اندازه گیری، ارزیابی و سنجش باشند.
و)فرضیه نباید با حقایق و قوانین مسلم و اصول علمی تایید شده و پذیرفته شده مغایرت داشته باشد.
ز)فرضیه نباید از واژه ها و مفاهیم ارزشی استفاده کتد، بلکه باید ناظر بر واقعیت و حقیقتی باشد که محقق قصد کشف آن را دارد؛ مثلا محقق باید در تدوین فرضیه از عبارتی نظیر ایده آل است، بسیار خوب است، پرهیز کند.
ح)فرضیه باید به مطالعه و پژوهش جهت بدهد و راهنمای فعالیت های محقق باشد.
ط)فرضیه باید به صورت جمله خبری باشد تا از نحوه ارتباط متغییرها خبر بدهد.
ی)در یک فرضیه خوب اصطلاحات و واژه های اختصاصی به طور جداگانه تعریف می شوند.
ک)فرضیه ها با توجه به چهارچوب نظری تحقیق تدوی می شوند؛ بنابراین تعداد ابعاد و رابطه های موجود بین متغییرها در چارچوب نظری می تواند ملاک عمل برای تعداد فرضیه ها باشد.
ل)فرضیه ها باید مختص مطالعه موردی مسئله تحقیق باشند.
م)باید بین فرضیه ها و سوالهای ویژه یا فرعی تحقیق تناظر صوری و محتوایی وجود داشته باشد.
منظور از تناظر صوری این است که اولا به تعداد سوالهای فرعی، فرضیه تدوین شود و ثانیا هر فرضیه در مقابل سوال مربوط به آن قرار گیرد. منظور از تناسب و تناظر محتوایی این است که معنا و مفهوم هر فرضیه با معنا و مفهوم سوال مربوط به آن تناسب داشته باشد، به عبارت دیگر فرضیه و سوال به لحاظ محتوایی با هم ارتباط منطقی داشته باشد.
ن)بنابراین مفاهیم و متغییرها و روابط آنها در چارچوب فرضیه باید به گونه ای جفت و جور شده و سامان داده شده باشند که امکان پردازش ابزار سنجش و گردآوری اطلاعات را فراهم آورد.
س)چنانچه موضوع پژوهش فاقد سوالات فرعی یا ویژه باش و به عبارتی فقط دارای یک سوال (یعنی سوال اصلی) باشد، بنابراین موضوع پژوهش فقط دارای یک فرضیه انفرادی یا زوجی خواهد بود.
http://analysisacademy.com/wp-content/uploads/2016/11/academy1.jpg
@analysisacademy
طرح های تحقیق آمیخته بهم تنیده
طرح های تحقیق آمیخته به سه بخش زیر دسته بندی می شوند:
الف-طرح های تحقیق آمیخته بهم تنیده
ب-طرح های تحقیق آمیخته تشریحی
ج-طرح های تحقیق آمیخته اکتشافی
در این بخش به بررسی طرح های تحقیق آمیخته بهم تنیده می پردازیم:
طرح تحقیق های آمیخته بهم تنیده
در این نوع طرحها پژوهشگر به هر دو مجموعه داده های کمی و کیفی وزن(اهمیت) مساوی می دهد. برای مثال برای پی بردن به کیفیت محیط دوره و عملکرد یادگیری در دوره های آموزشی رشد حرفه ای کارکنان، پژوهشگری که از طرح بهم تنیده استفاده می کند، سه مولفه را مورد توجه قرار می دهد.
الف. در گردآوری نمره های آزمون عملکردی در دوره آموزشی و اندازه گیری سایر متغییرها(از جمله قبلی و...) و نیز گردآوری داده های کیفی از طریق مصاحبه و مشاهده به یک نسبت اهمیت می دهد.
ب.داده های کمی و کیفی مورد نظر را به طور همزمان گردآوری می نماید.
ج.در تحلیل داده ها به مقایسه دو دسته داده های کمی و کیفی می پردازد تا همگونی یافته ها را نمایان کند و تطابق نتیجه گیری از این دو دسته را آشکار سازد.
@analysisacademy
طرح های تحقیق آمیخته بهم تنیده
طرح های تحقیق آمیخته به سه بخش زیر دسته بندی می شوند:
الف-طرح های تحقیق آمیخته بهم تنیده
ب-طرح های تحقیق آمیخته تشریحی
ج-طرح های تحقیق آمیخته اکتشافی
در این بخش به بررسی طرح های تحقیق آمیخته بهم تنیده می پردازیم:
طرح تحقیق های آمیخته بهم تنیده
در این نوع طرحها پژوهشگر به هر دو مجموعه داده های کمی و کیفی وزن(اهمیت) مساوی می دهد. برای مثال برای پی بردن به کیفیت محیط دوره و عملکرد یادگیری در دوره های آموزشی رشد حرفه ای کارکنان، پژوهشگری که از طرح بهم تنیده استفاده می کند، سه مولفه را مورد توجه قرار می دهد.
الف. در گردآوری نمره های آزمون عملکردی در دوره آموزشی و اندازه گیری سایر متغییرها(از جمله قبلی و...) و نیز گردآوری داده های کیفی از طریق مصاحبه و مشاهده به یک نسبت اهمیت می دهد.
ب.داده های کمی و کیفی مورد نظر را به طور همزمان گردآوری می نماید.
ج.در تحلیل داده ها به مقایسه دو دسته داده های کمی و کیفی می پردازد تا همگونی یافته ها را نمایان کند و تطابق نتیجه گیری از این دو دسته را آشکار سازد.

http://analysisacademy.com/wp-content/uploads/2016/11/academy2.png
@analysisacademy
طرح های تحقیق آمیخته به سه بخش زیر دسته بندی می شوند:
الف-طرح های تحقیق آمیخته بهم تنیده
ب-طرح های تحقیق آمیخته تشریحی
ج-طرح های تحقیق آمیخته اکتشافی
در این بخش به بررسی طرح های تحقیق آمیخته تشریحی می پردازیم:
طرح های تحقیق آمیخته تشریحی
در این نوع طح ها، پژوهشگر به منظور تشریح یک پدیده، وزن اصلی را به داده های کمی اختصاصی می دهد، اما از داده های کیفی برای تشریح ابعاد مختلف پدیده استفاده می کند. همچنین فرآیند گردآوری داده ها را به دو مرحله به انجام می رساند. در مرحله اول داده های کمی گردآوری می شود، سپس داده های کیفی گردآوری می گردد. به عبارت دیگر از داده های کیفی برای توضیح بیشتر و آشکار کردن برخی جنبه های ابهام برانگیز استفاده می شود. به رغم آشکاری مراحل انجام تحقیق دشواری طرح تشریحی در آن است که پژوهشگر درباره این که کدام جنبه از پدیده مورد مطالعه را باید با گردآوری داده های کیفی بررسی کند لازم است قبلا تصمیم گیری نماید. برای مثال به منظور بررسی فرآیند اشتغال دانش آموختگان رشته های مدیریت در شهر تهران می توان طرح تحقیق آمیخته تشریحی را به کار برد. در انجام این پژوهش یکی از متغییرهای اصلی مورد مطالعه می تواند مدت زمان بیکاری پس از دانش آموختگی باشد. بنابراین با گردآوری داده های کمی درباره این متغیر دامنه و مدت زمان بیکاری مشخص می شود. به ویژه با تعیین فراوانی و نسبت دانش آموختگان در طیف بیکاری، می توان توزیع فراوانی صفت متغییر را آشکار کرد. پس از این مرحله پژوهشگر می تواند با شناسایی دانش آموختگانی که کمترین و بیشترین مدت زمان بیکاری را داشته اند. نسبت به گردآوری داده های کیفی از طریق مصاحبه و مشاهده اقدام کند و اطلاعات تفضیلی درباره فرآیند اشتغال/بیکاری آنان را به دست آورد و مورد تحلیل قرار دهد.
@analysisacademy
طرح های تحقیق آمیخته به سه بخش زیر دسته بندی می شوند:
الف-طرح های تحقیق آمیخته بهم تنیده
ب-طرح های تحقیق آمیخته تشریحی
ج-طرح های تحقیق آمیخته اکتشافی
در این بخش به بررسی طرح های تحقیق آمیخته تشریحی می پردازیم:
طرح های تحقیق آمیخته تشریحی
در این نوع طح ها، پژوهشگر به منظور تشریح یک پدیده، وزن اصلی را به داده های کمی اختصاصی می دهد، اما از داده های کیفی برای تشریح ابعاد مختلف پدیده استفاده می کند. همچنین فرآیند گردآوری داده ها را به دو مرحله به انجام می رساند. در مرحله اول داده های کمی گردآوری می شود، سپس داده های کیفی گردآوری می گردد. به عبارت دیگر از داده های کیفی برای توضیح بیشتر و آشکار کردن برخی جنبه های ابهام برانگیز استفاده می شود. به رغم آشکاری مراحل انجام تحقیق دشواری طرح تشریحی در آن است که پژوهشگر درباره این که کدام جنبه از پدیده مورد مطالعه را باید با گردآوری داده های کیفی بررسی کند لازم است قبلا تصمیم گیری نماید. برای مثال به منظور بررسی فرآیند اشتغال دانش آموختگان رشته های مدیریت در شهر تهران می توان طرح تحقیق آمیخته تشریحی را به کار برد. در انجام این پژوهش یکی از متغییرهای اصلی مورد مطالعه می تواند مدت زمان بیکاری پس از دانش آموختگی باشد. بنابراین با گردآوری داده های کمی درباره این متغیر دامنه و مدت زمان بیکاری مشخص می شود. به ویژه با تعیین فراوانی و نسبت دانش آموختگان در طیف بیکاری، می توان توزیع فراوانی صفت متغییر را آشکار کرد. پس از این مرحله پژوهشگر می تواند با شناسایی دانش آموختگانی که کمترین و بیشترین مدت زمان بیکاری را داشته اند. نسبت به گردآوری داده های کیفی از طریق مصاحبه و مشاهده اقدام کند و اطلاعات تفضیلی درباره فرآیند اشتغال/بیکاری آنان را به دست آورد و مورد تحلیل قرار دهد.

www.analysisacademy.com
@analysisacademy
دوستان عزیز توصیه میکنم این برنامه را ببینید:چالشهای پایان نامه نویسی در ایران
http://www.telewebion.com/#!/episode/1532769/
@analysisacademy
دوستان عزیز توصیه میکنم این برنامه را ببینید:چالشهای پایان نامه نویسی در ایران
http://www.telewebion.com/#!/episode/1532769/