
Forwarded from Стой под стрелой (Nikita Prokopov)
Татарин Фронтенд пожаловался в твиттере:
«Бля, опять регулярку писать. Я как не умел, так и не умею. Но писать придётся.»
(Кстати, совет молодым: не делайте текущее увлечение частью ника. Заебет вас фронтенд через пару лет, захотите стать вебкам-моделью, а в нике «Фронтенд». И че?)
И вот что ему написали:
«А может не надо?»
«А нет готовых либ под задачу?»
«Может найдёшь готовую?»
«У тебя теперь две проблемы»
«Регулярку не пишут, регулярку гуглят»
«Отдай аналитику своему, тебе-то нафига это»
Что общего у этих ответов? Это отмазки, чтобы НЕ делать работу. Никто из них не поинтересовался даже, что за задача, для кого. Нет, первый инстинкт: а может не работать?
Мне писали: лень лучшее качество программиста. Но должен же быть предел? Хоть что-то же надо уметь делать? Кому нужен программист, который только профессионально отмазывается от работы?
Мне писали: зачем плодить код, если есть готовые, хорошо оттестированные библиотеки. Ну вот есть на npm библиотека mask-string. Заменяет слова в строке на звездочки.
Библиотеки — не волшебная мазь, сделанная в башне из слоновой кости. Их пишут такие же программисты, как и вы. Может быть, она сделана хорошо и качественно. Может быть вовсе нет. Чтобы понять, надо как раз разбираться. Сам факт библиотеки не гарантирует вообще ничего.
Мне писали: у регулярок плохая репутация. Но это не повод не использовать их вообще нигде. Не используйте там, где они не подходят. Используйте там, где подходят. Я же не XML-парсер на них предлагаю писать. Задачу узнайте сначала!
Мне писали: регулярки вызывают критические простои сервисов. А что не вызывает? Что угодно вызывает: языки вызывают, библиотеки вызывают, процессы вызывают, сети вызывают, конфиги вызывают, логи вызывают. И ничего, штопают и работают дальше.
Так что, зачем напрягаться? Недавно узкий круг лиц поднялся в айти с лозунгом «как меньше работать и больше получать». Понятно, почему эта позиция нравится начинающим. Более того, на текущем рынке действительно можно до определенного предела эксплуатировать работодателя.
Но глобально это путь в никуда — и для вас, и для рынка. Просидите вы десять лет в своем уютном банке, плюя в потолок и собирая зарплату. Рынок изменится, или вы больше денег захотите, или релокейт, а вы уже никому не нужны, потому что привыкли не работать.
Поэтому я агитирую за противоположную точку зрения. Разбираться в чем-то — не зашкварно. Уметь что-то лучше, чем не уметь. Расширять кругозор, узнавать новое — чистое удовольствие. Если вы устроились программистом, то программировать — ваша работа. Не все, что вам нужно, будет написано в библиотеках. Библиотеки тоже кому-то надо писать. Чем больше вы умеете, тем ценнее как специалист.
Да, трудно конкурировать с «зачем что-то делать, если можно ничего не делать». Но лично для меня это не работает: во-первых мне скучно, во-вторых стыдно, в-третьих мне спокойнее, когда на меня есть спрос, в-четвертых я люблю хороший код, часто его приходится писать самому, ну и в-пятых есть о чем поговорить с девочками: в конце концов, вы читаете это в моем канале, а не я в вашем.
P.S. Задача из твита: определить соответствие одному из 4-х шаблонов. Шаблоны a + b * c, a * b - c, a / b * c, приходит например 100 + 200 * 300. Надо определить шаблон.
Если ваш первый инстинкт — «не используй регулярки», даже до того, как узнали задачу — надеюсь, вам теперь стыдно. ВСЕГДА узнавайте задачу.
Если вам все еще не стыдно, вот мое решение:
Но пост в первую очередь все-таки не про регулярки. Пост про рабочую этику. И про то, что инструменты надо выбирать соразмерно задаче. Не забывайте об этом.
«Бля, опять регулярку писать. Я как не умел, так и не умею. Но писать придётся.»
(Кстати, совет молодым: не делайте текущее увлечение частью ника. Заебет вас фронтенд через пару лет, захотите стать вебкам-моделью, а в нике «Фронтенд». И че?)
И вот что ему написали:
«А может не надо?»
«А нет готовых либ под задачу?»
«Может найдёшь готовую?»
«У тебя теперь две проблемы»
«Регулярку не пишут, регулярку гуглят»
«Отдай аналитику своему, тебе-то нафига это»
Что общего у этих ответов? Это отмазки, чтобы НЕ делать работу. Никто из них не поинтересовался даже, что за задача, для кого. Нет, первый инстинкт: а может не работать?
Мне писали: лень лучшее качество программиста. Но должен же быть предел? Хоть что-то же надо уметь делать? Кому нужен программист, который только профессионально отмазывается от работы?
Мне писали: зачем плодить код, если есть готовые, хорошо оттестированные библиотеки. Ну вот есть на npm библиотека mask-string. Заменяет слова в строке на звездочки.
mask("arse", "Parser") => "P****r". Что там внутри? Конечно, регулярка. Более того, mask(".", "...") виснет нахрен, потому что абстракции протекли: хотел заменить подстроку, а в итоге пришлось разбираться с регулярками все равно.Библиотеки — не волшебная мазь, сделанная в башне из слоновой кости. Их пишут такие же программисты, как и вы. Может быть, она сделана хорошо и качественно. Может быть вовсе нет. Чтобы понять, надо как раз разбираться. Сам факт библиотеки не гарантирует вообще ничего.
Мне писали: у регулярок плохая репутация. Но это не повод не использовать их вообще нигде. Не используйте там, где они не подходят. Используйте там, где подходят. Я же не XML-парсер на них предлагаю писать. Задачу узнайте сначала!
Мне писали: регулярки вызывают критические простои сервисов. А что не вызывает? Что угодно вызывает: языки вызывают, библиотеки вызывают, процессы вызывают, сети вызывают, конфиги вызывают, логи вызывают. И ничего, штопают и работают дальше.
Так что, зачем напрягаться? Недавно узкий круг лиц поднялся в айти с лозунгом «как меньше работать и больше получать». Понятно, почему эта позиция нравится начинающим. Более того, на текущем рынке действительно можно до определенного предела эксплуатировать работодателя.
Но глобально это путь в никуда — и для вас, и для рынка. Просидите вы десять лет в своем уютном банке, плюя в потолок и собирая зарплату. Рынок изменится, или вы больше денег захотите, или релокейт, а вы уже никому не нужны, потому что привыкли не работать.
Поэтому я агитирую за противоположную точку зрения. Разбираться в чем-то — не зашкварно. Уметь что-то лучше, чем не уметь. Расширять кругозор, узнавать новое — чистое удовольствие. Если вы устроились программистом, то программировать — ваша работа. Не все, что вам нужно, будет написано в библиотеках. Библиотеки тоже кому-то надо писать. Чем больше вы умеете, тем ценнее как специалист.
Да, трудно конкурировать с «зачем что-то делать, если можно ничего не делать». Но лично для меня это не работает: во-первых мне скучно, во-вторых стыдно, в-третьих мне спокойнее, когда на меня есть спрос, в-четвертых я люблю хороший код, часто его приходится писать самому, ну и в-пятых есть о чем поговорить с девочками: в конце концов, вы читаете это в моем канале, а не я в вашем.
P.S. Задача из твита: определить соответствие одному из 4-х шаблонов. Шаблоны a + b * c, a * b - c, a / b * c, приходит например 100 + 200 * 300. Надо определить шаблон.
Если ваш первый инстинкт — «не используй регулярки», даже до того, как узнали задачу — надеюсь, вам теперь стыдно. ВСЕГДА узнавайте задачу.
Если вам все еще не стыдно, вот мое решение:
(\d+)\s*([+\-*/])\s*(\d+)\s*([+\-*/])\s*(\d+). Покажите мне, как это решить понятнее без регулярок, и я, может быть, поменяю свое мнение. Мало ли?Но пост в первую очередь все-таки не про регулярки. Пост про рабочую этику. И про то, что инструменты надо выбирать соразмерно задаче. Не забывайте об этом.
Forwarded from HackGit
open-source-web-scanners
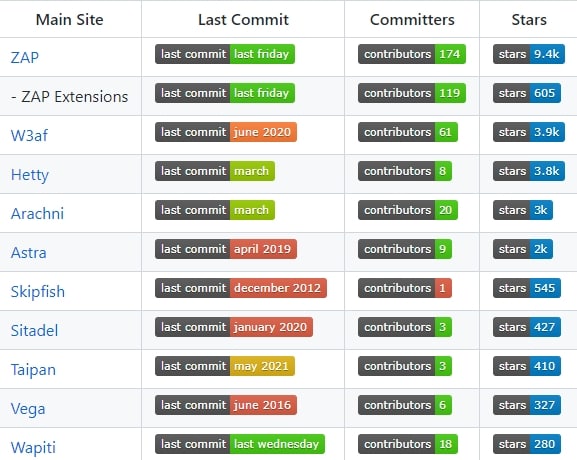
A list of open source web security scanners on GitHub and GitLab (just added), ordered by Stars. It does not provide in-depth analysis - for more analysis or a wider range of tools, see the links below.
https://github.com/psiinon/open-source-web-scanners
A list of open source web security scanners on GitHub and GitLab (just added), ordered by Stars. It does not provide in-depth analysis - for more analysis or a wider range of tools, see the links below.
https://github.com/psiinon/open-source-web-scanners
Forwarded from HackGit
pwnat
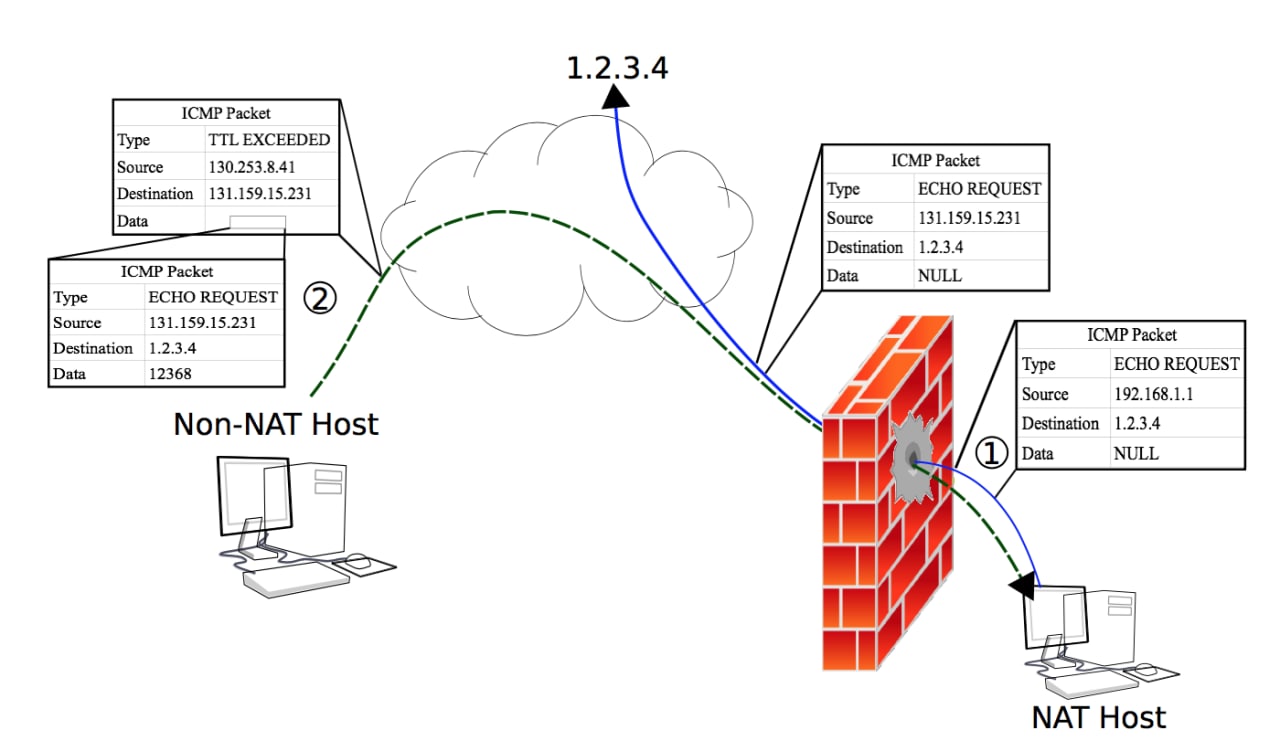
Tool and technique to punch holes through firewalls/NATs where both clients and server can be behind separate NATs without any 3rd party involvement.
Pwnat uses a newly developed technique, exploiting a property of NAT translation tables, with no 3rd party, port forwarding, DMZ, router administrative requirements, STUN/TURN/UPnP/ICE
https://github.com/samyk/pwnat
Site:
https://samy.pl/pwnat/
Oh shit, multi-line cursor in terminal!!
P.s. mac only now...
P.s. mac only now...
Forwarded from Devops Talks (Alex Green)
The terminal for the 21st century - https://www.warp.dev/
Warp
Warp — The Open Platform for Automating Development
Infrastructure to build, measure, and interact with agents across your SDLC — so you ship more and spend less.
Forwarded from GitHub Community
Stacer – Опенсорсная утилита для оптимизации и мониторинга Linux-систем
GitHub | #Cpp #Linux #Monitoring #Interesting
GitHub | #Cpp #Linux #Monitoring #Interesting

Forwarded from быдло.jazz
В связи с небывалым ростом интереса к VPN, в рубрике "мнение большого дяди" комментарий нашего специалиста по сетям - @Defau17.
Что может слить ваш VPN- провайдер:
- время отключений/подключений
- объем трафика в обе стороны
- каким способом оплачивали и данные по оплате (карты, криптокошельки и так далее).
- IP адрес с которого происходит подключение.
- как следствие, ваше местоположение
- IP адреса на которые происходят подключения (все веб ресурсы довольно точно можно будет идентифицировать)
- DNS запросы.
- все данные, которые можно получить через веб-страницу о системе, браузере, ОС, времени, шрифтах и тд и тп - если пользуетесь ЛК VPN оператора (для оплаты, регистрации и так далее) через браузер.
- аналогично предыдущему пункту, если это мобильное приложение, но данных еще больше можно получить. Вплоть до сбора различных статистик самим приложением: датчики, файлы и все прочее, что разрешит сам Android (зависит от версии и ROM's)
- все содержимое не шифрованного трафика (на практике такое никто не делает - хранить то где? - но в случае "запроса" - могут): http, кривые мобильные приложения, все что в структуре 'data' ip пакета "текстовое" в открытом виде, короче
- все не текстовое и не шифрованное то же
- используете ли вы TOR
- какие еще используются "протоколы"
В принципе, этого уже достаточно для идентификации личности, составления fingerprint, и еще каких-либо изобличений.
👍2
Forwarded from The Bug Bounty Hunter
Deliberately vulnerable CI/CD environment. Hack CI/CD pipelines, catch the flags. 🚩 https://github.com/cider-security-research/cicd-goat
GitHub
GitHub - cider-security-research/cicd-goat: A deliberately vulnerable CI/CD environment. Learn CI/CD security through multiple…
A deliberately vulnerable CI/CD environment. Learn CI/CD security through multiple challenges. - cider-security-research/cicd-goat
Еще немножечко из рубрики VPN и массонских заговоров 😏
А я говорил, что ничего лучше selfhosted решения быть не может))
А я говорил, что ничего лучше selfhosted решения быть не может))
Forwarded from ANTICHAT Channel
Малварь_на_просвет_Используем_Python_для_динамического_анализа_вредоносного.pdf
2.8 MB
Малварь на просвет. Используем Python для динамического анализа вредоносного кода — «Хакер»
Forwarded from HackGit
MultiJuicer
Run Capture the Flags and Security Training with #OWASP Juice Shop.
MultiJuicer gives you the ability to run separate Juice Shop instances for every participant on a central #Kubernetes cluster, to run events without the need for local Juice Shop instances.
What does it do?
▫️ Dynamically create new Juice Shop instances when needed
▫️ Runs on a single domain, comes with a LoadBalancer sending the traffic to the participants' Juice Shop instance
▫️ Backup and auto-apply challenge to progress in case of Juice Shop container restarts
▫️ Cleanup old & unused instances automatically
https://github.com/iteratec/multi-juicer

Forwarded from Zer0Day Lab
Please open Telegram to view this post
VIEW IN TELEGRAM
Tnx for nice example about prometheus and grafana in docker, @AveCaesar17