#سر_به_سر
گراف پایین را ببینید.
آن چیزی که برای خود من بیشتر از هر چیزی جلب توجه میکند، آن ستون (Bar) بلند، مربوط به درصد سود صفرها است. به معنای اینکه اغلب افراد، به محض اینکه سر به سر شدهاند، فروختهاند.
این مطلب از یکی دو سال پیش، حداقل برای خود من اثبات شده بود که افراد معامله کننده در بورس تهران، عمدتاً سر به سر فروش هستند و ترس از دست دادن سرمایه، سبب میشود، ذهن آنها به محض رسیدن به نقطه سربه سر، مرتب دستور زدن بر روی دکمه فروش را صادر کند.
یعنی به محض اینکه رنگ درصد سود پرتفوی آنها از قرمز به سبز تبدیل شد، به سرعت میفروشند.
یک نکته دیگر گراف این است که افراد جدیدی وارد بازار سرمایه نشدهاند (که معمولاً جرات ریسک بالاتری نیز دارند و به محض سر به سر شدن، فروشنده نیستند) و آنهایی که امروز در بازار مشغول معامله هستند، عمدتاً از مار گزیدگان سال 99 به بعد هستند که از ریسمان سیاه و سفید میترسند و ترس ضرر کردن، ویژگی غالب آنها است.
البته موضوع حرف من در این متن، چرایی وجود ترس و فروش در سر به سر ها نیست. این یک مطلب پذیرفته شده است و فعلاً تا مدتها برای آن کاری نمیتوان کرد.
آنچه من میخواهم به آن اشاره کنم، مطلب دیگری است.
بیایید با یک مثال در همان گراف پایین شروع کنم. فرض کنید فردی بر روی قیمت 2000 ریال خودرو میخرد. قیمت سر به سر او در این حالت 2025 ریال است. بر مبنای گراف، بیشتر افراد به محض رسیدن قیمت خودرو به اعدادی مانند 2026 تا 2030، سهام خود را میفروشند.
در واقع ذهن این افراد (که بیشترین فراوانی را هم در بین همه معاملهگران دارند) با رسیدن قیمت به این اعداد، مرتب دستور فروش به آنها میدهد.
حال چه کنیم؟
عدد سر به سر را (حتی به صورت غیر واقعی) برای آنها بالا ببرید. یعنی اگر عدد 2025 سر به سر آنها است و با گذشتن قیمت خودرو از این عدد، رنگ درصد سود آنها سبز میشود، عدد سر به سر را به عدد مثلاً 2045 افزایش دهید.
یعنی این افراد زمانی فروشنده باشند و ذهن آنها دستور فروش بدهد که قیمت عدد 2045 را رد کرده باشد. این کار باعث میشود، بیشتر افراد (همان سر به سر فروشها) دیرتر و در قیمتهای بالاتری بفروشند.
اساس این حرف این است که کارمزدها نه فقط کاهش، بلکه افزایش نیز پیدا کند. به عبارتی به جای اینکه فاصله اطمینان Confidence Interval ذهن برای صدور فرمان فروش نازکتر شود، آن را پهنتر Wide نیز کنید.
واضح است که این مطلب، مربوط به حال و هوای این روزهای بازار سرمایه تهران است که ترس، مهمترین ویژگی غالب بر آن است و بیشتر افراد سر به سر فروش هستند. در آینده با بهبود اوضاع میتوان به کاهش کارمزدها هم فکر کرد.
نکته پایانی اینکه، افزایش کارمزدها حتی میتواند به صورت غیرواقعی و توسط اپلیکیشهای کارگزاری اعمال شود. مثل همان ساعت روی دیوار خانهها که ما به صورت غیرواقعی حتی چند دقیقه آن را جلو میکشیم، با این ذهنیت که دیر به جایی نرویم و یا زودتر به کارهایمان برسیم.
https://graphpad.ir/wp-content/uploads/2022/08/Bar-Histogram-of-Percent-Summary-Report.png
گراف پایین را ببینید.
آن چیزی که برای خود من بیشتر از هر چیزی جلب توجه میکند، آن ستون (Bar) بلند، مربوط به درصد سود صفرها است. به معنای اینکه اغلب افراد، به محض اینکه سر به سر شدهاند، فروختهاند.
این مطلب از یکی دو سال پیش، حداقل برای خود من اثبات شده بود که افراد معامله کننده در بورس تهران، عمدتاً سر به سر فروش هستند و ترس از دست دادن سرمایه، سبب میشود، ذهن آنها به محض رسیدن به نقطه سربه سر، مرتب دستور زدن بر روی دکمه فروش را صادر کند.
یعنی به محض اینکه رنگ درصد سود پرتفوی آنها از قرمز به سبز تبدیل شد، به سرعت میفروشند.
یک نکته دیگر گراف این است که افراد جدیدی وارد بازار سرمایه نشدهاند (که معمولاً جرات ریسک بالاتری نیز دارند و به محض سر به سر شدن، فروشنده نیستند) و آنهایی که امروز در بازار مشغول معامله هستند، عمدتاً از مار گزیدگان سال 99 به بعد هستند که از ریسمان سیاه و سفید میترسند و ترس ضرر کردن، ویژگی غالب آنها است.
البته موضوع حرف من در این متن، چرایی وجود ترس و فروش در سر به سر ها نیست. این یک مطلب پذیرفته شده است و فعلاً تا مدتها برای آن کاری نمیتوان کرد.
آنچه من میخواهم به آن اشاره کنم، مطلب دیگری است.
بیایید با یک مثال در همان گراف پایین شروع کنم. فرض کنید فردی بر روی قیمت 2000 ریال خودرو میخرد. قیمت سر به سر او در این حالت 2025 ریال است. بر مبنای گراف، بیشتر افراد به محض رسیدن قیمت خودرو به اعدادی مانند 2026 تا 2030، سهام خود را میفروشند.
در واقع ذهن این افراد (که بیشترین فراوانی را هم در بین همه معاملهگران دارند) با رسیدن قیمت به این اعداد، مرتب دستور فروش به آنها میدهد.
حال چه کنیم؟
عدد سر به سر را (حتی به صورت غیر واقعی) برای آنها بالا ببرید. یعنی اگر عدد 2025 سر به سر آنها است و با گذشتن قیمت خودرو از این عدد، رنگ درصد سود آنها سبز میشود، عدد سر به سر را به عدد مثلاً 2045 افزایش دهید.
یعنی این افراد زمانی فروشنده باشند و ذهن آنها دستور فروش بدهد که قیمت عدد 2045 را رد کرده باشد. این کار باعث میشود، بیشتر افراد (همان سر به سر فروشها) دیرتر و در قیمتهای بالاتری بفروشند.
اساس این حرف این است که کارمزدها نه فقط کاهش، بلکه افزایش نیز پیدا کند. به عبارتی به جای اینکه فاصله اطمینان Confidence Interval ذهن برای صدور فرمان فروش نازکتر شود، آن را پهنتر Wide نیز کنید.
واضح است که این مطلب، مربوط به حال و هوای این روزهای بازار سرمایه تهران است که ترس، مهمترین ویژگی غالب بر آن است و بیشتر افراد سر به سر فروش هستند. در آینده با بهبود اوضاع میتوان به کاهش کارمزدها هم فکر کرد.
نکته پایانی اینکه، افزایش کارمزدها حتی میتواند به صورت غیرواقعی و توسط اپلیکیشهای کارگزاری اعمال شود. مثل همان ساعت روی دیوار خانهها که ما به صورت غیرواقعی حتی چند دقیقه آن را جلو میکشیم، با این ذهنیت که دیر به جایی نرویم و یا زودتر به کارهایمان برسیم.
https://graphpad.ir/wp-content/uploads/2022/08/Bar-Histogram-of-Percent-Summary-Report.png

Regression_for_%قیمت_پایانی_vs_P_E_Model_Selection_Report.png
26 KB
البته که با مثال، نمیتوان یک قانون را اثبات کرد. با این حال گراف بالا را ببینید. مربوط به همین امروز یکشنبه 6 شهریور 1401 است.
در بیشتر روزها، همین نتیجه برقرار است. علاقمند بودید این پست را ببینید.
یک رگرسیون ساده بین P/E و قیمت پایانی. بررسی بر روی همه نمادهای معامله شده امروز.
آنچه که اهمیت دارد ضریب بتای مدل رگرسیونی مثبت است. یعنی هر چقدر P/E بزرگتر است، قیمت پایانی مثبتتر.
گراف دو نکته مهم دیگر در خود دارد.
الف) حجم انبوهی از نمادهای بازار دارای P/E های کوچک هستند. این مطلب به نظر بیانگر جذاب بودن این بازار برای سرمایهگزاری است.
ب) نقاط قرمز رنگ را ببینید. آنها دادههای Unusual و یا Large Residuals هستند. به زبان ساده بخواهم بگویم یعنی نمادهایی با بازیگرهای مخرب و تابلو خراب کن. نام آنها محفوظ است. هر چند بسیار ساده میتوان آنها را به دست آورد و بیان کرد.
فکر میکنم باز هم باید این بخش را به متن بالا اضافه کنم که
منظور من از بیان این نتایج، ارجحیت سرمایهگذاری در نمادهای زیان ده نسبت به نمادهای سود ده نیست.
بلکه منظور، بیان انحراف جدی و اساسی است که در بازار سرمایه تهران رخ داده است.
در بیشتر روزها، همین نتیجه برقرار است. علاقمند بودید این پست را ببینید.
یک رگرسیون ساده بین P/E و قیمت پایانی. بررسی بر روی همه نمادهای معامله شده امروز.
آنچه که اهمیت دارد ضریب بتای مدل رگرسیونی مثبت است. یعنی هر چقدر P/E بزرگتر است، قیمت پایانی مثبتتر.
گراف دو نکته مهم دیگر در خود دارد.
الف) حجم انبوهی از نمادهای بازار دارای P/E های کوچک هستند. این مطلب به نظر بیانگر جذاب بودن این بازار برای سرمایهگزاری است.
ب) نقاط قرمز رنگ را ببینید. آنها دادههای Unusual و یا Large Residuals هستند. به زبان ساده بخواهم بگویم یعنی نمادهایی با بازیگرهای مخرب و تابلو خراب کن. نام آنها محفوظ است. هر چند بسیار ساده میتوان آنها را به دست آورد و بیان کرد.
فکر میکنم باز هم باید این بخش را به متن بالا اضافه کنم که
منظور من از بیان این نتایج، ارجحیت سرمایهگذاری در نمادهای زیان ده نسبت به نمادهای سود ده نیست.
بلکه منظور، بیان انحراف جدی و اساسی است که در بازار سرمایه تهران رخ داده است.
اجازه دهید من یک سوال خیلی ساده از شما بپرسم.
100 بزرگتر است یا 1؟
من میگویم 1 از 100 بزرگتر است.
فرض کنید مغازهای قیمت اجناسش را با 100 درصد افزایش میفروشد، مثلاً اگر کالایی 1000 تومان است آن را با 100 درصد افزایش به دو برابر قیمت یعنی 2000 تومان میفروشد.
حال فرض کنید مغازه دیگری کنار همان مغازه قبلی است که خیلی ادعای مردم دوستی و کاربلدی دارد. او میگوید من فقط با یک درصد افزایش قیمت کالاهایم را میفروشم.
اما سوال بسیار مهم این است، یک درصد افزایش نسبت به چه چیزی؟
او با یک درصد افزایش قیمت بیشتر نسبت به مغازه قبلی (همان مغازهای که قیمت اجناسش را با 100 درصد افزایش میفروخت) کالاهایش را میفروشد. یعنی 101 درصد افزایش قیمت.
خب نتیجه چه میشود؟
این مغازه مردمدار، همان کالای 1000 تومانی را 2010 تومان میفروشد. ادعایش را هم همه جا پر کرده که بله، من خیلی خوب هستم و فقط یک درصد افزایش قیمت داشتهام و مغازه کناری، بد است چون 100 درصد افزایش قیمت داشته.
خب همه اینها یعنی چی؟
یعنی اینکه درست است که جامعه ایرانی زودباور و زخم خورده است، اما اینقدر فریبش ندهید.
ادعای اینکه تورم در دولت قبل مثلاً 50 درصد بوده و ما آن را کاهش دادهایم و شده مثلاً 30 درصد، یعنی همان کالای 1000 تومانی را اگر دولت قبل 1500 تومان تحویل داده، الان در دولت فعلی دقیقا شده است 1950 تومان.
لابد هم فکر کردهاید همه میگویند، چقدر خوب قبلاً 50 درصد تورم داشتیم الان 30 درصد داریم. پس اوضاع خوب شده. اما واقعیت این است که آن 30 از 50 بزرگتر است.
تورم یک آماره تجمعی Cumulative است و نه قدرمطلق Absolute. قطعا شما این را میدانید، اما روی ساده لوحی مردم بسیار حساب باز کردهاید.
https://graphpad.ir/wp-content/uploads/2022/08/photo_2022-08-30_08-53-50.jpg
100 بزرگتر است یا 1؟
من میگویم 1 از 100 بزرگتر است.
فرض کنید مغازهای قیمت اجناسش را با 100 درصد افزایش میفروشد، مثلاً اگر کالایی 1000 تومان است آن را با 100 درصد افزایش به دو برابر قیمت یعنی 2000 تومان میفروشد.
حال فرض کنید مغازه دیگری کنار همان مغازه قبلی است که خیلی ادعای مردم دوستی و کاربلدی دارد. او میگوید من فقط با یک درصد افزایش قیمت کالاهایم را میفروشم.
اما سوال بسیار مهم این است، یک درصد افزایش نسبت به چه چیزی؟
او با یک درصد افزایش قیمت بیشتر نسبت به مغازه قبلی (همان مغازهای که قیمت اجناسش را با 100 درصد افزایش میفروخت) کالاهایش را میفروشد. یعنی 101 درصد افزایش قیمت.
خب نتیجه چه میشود؟
این مغازه مردمدار، همان کالای 1000 تومانی را 2010 تومان میفروشد. ادعایش را هم همه جا پر کرده که بله، من خیلی خوب هستم و فقط یک درصد افزایش قیمت داشتهام و مغازه کناری، بد است چون 100 درصد افزایش قیمت داشته.
خب همه اینها یعنی چی؟
یعنی اینکه درست است که جامعه ایرانی زودباور و زخم خورده است، اما اینقدر فریبش ندهید.
ادعای اینکه تورم در دولت قبل مثلاً 50 درصد بوده و ما آن را کاهش دادهایم و شده مثلاً 30 درصد، یعنی همان کالای 1000 تومانی را اگر دولت قبل 1500 تومان تحویل داده، الان در دولت فعلی دقیقا شده است 1950 تومان.
لابد هم فکر کردهاید همه میگویند، چقدر خوب قبلاً 50 درصد تورم داشتیم الان 30 درصد داریم. پس اوضاع خوب شده. اما واقعیت این است که آن 30 از 50 بزرگتر است.
تورم یک آماره تجمعی Cumulative است و نه قدرمطلق Absolute. قطعا شما این را میدانید، اما روی ساده لوحی مردم بسیار حساب باز کردهاید.
https://graphpad.ir/wp-content/uploads/2022/08/photo_2022-08-30_08-53-50.jpg

چنانچه به مشاهده و بهتر شدن دانستههای خود در زمینه موضوعات و تحلیلهای آماری علاقمند هستید، در لینک زیر میتوانید آموزشهای ویدئویی انواع تحلیلهای آماری با نرمافزارهایی مانند
GraphPad Prism
IBM SPSS Statistics
Minitab
را ببینید.
https://www.aparat.com/GraphPad
GraphPad Prism
IBM SPSS Statistics
Minitab
را ببینید.
https://www.aparat.com/GraphPad
This media is not supported in your browser
VIEW IN TELEGRAM
تست مدل دیشب را ببینیم.
DARA.ETF 1401.06.13.jpg
29.8 KB
ابتدا باید از دوستان دقیق و خوب خودم تشکر کنم. من در ویدئو شب گذشته، از حجم روز قبل نام میبرم اما به اشتباه ستون تعداد معاملات را کپی میکنم. این را به حساب خستگی کار در آن ساعت شب بگذارید. البته در اصل موضوع و مدل تفاوتی وجود ندارد و مدل بر مبنای تعداد معاملات نیز به خوبی کار میکند. هر چند اگر همان حجم را قرار میدادیم، نتیجه بهتر و دقیقتری نیز میگرفتیم.
در ویدئو قبلی بیان کردم که بر مبنای مدل رگرسیون برازش شده، قیمت پایانی امروز دارا یکم برابر با 97720 خواهد بود.
عدد قیمت پایانی واقعی برابر با 97920 به دست آمده است. بنابراین خطای پیشبینی حدود 0.204 درصد (حدود دو دهم درصد خواهد بود).
البته که باز هم باید تاکید کنم که با مثال نمیتوان یک قانون را ثابت کرد، با این حال این نتیجه نشان میدهد، ابزارهای رگرسیونی قابلیتهای فراوانی جهت پیشبینی و برازش دقیق دادهها را دارند. در آینده سعی میکنم از آنها بیشتر صحبت کنم.
در ویدئو قبلی بیان کردم که بر مبنای مدل رگرسیون برازش شده، قیمت پایانی امروز دارا یکم برابر با 97720 خواهد بود.
عدد قیمت پایانی واقعی برابر با 97920 به دست آمده است. بنابراین خطای پیشبینی حدود 0.204 درصد (حدود دو دهم درصد خواهد بود).
البته که باز هم باید تاکید کنم که با مثال نمیتوان یک قانون را ثابت کرد، با این حال این نتیجه نشان میدهد، ابزارهای رگرسیونی قابلیتهای فراوانی جهت پیشبینی و برازش دقیق دادهها را دارند. در آینده سعی میکنم از آنها بیشتر صحبت کنم.
Time Series Plot of _CLOSE_, FITS (Palayesh.eft).png
20.7 KB
#پالایش
تقریباً با اطمینان میتوان گفت، آنچه در پالایش میگذرد، یک مدل رگرسیون از نوع خطی ساده Simple Linear Regression است که به سادگی میتوان آن را به دست آورد.
در گراف بالا، به ازای تمام روزهای معاملاتی پالایش، عدد واقعی پایانی (دایرههای سبزرنگ) در برابر پیشبینی مدل رگرسیونی (مربعهای نارنجی رنگ) رسم شده است.
همانگونه که میبینید پیش بینی های به دست آمده از یک مدل رگرسیونی، به اعداد واقعی قیمت پایانی بسیار نزدیک هستند.
من در ویدئو زیر علاوه بر چگونگی طراحی و ساختن این مدل رگرسیونی، به یک موضوع به نظرم مهمتر نیز پرداختهام.
پاسخ به این سوال که آیا بازار سرمایه (در اینجا مثال موردی صندوق پالایش) نسبت به ماهها و چند سال قبل پیشبینی پذیرتر شده است و یا از تحلیل و پیشبینی خارج شده است؟
علاقمند بودید ویدئو زیر را ببینید.👇
تقریباً با اطمینان میتوان گفت، آنچه در پالایش میگذرد، یک مدل رگرسیون از نوع خطی ساده Simple Linear Regression است که به سادگی میتوان آن را به دست آورد.
در گراف بالا، به ازای تمام روزهای معاملاتی پالایش، عدد واقعی پایانی (دایرههای سبزرنگ) در برابر پیشبینی مدل رگرسیونی (مربعهای نارنجی رنگ) رسم شده است.
همانگونه که میبینید پیش بینی های به دست آمده از یک مدل رگرسیونی، به اعداد واقعی قیمت پایانی بسیار نزدیک هستند.
من در ویدئو زیر علاوه بر چگونگی طراحی و ساختن این مدل رگرسیونی، به یک موضوع به نظرم مهمتر نیز پرداختهام.
پاسخ به این سوال که آیا بازار سرمایه (در اینجا مثال موردی صندوق پالایش) نسبت به ماهها و چند سال قبل پیشبینی پذیرتر شده است و یا از تحلیل و پیشبینی خارج شده است؟
علاقمند بودید ویدئو زیر را ببینید.👇
Media is too big
VIEW IN TELEGRAM
#پالایش
آیا بازار سرمایه نسبت به گذشته پیش بینی پذیرتر شده است؟ (مثال موردی صندوق پالایش)
آیا بازار سرمایه نسبت به گذشته پیش بینی پذیرتر شده است؟ (مثال موردی صندوق پالایش)
#مسابقه
15 دیماه سال 1397 اولین دوره مسابقاتی با نام نخستین دوره مسابقات معاملات الگوریتمی بازار سرمایه ایران، برگزار شد.
سال بعد نیز فکر میکنم در 28 دیماه سال 1398 دومین دوره این مسابقات برگزار شد.
من چند تصویر از آن مسابقات برایتان ارسال کردهام. تا آنجا هم که اطلاع دارم دیگر این مسابقات برگزار نشد. اما خب، همان دو دوره برگزاری به مذاق مسئولان آن روزها و این روزها خیلی خوش آمد. فهمیدند، عجب چیز خوبی است و کاملاً بازار را میتوان در کنترل خود بگیریم.
این چیزی که ماهها و شاید یکی دو سال است در بازار میبینید، نتیجه همان مسابقات است. خیلی صادقانه بخواهم بنویسم، برای من که خوب است. هر چقدر بازار الگوریتمیتر برای من آماری بهتر. به دلیل اینکه قابل پیشبینیتر و الگوپذیرتر میشود.
چند نمونه با استفاده از رگرسیون آن هم خطی ساده به شما در پستهای قبلی نشان دادم. R Square همه این مدلها بالای 99 درصد بود و این نشان میدهد اتفاقاً بازار الگوریتمی چقدر هم خوب است.
سعی میکنم در پست بعدی یک مدل رگرسیون غیرخطی با نام رگرسیون پروبیت Probit Regression به شما نشان دهم که عملکردی حتی بهتر از 99 درصد مدلهای قبلی هم دارد.
اما نکته مهم این است که این کار ببخشید، زشت است. همه که به الگوریتمها دسترسی ندارند. ببخشید، اصلا بلد هم نیستند. البته هنری هم نیست که کسی بلد باشد و دسترسی داشته باشد.
این متن را نوشتم که آن ضرب المثل را یادآوری کنم که دست بالای دست بسیار است. شما الگوریتم و منابع دارید و ما پروبیت و لجیت و اردینال و نامینال و بسیاری مدلهای رگرسیونی و یا سری زمانی دیگری داریم، دست شما را هم میخواند اما به نظرم این کار بدی است که بازار را از رفتار و کاربرهای انسانی خالی کردهاید.
15 دیماه سال 1397 اولین دوره مسابقاتی با نام نخستین دوره مسابقات معاملات الگوریتمی بازار سرمایه ایران، برگزار شد.
سال بعد نیز فکر میکنم در 28 دیماه سال 1398 دومین دوره این مسابقات برگزار شد.
من چند تصویر از آن مسابقات برایتان ارسال کردهام. تا آنجا هم که اطلاع دارم دیگر این مسابقات برگزار نشد. اما خب، همان دو دوره برگزاری به مذاق مسئولان آن روزها و این روزها خیلی خوش آمد. فهمیدند، عجب چیز خوبی است و کاملاً بازار را میتوان در کنترل خود بگیریم.
این چیزی که ماهها و شاید یکی دو سال است در بازار میبینید، نتیجه همان مسابقات است. خیلی صادقانه بخواهم بنویسم، برای من که خوب است. هر چقدر بازار الگوریتمیتر برای من آماری بهتر. به دلیل اینکه قابل پیشبینیتر و الگوپذیرتر میشود.
چند نمونه با استفاده از رگرسیون آن هم خطی ساده به شما در پستهای قبلی نشان دادم. R Square همه این مدلها بالای 99 درصد بود و این نشان میدهد اتفاقاً بازار الگوریتمی چقدر هم خوب است.
سعی میکنم در پست بعدی یک مدل رگرسیون غیرخطی با نام رگرسیون پروبیت Probit Regression به شما نشان دهم که عملکردی حتی بهتر از 99 درصد مدلهای قبلی هم دارد.
اما نکته مهم این است که این کار ببخشید، زشت است. همه که به الگوریتمها دسترسی ندارند. ببخشید، اصلا بلد هم نیستند. البته هنری هم نیست که کسی بلد باشد و دسترسی داشته باشد.
این متن را نوشتم که آن ضرب المثل را یادآوری کنم که دست بالای دست بسیار است. شما الگوریتم و منابع دارید و ما پروبیت و لجیت و اردینال و نامینال و بسیاری مدلهای رگرسیونی و یا سری زمانی دیگری داریم، دست شما را هم میخواند اما به نظرم این کار بدی است که بازار را از رفتار و کاربرهای انسانی خالی کردهاید.
#خطا
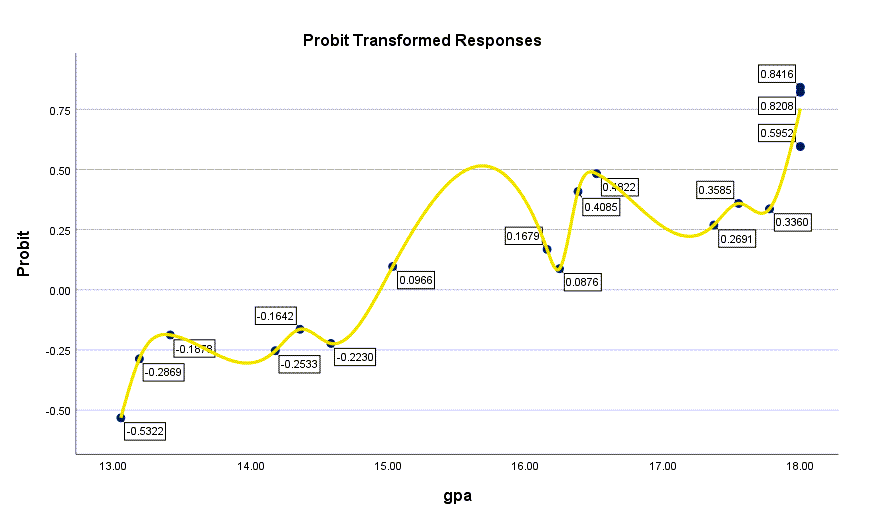
گرافی که میبینید، یک تصویر از مدل رگرسیونی پروبیت Probit Regression است که در پست قبلی از آن نام بردم.
این مدل رگرسیونی بر روی 18 روز معاملاتی یک نماد با Combination Index برابر با حدود 7 (یعنی تعداد معاملات ماشینی 7 برابر معاملات کاربران انسانی است)، برازش شده است. R Square این مدل پروبیت حدود 99.83 درصد است. یعنی با قطعیت 100 درصدی، فقط 17 صدم درصد فاصله دارد، آن هم در مجموع همه 18 روز معاملاتی.
واضح است که هر چه روزهای معاملاتی مورد بررسی، بیشتر شود، مدل بهتر هم میشود.
خب، حال مشکل من چیست؟ من با آن Combination Index (CI) برابر با 7 این نماد و کل بازار سرمایه که حدود 4.9 است، مشکل دارم.
این عدد باید زیر یک باشد. قرار نیست حذف شود و من هم از حذف معاملات الگوریتمی یا هر اسم دیگری که میخواهید بر آن بگذارید حرف نمیزنم، من از بزرگ بودن بیش از حد CI در همه نمادها حرف میزنم. عدد CI < 1 باید باشد.
یعنی کاربران غیرانسانی باشند، اما کمتر از کاربران و معاملات انسانی. به زبان سادهتر R Square مدلهای رگرسیونی نباید اینقدر خوب و عالی باشند، آنها باید به دلیل ورود افراد واقعی، خطا داشته باشند.
رگرسیونها، رفتار ماشینها را میتواند تشخیص دهد، اما حتی بهترین آنها رفتار انسانها را با خطا برازش میکند. من به دنبال این خطا هستم و از ضرورت وجود آن، حرف میزنم.
https://graphpad.ir/wp-content/uploads/2022/09/Probit-Regression-SPSS-20-GraphPad.ir_.png
گرافی که میبینید، یک تصویر از مدل رگرسیونی پروبیت Probit Regression است که در پست قبلی از آن نام بردم.
این مدل رگرسیونی بر روی 18 روز معاملاتی یک نماد با Combination Index برابر با حدود 7 (یعنی تعداد معاملات ماشینی 7 برابر معاملات کاربران انسانی است)، برازش شده است. R Square این مدل پروبیت حدود 99.83 درصد است. یعنی با قطعیت 100 درصدی، فقط 17 صدم درصد فاصله دارد، آن هم در مجموع همه 18 روز معاملاتی.
واضح است که هر چه روزهای معاملاتی مورد بررسی، بیشتر شود، مدل بهتر هم میشود.
خب، حال مشکل من چیست؟ من با آن Combination Index (CI) برابر با 7 این نماد و کل بازار سرمایه که حدود 4.9 است، مشکل دارم.
این عدد باید زیر یک باشد. قرار نیست حذف شود و من هم از حذف معاملات الگوریتمی یا هر اسم دیگری که میخواهید بر آن بگذارید حرف نمیزنم، من از بزرگ بودن بیش از حد CI در همه نمادها حرف میزنم. عدد CI < 1 باید باشد.
یعنی کاربران غیرانسانی باشند، اما کمتر از کاربران و معاملات انسانی. به زبان سادهتر R Square مدلهای رگرسیونی نباید اینقدر خوب و عالی باشند، آنها باید به دلیل ورود افراد واقعی، خطا داشته باشند.
رگرسیونها، رفتار ماشینها را میتواند تشخیص دهد، اما حتی بهترین آنها رفتار انسانها را با خطا برازش میکند. من به دنبال این خطا هستم و از ضرورت وجود آن، حرف میزنم.
https://graphpad.ir/wp-content/uploads/2022/09/Probit-Regression-SPSS-20-GraphPad.ir_.png
Media is too big
VIEW IN TELEGRAM
به نظرم خوب است در کنار همه چیزهایی که بلد هستیم، به یادگیری تئوریهای رگرسیونی و سری زمانی در گام اول و سپس کار با نرمافزارهای آماری در گام بعد بپردازیم.
در این ویدئو یک مدل رگرسیونی بسیار ساده که در #شستا برقرار است، بیان شده است.
عدد R Square این مدل رگرسیونی به لطف الگوریتم موجود در شستا 99.9 درصد است.
همانگونه که قبلاً نیز نوشتم، وجود الگوریتمها، راه را برای کشف مدلهای رگرسیونی موجود در هر نماد، ساده کرده است.
من در این پست که آذرماه سال 99 آن را نوشتم، عنوان کردم که شستا و روند رفتاری آن یک پروژه است، جهت اثبات یک ایده و تحلیل خاص.
در این پست نیز که مربوط به اسفند سال 99 بود، به وضوح نوشتم که در شستا و برخی نمادهای دیگر که نام آنها را آوردم، دادهسازی انجام میشود.
آنچه امروز و در این ویدئو بیان کردهام، این است که دادهسازان و الگوریتم نویسان حتی زحمت طراحی یک مدل پیچیده را هم به خودشان ندادهاند. بلکه ما در شستا با یک رگرسیون بسیار ساده و ابتدایی روبهرو هستیم.
علاقمند بودید ویدئو را ببینید و البته بار دیگر این پست را به خودم یادآوری میکنم که در آن (آذرماه 99) نوشتم، همه چیز رگرسیون است.
در این ویدئو یک مدل رگرسیونی بسیار ساده که در #شستا برقرار است، بیان شده است.
عدد R Square این مدل رگرسیونی به لطف الگوریتم موجود در شستا 99.9 درصد است.
همانگونه که قبلاً نیز نوشتم، وجود الگوریتمها، راه را برای کشف مدلهای رگرسیونی موجود در هر نماد، ساده کرده است.
من در این پست که آذرماه سال 99 آن را نوشتم، عنوان کردم که شستا و روند رفتاری آن یک پروژه است، جهت اثبات یک ایده و تحلیل خاص.
در این پست نیز که مربوط به اسفند سال 99 بود، به وضوح نوشتم که در شستا و برخی نمادهای دیگر که نام آنها را آوردم، دادهسازی انجام میشود.
آنچه امروز و در این ویدئو بیان کردهام، این است که دادهسازان و الگوریتم نویسان حتی زحمت طراحی یک مدل پیچیده را هم به خودشان ندادهاند. بلکه ما در شستا با یک رگرسیون بسیار ساده و ابتدایی روبهرو هستیم.
علاقمند بودید ویدئو را ببینید و البته بار دیگر این پست را به خودم یادآوری میکنم که در آن (آذرماه 99) نوشتم، همه چیز رگرسیون است.
درباره ویدئو و محتوای آموزشی قبلی که به موضوع شستا پرداختم، اگر نخواهم بگویم اهانت بلکه با چشمپوشی بگویم انتقاد، چند پیام البته از دیگران برایم ارسال شده بود.
در ادامه چند خط بیشتر درباره آن نوشتهام. دوست داشتید بخوانید.
صرفنظر از اینکه همبسته یعنی چه و صرفنظر از اینکه آیا X و Y ما در اینجا همبسته هستند یا نیستند، خوب است به پیشفرضهای تحلیل رگرسیون ان هم از نوع خطی نگاه شود. یعنی ما چه زمانی رگرسیون استفاده میکنیم.
در لینک زیر که مربوط به سایت آموزشی Laerd است و بیشتر به آموزش نرمافزار SPSS میپردازد، پیش فرضهای انجام یک تحلیل رگرسیون خطی آمده است. آن را ببینید.
در آنجا هفت پیش فرض شروع تحلیل رگرسیونی آمده است.
https://statistics.laerd.com/spss-tutorials/linear-regression-using-spss-statistics.php
درباره خود این مثال و دادهها هم بهتر است تصویر زیر که بیانگر نتایج و خروجیهای نرمافزار SPSS است، آمده است. من دور بخش Collinearity Statistics آن که به بیان آمارههای Tolerance و VIF میپردازد و هر دو برابر با یک هستند، خط کشیدهام.
https://graphpad.ir/wp-content/uploads/2022/10/2022-10-06_19-28-51.png
البته معمولا وقتی ما فقط یک X در مدل رگرسیونی خود داریم، لزومی به محاسبه آمارههای Collinearity Statistics نیست.
پاسخ به این سوال که اصلا Collinearity Statistics چه هستند را هم به خود سازنده نرمافزار SPSS یعنی IBM میسپارم. در لینک زیر میتوانید ببینید.
https://www.ibm.com/docs/SSLVMB_24.0.0/spss/tutorials/reg_cars_collin_01.html
البته من به مدتها قبل درباره Collinearity Statistics در سایت گراف پد توضیح و اموزش دادهام. علاقمند بودید لینک زیر را ببینید.
https://graphpad.ir/collinearity-diagnostics-spss/
درباره رگرسیون خطی و R Square هم، به وضوح من چندین بار از ساده بودن این نوع مدلها و البته سادهترین آنها حرف زدم. بله ما بسیاری مدلهای پیچیدهتر رگرسیونی و آماری داریم. آنچه من بیان کردم و چندین بار هم گفتم، یک مدل رگرسیونی ساده بود که سعی شده برای عموم قابل فهم باشد. مهمترین هدف از بیان ان نیز آشنایی با این نوع تحلیلها و البته رگرسیون برای عامه خوانندگان است.
در ادامه چند خط بیشتر درباره آن نوشتهام. دوست داشتید بخوانید.
صرفنظر از اینکه همبسته یعنی چه و صرفنظر از اینکه آیا X و Y ما در اینجا همبسته هستند یا نیستند، خوب است به پیشفرضهای تحلیل رگرسیون ان هم از نوع خطی نگاه شود. یعنی ما چه زمانی رگرسیون استفاده میکنیم.
در لینک زیر که مربوط به سایت آموزشی Laerd است و بیشتر به آموزش نرمافزار SPSS میپردازد، پیش فرضهای انجام یک تحلیل رگرسیون خطی آمده است. آن را ببینید.
در آنجا هفت پیش فرض شروع تحلیل رگرسیونی آمده است.
https://statistics.laerd.com/spss-tutorials/linear-regression-using-spss-statistics.php
درباره خود این مثال و دادهها هم بهتر است تصویر زیر که بیانگر نتایج و خروجیهای نرمافزار SPSS است، آمده است. من دور بخش Collinearity Statistics آن که به بیان آمارههای Tolerance و VIF میپردازد و هر دو برابر با یک هستند، خط کشیدهام.
https://graphpad.ir/wp-content/uploads/2022/10/2022-10-06_19-28-51.png
البته معمولا وقتی ما فقط یک X در مدل رگرسیونی خود داریم، لزومی به محاسبه آمارههای Collinearity Statistics نیست.
پاسخ به این سوال که اصلا Collinearity Statistics چه هستند را هم به خود سازنده نرمافزار SPSS یعنی IBM میسپارم. در لینک زیر میتوانید ببینید.
https://www.ibm.com/docs/SSLVMB_24.0.0/spss/tutorials/reg_cars_collin_01.html
البته من به مدتها قبل درباره Collinearity Statistics در سایت گراف پد توضیح و اموزش دادهام. علاقمند بودید لینک زیر را ببینید.
https://graphpad.ir/collinearity-diagnostics-spss/
درباره رگرسیون خطی و R Square هم، به وضوح من چندین بار از ساده بودن این نوع مدلها و البته سادهترین آنها حرف زدم. بله ما بسیاری مدلهای پیچیدهتر رگرسیونی و آماری داریم. آنچه من بیان کردم و چندین بار هم گفتم، یک مدل رگرسیونی ساده بود که سعی شده برای عموم قابل فهم باشد. مهمترین هدف از بیان ان نیز آشنایی با این نوع تحلیلها و البته رگرسیون برای عامه خوانندگان است.
Laerd
Linear Regression Analysis in SPSS Statistics - Procedure, assumptions and reporting the output.
How to perform a simple linear regression analysis using SPSS Statistics. It explains when you should use this test, how to test assumptions, and a step-by-step guide with screenshots using a relevant example.
یک نکته دیگر که به اهمیت بیان آن تاکید دارم این است که من در تاریخ 10 آذرماه سال 99 به صراحت در این پست نوشتم که
گراف پد یک کانال بورسی نیست.
سایت گراف پد نیز هرگز بورسی نبوده و به آنچه میپردازد، آموزش صرف آمار و تحلیلهای آماری است.
با این حال این بار میخواهم در پاسخ به اهانتهای نوشته شده در حق من در جاهای مختلف، که امروز به واسطه برایم ارسال شده بود، سوال بپرسم که
آیا من تا به حال در اینجا یا هر جای دیگری سهمی و نمادی برای خرید یا فروش معرفی کردهام؟ آیا ریالی و فقط یک ریال از کسی تحت هر عنوان بورسی دریافت کردهام؟ آیا یک نفر و حتی یک نفر وجود دارد که بگوید من به او چیزی به اسم پکیج بورسی فروختهام؟
و در پایان، به این فکر میکنم که شما را با فضای کانالهای بورسی تلگرام تنها بگذارم و به قول همان پیرمرد کشاورز طبسی خودتان میدانید و بورستان و از این به بعد گراف پد صرفاً به آموزش علوم آماری و نه کاربردهای آن در موضوعات بورسی، بپردازد.
گراف پد یک کانال بورسی نیست.
سایت گراف پد نیز هرگز بورسی نبوده و به آنچه میپردازد، آموزش صرف آمار و تحلیلهای آماری است.
با این حال این بار میخواهم در پاسخ به اهانتهای نوشته شده در حق من در جاهای مختلف، که امروز به واسطه برایم ارسال شده بود، سوال بپرسم که
آیا من تا به حال در اینجا یا هر جای دیگری سهمی و نمادی برای خرید یا فروش معرفی کردهام؟ آیا ریالی و فقط یک ریال از کسی تحت هر عنوان بورسی دریافت کردهام؟ آیا یک نفر و حتی یک نفر وجود دارد که بگوید من به او چیزی به اسم پکیج بورسی فروختهام؟
و در پایان، به این فکر میکنم که شما را با فضای کانالهای بورسی تلگرام تنها بگذارم و به قول همان پیرمرد کشاورز طبسی خودتان میدانید و بورستان و از این به بعد گراف پد صرفاً به آموزش علوم آماری و نه کاربردهای آن در موضوعات بورسی، بپردازد.