
浏览器里的动效设计工作室 AtomCut
AtomCut 最初只是用来做文字动画的工具,如今已发展成浏览器端的无限画布加多轨时间线:可对任意元素打关键帧、用水彩笔刷绘制、跟踪运动、添加跟随语音的字幕,并导出 MP4、GIF、SVG 或 Lottie。免费、无需账号、支持离线使用。
作者分享了背后的架构思路:描述动画内容的部分放在不含 DOM 和 React 的纯包中,展示与编辑逻辑放在应用层。项目是单个 JSON 文档,用 zod 校验并带版本号,当前 schema 版本 71,所有迁移仍可运行,早期项目也能打开。渲染帧是纯函数,播放、拖动、MP4/PNG 序列/Lottie 导出都调用同一函数,不存在预览与导出渲染器分叉的问题。撤销基于补丁而非快照,成本与改动大小成正比。
局限在于浏览器渲染难以胜任两小时 4K 时间线,重度素材仍不如原生剪辑软件。免费版导出上限 720p,一次性付费 29 美元解除限制,非订阅制。后续计划包括实时协作、可操作时间线的编辑器内助手,以及开放插件 SDK。无需注册,打开 app.atomcut.net 即可使用。
🔗 原文:点击查看
AtomCut 最初只是用来做文字动画的工具,如今已发展成浏览器端的无限画布加多轨时间线:可对任意元素打关键帧、用水彩笔刷绘制、跟踪运动、添加跟随语音的字幕,并导出 MP4、GIF、SVG 或 Lottie。免费、无需账号、支持离线使用。
作者分享了背后的架构思路:描述动画内容的部分放在不含 DOM 和 React 的纯包中,展示与编辑逻辑放在应用层。项目是单个 JSON 文档,用 zod 校验并带版本号,当前 schema 版本 71,所有迁移仍可运行,早期项目也能打开。渲染帧是纯函数,播放、拖动、MP4/PNG 序列/Lottie 导出都调用同一函数,不存在预览与导出渲染器分叉的问题。撤销基于补丁而非快照,成本与改动大小成正比。
真正难的不是 36 种图层特效——特效本质是着色器加设置卡片,关键帧引擎已能驱动任意数量。难点在于两类正确事实互相冲突的场景:
裁剪视频时窗口与内部画面都可移动,若存成单一变换加四个内边距,关键帧间的重取景会明显漂移。修复方案是窗口与内容各用一套变换,内容变换不读取裁剪值。
镜像图层本质是负缩放。作者曾用 flipX 标志,标志加符号两个字段描述同一事实,跨翻转插值时互相矛盾,删除标志后相关 bug 一并消失。
帧率是网格而非时间。项目没有全局 fps,每个合成自带帧率,只做量化:标尺刻度、方向键步进、导出迭代都基于它。60 fps 合成里的 12 fps 翻页书每格停留 83.33 ms,无重采样就不会漂移。
每次改动须先在公开 changelog 写一行「用户现在能做什么以前做不到的事」,写不出就不发布。约一半已开始的改动因此被砍掉。
局限在于浏览器渲染难以胜任两小时 4K 时间线,重度素材仍不如原生剪辑软件。免费版导出上限 720p,一次性付费 29 美元解除限制,非订阅制。后续计划包括实时协作、可操作时间线的编辑器内助手,以及开放插件 SDK。无需注册,打开 app.atomcut.net 即可使用。
🔗 原文:点击查看
Go 爬虫 Cinder 更名 Tomoshibi 灯火
Go 爬虫工具 Cinder 正式更名为 Tomoshibi(灯火)。同名 API、同名爬虫,只是换了名字,旧 GitHub 链接自动重定向,star 数保留。
自托管、无按 token 计费,单二进制、低内存占用。后续路线图不变,继续改进 SPA 启发式与测试。
GitHub: GitHub
npm: npm
🔗 原文:点击查看
Go 爬虫工具 Cinder 正式更名为 Tomoshibi(灯火)。同名 API、同名爬虫,只是换了名字,旧 GitHub 链接自动重定向,star 数保留。
改名原因:原名难搜索,且与大量其他项目撞名。新名取自日语「灯火」,寓意把杂乱 HTML 转成 LLM 可读的干净 markdown。
结构变化:原先分散的 cinder、cinder-tmcp、cinder-sv 三个仓库合并为单一 monorepo,包含 Go API(Gin + Colly + Chromedp + SearXNG)、MCP 服务器(3 个工具,npm 包 tomoshi)和 Svelte 5 网页 playground。
无破坏性变更:/v1/scrape、/v1/crawl、/v1/search、/v1/map 接口不变;旧 CINDER_API_URL 环境变量仍作为回退读取;旧 Docker 标签暂时仍可拉取。
迁移:Docker Compose 一条命令起全套(api 7431 + mcp 7433 + web 7432 + redis 7434 + searxng 7435);MCP 配置改用 npx -y tomoshi;Go import 路径改为 github.com/Michael-Obele/tomoshibi。
性能基准不变:search-bench.py(10 workers/30s)约 560 req/s,p50 11ms。
自托管、无按 token 计费,单二进制、低内存占用。后续路线图不变,继续改进 SPA 启发式与测试。
GitHub: GitHub
npm: npm
🔗 原文:点击查看
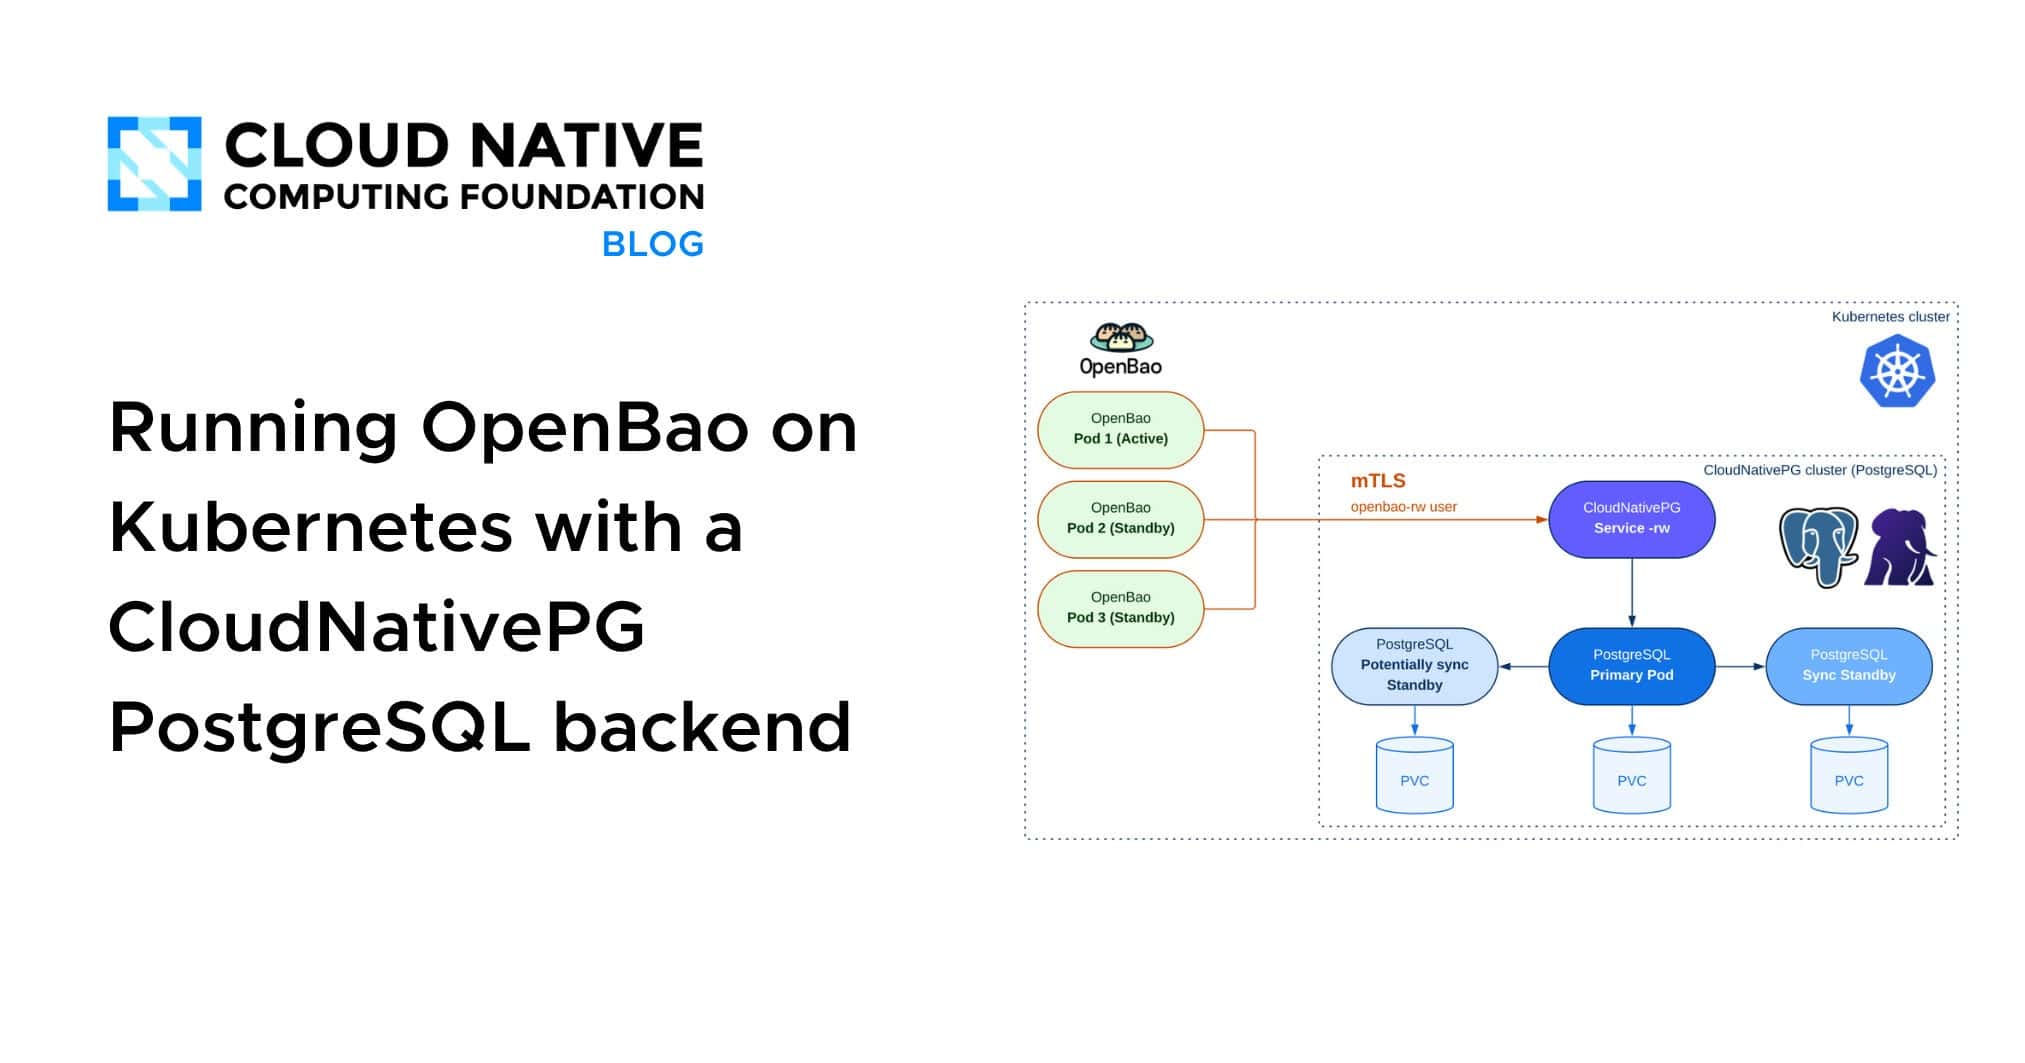
OpenBao + CloudNativePG:K8s 原生密钥管理全栈
OpenBao(HashiCorp Vault 的 Linux Foundation 开源分支)与 CloudNativePG(CNCF Sandbox 项目)组合,提供完全开源、无云依赖的密钥管理解决方案。通过 PostgreSQL 作为后端存储,CNPG 的三节点同步复制实现零数据丢失,OpenBao 的 mTLS 认证与 pg_hba 规则确保无密码安全。
1. 部署流程
- 使用 cnpg-playground 快速创建 Kind 集群。
- 部署 CloudNativePG、cert‑manager、Barman Cloud 插件,创建三节点 CNPG 集群。
- 通过 DatabaseRole CRD 为 OpenBao 生成 TLS 证书,配置 pg_hba 只允许证书认证。
2. 初始化与安全
- 运行一次性 Job 创建 OpenBao 所需的两张表(openbao_kv_store、openbao_ha_locks)。
- 通过 Job 重新授权,限制 PUBLIC 访问,仅授予 openbao‑rw 角色必要权限。
3. OpenBao 部署
- 使用官方 Helm chart,挂载证书与 CA,禁用本地持久化。
- 配置 anti‑affinity 与 tolerations,确保 OpenBao 与 PostgreSQL 节点分离。
4. 验证
- 初始化并逐个 unseal OpenBao 实例。
- 通过 OpenBao CLI 写入、读取 KV,确认数据已加密存储在 PostgreSQL。
5. 运维提示
- CNPG 证书 90 天有效,自动续期;OpenBao 需滚动重启以加载新证书。
- 可通过 Barman Cloud 插件实现 WAL 归档与定时备份,支持点时间恢复。
🔗 原文:点击查看
OpenBao(HashiCorp Vault 的 Linux Foundation 开源分支)与 CloudNativePG(CNCF Sandbox 项目)组合,提供完全开源、无云依赖的密钥管理解决方案。通过 PostgreSQL 作为后端存储,CNPG 的三节点同步复制实现零数据丢失,OpenBao 的 mTLS 认证与 pg_hba 规则确保无密码安全。
1. 部署流程
- 使用 cnpg-playground 快速创建 Kind 集群。
- 部署 CloudNativePG、cert‑manager、Barman Cloud 插件,创建三节点 CNPG 集群。
- 通过 DatabaseRole CRD 为 OpenBao 生成 TLS 证书,配置 pg_hba 只允许证书认证。
2. 初始化与安全
- 运行一次性 Job 创建 OpenBao 所需的两张表(openbao_kv_store、openbao_ha_locks)。
- 通过 Job 重新授权,限制 PUBLIC 访问,仅授予 openbao‑rw 角色必要权限。
3. OpenBao 部署
- 使用官方 Helm chart,挂载证书与 CA,禁用本地持久化。
- 配置 anti‑affinity 与 tolerations,确保 OpenBao 与 PostgreSQL 节点分离。
4. 验证
- 初始化并逐个 unseal OpenBao 实例。
- 通过 OpenBao CLI 写入、读取 KV,确认数据已加密存储在 PostgreSQL。
5. 运维提示
- CNPG 证书 90 天有效,自动续期;OpenBao 需滚动重启以加载新证书。
- 可通过 Barman Cloud 插件实现 WAL 归档与定时备份,支持点时间恢复。
GitHub: GitHub
Helm repo:
🔗 原文:点击查看
Kubernetes v1.37 新增容器存储硬化功能
Kubernetes v1.37 引入了 emptyDir 权限模式 与 bind‑mount 选项,让开发者能在容器内直接控制可写卷的执行与删除权限。
- noexec / nosuid / nodev:防止在可写卷中下载、chmod + x 并执行恶意二进制,提升工作负载安全。
- mode 01777:为共享 writable 目录(如 /tmp)设置粘性位,保证同一 Pod 内不同容器只能删除自己的文件。
- 这些特性目前为 Alpha,需在 API Server 与 kubelet 上开启 VolumeBindMountOptions 与 EmptyDirVolumeMode。
典型用例
- CI/CD 多容器 Pod 共享工作区时,使用
- 数据库 Pod 的临时存储可设
- 通过
使用示例
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-bindmount-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
securityContext:
readOnlyRootFilesystem: true
volumeMounts:
- name: temp
mountPath: /tmp
bindMountOptions: [noexec, nosuid]
volumes:
- name: temp
emptyDir: {}
```
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-emptydir-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
volumeMounts:
- name: shared
mountPath: /tmp
volumes:
- name: shared
emptyDir:
mode: 01777
```
验证方法
- 在挂载了
- 在
GitHub: GitHub
GitHub: GitHub
🔗 原文:点击查看
Kubernetes v1.37 引入了 emptyDir 权限模式 与 bind‑mount 选项,让开发者能在容器内直接控制可写卷的执行与删除权限。
- noexec / nosuid / nodev:防止在可写卷中下载、chmod + x 并执行恶意二进制,提升工作负载安全。
- mode 01777:为共享 writable 目录(如 /tmp)设置粘性位,保证同一 Pod 内不同容器只能删除自己的文件。
- 这些特性目前为 Alpha,需在 API Server 与 kubelet 上开启 VolumeBindMountOptions 与 EmptyDirVolumeMode。
典型用例
- CI/CD 多容器 Pod 共享工作区时,使用
mode: 01777 让各容器只能写入自己的文件。- 数据库 Pod 的临时存储可设
mode: 0750,仅限数据库用户访问。- 通过
bindMountOptions: [noexec, nosuid] 防止受损容器在 writable 卷中执行代码。使用示例
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-bindmount-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
securityContext:
readOnlyRootFilesystem: true
volumeMounts:
- name: temp
mountPath: /tmp
bindMountOptions: [noexec, nosuid]
volumes:
- name: temp
emptyDir: {}
```
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-emptydir-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
volumeMounts:
- name: shared
mountPath: /tmp
volumes:
- name: shared
emptyDir:
mode: 01777
```
验证方法
- 在挂载了
noexec 的卷中尝试执行脚本,系统会返回 Permission denied。- 在
mode: 01777 的卷中,非文件所有者无法删除他人文件,返回 Operation not permitted。详细文档请参阅官方 KEP‑5855 与 KEP‑5502。
这些功能适用于 Linux 节点,Windows 节点不受影响。
GitHub: GitHub
GitHub: GitHub
🔗 原文:点击查看
PostgreSQL 逻辑复制 worker 资源管理详解
在 PostgreSQL 10 起,
每个启用的订阅至少占用一个 worker slot,永久占用。若订阅使用
🔗 原文:postgr.es/p/9uK
在 PostgreSQL 10 起,
max_logical_replication_workers 控制逻辑复制的 worker 池大小。默认值为 4,范围 0‑262143。该参数只影响订阅端;发布端使用 max_wal_senders。当 worker 池耗尽时,订阅不会报错,而是停止进度,日志会每 5 秒输出一次警告。每个启用的订阅至少占用一个 worker slot,永久占用。若订阅使用
streaming = parallel,首次大事务后会保留额外的 slot;并且在同步表时会临时占用 max_sync_workers_per_subscription(默认 2)个 slot。整个集群共享 max_worker_processes(默认 8),该值还需为并行查询、扩展等后台工作预留空间。若发现日志中出现 “out of logical replication worker slots”,可通过增大 max_logical_replication_workers 或 max_worker_processes 并重启解决;或者临时禁用不需要的订阅释放 slot。通过调整这些参数,能避免订阅卡住、日志噪声和 WAL 滞留,保持复制链路的稳定与高效。
🔗 原文:postgr.es/p/9uK
PostgreSQL 19 迟发:关键功能被撤回
PostgreSQL 19 计划在 2026 年 9 月 24 日发布 Beta 4,但实际发布时间已推迟数周甚至数月。
主要原因是 beta 期间出现大量功能回退,团队将重点放在质量与时间窗口内的交付上,缩减发布范围。
核心回退概览
结论
PostgreSQL 19 的发布延迟是对质量的坚持。虽然部分预期功能被推迟,但最终版本仍将包含多项性能改进和新特性。
PostgreSQL 19 计划在 2026 年 9 月 24 日发布 Beta 4,但实际发布时间已推迟数周甚至数月。
主要原因是 beta 期间出现大量功能回退,团队将重点放在质量与时间窗口内的交付上,缩减发布范围。
核心回退概览
- SQL/PGQ(属性图查询)
- ALTER TABLE MERGE/SPLIT PARTITION
- UPDATE/DELETE FOR PORTION(时间范围列)
- GROUP BY ALL(ORDER BY 处理错误)
- 默认 TOAST 压缩改为 lz4(构建支持不足)
- pg_dumpall 的非文本输出格式
- JSON_TABLE ON ERROR 级联
- 非易失性约束域的快速默认值
- 逻辑复制数据库特定快照(REPACK 限制)
- pg_stat_statements 的嵌套查询跟踪
- 在线数据校验和
影响与后续
- 53 项回退已在 beta 开始后出现。
- 许多大功能因设计缺陷、错误结果或兼容性问题被撤回,计划在 PostgreSQL 20 重新尝试。
- 仍有部分功能(如 pg_plan_advice、并行 autovacuum、ON CONFLICT DO SELECT、窗口函数 IGNORE NULLS 等)保留。
- AI 工具在发现缺陷和生成可复现测试用例方面发挥作用,导致更多回退。
结论
PostgreSQL 19 的发布延迟是对质量的坚持。虽然部分预期功能被推迟,但最终版本仍将包含多项性能改进和新特性。
突破 DynamoDB 向量搜索 TopK=100 限制
DynamoDB 在 2026 年 8 月正式支持向量数据,但单次查询最多返回 100 条结果,限制了 RAG 方案中“先广泛检索再重排”的实现。
通过把分区键拆成多值(分片)并并行查询,每个分片返回 100 条,再合并排序,可实现等价于 TopK=500 的效果。
- 分片方案:使用
- 查询流程:并行发起 5 次查询 → 合并去重 → 按距离排序。
- 效果:单次查询 500 条候选块,源文档数从 1 增至 10。
- 成本:单查询 112 KB,5 分片 367 KB,月 1 M 次查询成本从 0.24 USD 提升至 0.78 USD。
- 注意:分片数变更需重新导入;并行查询受调用方 CPU 限制,单线程 CPU 低时并行无效。
此方法将分区键从“限制搜索范围”转为“扩展结果数量”,为想用 DynamoDB 进行 RAG、重排且不想额外管理 S3 Vectors 的开发者提供了可行方案。
DynamoDB 在 2026 年 8 月正式支持向量数据,但单次查询最多返回 100 条结果,限制了 RAG 方案中“先广泛检索再重排”的实现。
通过把分区键拆成多值(分片)并并行查询,每个分片返回 100 条,再合并排序,可实现等价于 TopK=500 的效果。
- 分片方案:使用
hash(chunk_id) % N_SHARDS 将数据均匀分配到 5 个分片。- 查询流程:并行发起 5 次查询 → 合并去重 → 按距离排序。
- 效果:单次查询 500 条候选块,源文档数从 1 增至 10。
- 成本:单查询 112 KB,5 分片 367 KB,月 1 M 次查询成本从 0.24 USD 提升至 0.78 USD。
- 注意:分片数变更需重新导入;并行查询受调用方 CPU 限制,单线程 CPU 低时并行无效。
此方法将分区键从“限制搜索范围”转为“扩展结果数量”,为想用 DynamoDB 进行 RAG、重排且不想额外管理 S3 Vectors 的开发者提供了可行方案。
日本站点字体错误:隐藏的视觉缺陷
日本站点的文字在大多数设备上会被错误渲染成中文字体。
- 109 家全球品牌中有 5 家在 CSS 里优先使用中文字体,导致所有访问者看到的日文文字采用中文字形。
- 81% 的日本公司已声明日文字体,而全球品牌仅 42%。
- 87% 的全球品牌在无日文字体环境下(如 Linux、服务器渲染)会出现中文字形。
根本原因
Unicode 将日中共享字符统一编码,视觉差异由字体决定。若 CSS 未声明日文字体,浏览器会使用设备默认字体;若声明中文字体且排在前面,所有日文字会被渲染为中文字形。
三步修复
1. 在
2. 明确声明日文字体:
3. 如需 Web 字体,可使用子集(几十 KB)并配合
检测工具
使用免费扫描器(glyphchecker.com)可对比有无日文字体环境下的渲染差异,并给出修复 CSS。
日本站点的文字在大多数设备上会被错误渲染成中文字体。
- 109 家全球品牌中有 5 家在 CSS 里优先使用中文字体,导致所有访问者看到的日文文字采用中文字形。
- 81% 的日本公司已声明日文字体,而全球品牌仅 42%。
- 87% 的全球品牌在无日文字体环境下(如 Linux、服务器渲染)会出现中文字形。
根本原因
Unicode 将日中共享字符统一编码,视觉差异由字体决定。若 CSS 未声明日文字体,浏览器会使用设备默认字体;若声明中文字体且排在前面,所有日文字会被渲染为中文字形。
三步修复
1. 在
<html> 加 lang="ja"。2. 明确声明日文字体:
font-family:"Noto Sans JP","Hiragino Sans","Yu Gothic",sans-serif;,并确保中文字体不在前。3. 如需 Web 字体,可使用子集(几十 KB)并配合
unicode-range。检测工具
使用免费扫描器(glyphchecker.com)可对比有无日文字体环境下的渲染差异,并给出修复 CSS。
只需一行 CSS,即可消除设备差异,保证所有用户看到正确的日文字形。
标题
BootSaaS:schema‑per‑tenant 方案防止跨租户数据泄露
正文
BootSaaS 为想要在 Spring Boot + Angular 环境下快速搭建安全、可扩展 SaaS 的团队提供了完整的架构与实现参考。
BootSaaS:schema‑per‑tenant 方案防止跨租户数据泄露
正文
在 B2B SaaS 中,单一查询缺失租户过滤即可让用户看到其他客户的账单。
BootSaaS 采用 schema‑per‑tenant 架构:
- 每个租户拥有独立的 PostgreSQL schema(如acme.invoices、globex.invoices)。
- 业务查询保持简洁:SELECT id, amount FROM invoices,连接层根据租户上下文自动切换到对应 schema。
- 通过 Spring Security 解析 JWT 中的 tenantId,填充CurrentTenantIdentifierResolver与MultiTenantConnectionProvider,确保请求在正确的 schema 下执行。
核心优势
- 业务表隔离:不同租户的数据完全分离,避免误读。
- 共享连接池:单一数据库角色与统一 HikariCP 池,资源利用率高。
- 统一迁移:Liquibase 负责所有租户的 schema 变更,迁移脚本可复用。
实现要点
- 租户注册后异步创建 schema,完成迁移才标记为可用。
- 迁移历史与锁表放在各自租户 schema,防止跨租户冲突。
- 通过测试覆盖:租户导出不泄露他人数据、ID 访问隔离、错误迁移恢复等。
BootSaaS 为想要在 Spring Boot + Angular 环境下快速搭建安全、可扩展 SaaS 的团队提供了完整的架构与实现参考。
AI 编码助手的仓库安全风险
AI 编码助手在打开仓库时会读取代码、配置、脚本和专属指令文件。
如果仓库包含恶意配置或脚本,助手会在执行常规 Git 操作(如
主要威胁
结语
AI 编码助手是强大工具,但其对仓库的深度访问也带来了新的安全边界。开发者需像对待任何特权系统一样,对仓库、助手指令和凭证进行严格审查与隔离。
AI 编码助手在打开仓库时会读取代码、配置、脚本和专属指令文件。
如果仓库包含恶意配置或脚本,助手会在执行常规 Git 操作(如
git status、git diff)时触发攻击,甚至通过提示注入泄露环境变量或执行不受信任的命令。主要威胁
- Git 配置攻击:如core.fsmonitor指向恶意程序,导致助手执行攻击代码。
- 提示注入:仓库中的指令文件可直接影响助手行为,可能绕过安全规则并泄露凭证。
- 权限滥用:助手往往拥有终端、浏览器、凭证等多重权限,若被攻击可造成大范围破坏。
防护建议
1. 先审查再信任:打开未知仓库前检查.git/config、脚本、AI 指令目录等。
2. 最小权限原则:限制助手访问生产凭证、云账号、SSH 密钥等。
3. 沙箱执行:对不熟悉的项目使用容器或临时 VM,降低风险。
4. 预览并审查技能:GitHub 等平台的 AI 技能需先预览,确认无恶意脚本。
5. 隔离敏感变量:确保助手不必访问AWS_SECRET_KEY、GITHUB_TOKEN等敏感环境变量。
结语
AI 编码助手是强大工具,但其对仓库的深度访问也带来了新的安全边界。开发者需像对待任何特权系统一样,对仓库、助手指令和凭证进行严格审查与隔离。

多租户 Node.js 应用:请求上下文演变为基础设施
在多租户 Node.js 应用中,最初只需从请求头读取
核心问题
结论
当多租户应用需要在业务层、事务、日志、监控等多处共享执行状态时,单纯的请求上下文已不足以满足需求。通过
在多租户 Node.js 应用中,最初只需从请求头读取
tenantId 并传递给服务即可。随着业务增长,tenantId、requestId、数据库选择、事务会话、日志元数据、调试状态等信息也会随请求携带。此时,单纯把这些值作为函数参数传递已无法满足需求,应用层需要手动维护并传递所有上下文信息,导致错误频发且难以维护。核心问题
- 执行状态传播:手动传递tenantId、事务会话等会导致遗漏或错误。
- 职责混乱:业务逻辑与基础设施(数据库路由、事务、日志)交织在一起。
- 可维护性差:每个层级都需关注同一组上下文,代码冗长且易错。
解决方案
Node.js 提供AsyncLocalStorage,可在异步调用链中存储共享状态。通过在请求边界(或任何执行边界)调用runWithContext,将tenantId、requestId、事务会话等放入共享上下文,后续所有业务代码可通过getContext()读取,无需显式传递。
优势
- 职责分离:业务层只关注业务逻辑,基础设施层负责租户解析、数据库路由、事务管理等。
- 事务统一:在事务边界设置会话后,所有模型操作自动使用同一事务,无需手动传递。
- 日志与监控统一:上下文中的requestId、tenantId自动附加到所有日志与指标,便于追踪与分析。
- 灵活扩展:同一机制可用于 HTTP 请求、队列任务、CLI 命令等多种执行源。
实践示例
```js
const storage = new AsyncLocalStorage();
function runWithContext(context, fn) {
return storage.run(context, fn);
}
function getContext() {
return storage.getStore();
}
// HTTP 中间件
app.use(async (req, res, next) => {
const tenantId = req.header('x-tenant-id');
if (!tenantId) return res.status(400).json({ error: 'Tenant is required.' });
const requestId = crypto.randomUUID();
await runWithContext({ tenantId, requestId }, async () => next());
});
```
结论
当多租户应用需要在业务层、事务、日志、监控等多处共享执行状态时,单纯的请求上下文已不足以满足需求。通过
AsyncLocalStorage 等执行上下文机制,将这些状态提升为运行时基础设施,既简化了代码,又提升了系统的一致性与可维护性。AI 生成警报规则,人工把关不让误触
在 Taabi Mobility 的 taabi Nexus 平台中,驾驶员的行车记录仪会触发多种警报(疲劳、手机使用、座椅安全带、急刹车等)。管理者只需用一句英文描述想要的动作,系统会把这句话翻译成 JSON 规则并执行。规则示例:在 60 km/h 以上行驶时,若同一车在 10 分钟内出现两次疲劳警报,先通知经理;若 10 分钟后仍未解除疲劳,则拨打司机电话。
如果你也在构建自然语言规则或带人工审核的代理,欢迎交流你如何放置“切换”点。
在 Taabi Mobility 的 taabi Nexus 平台中,驾驶员的行车记录仪会触发多种警报(疲劳、手机使用、座椅安全带、急刹车等)。管理者只需用一句英文描述想要的动作,系统会把这句话翻译成 JSON 规则并执行。规则示例:在 60 km/h 以上行驶时,若同一车在 10 分钟内出现两次疲劳警报,先通知经理;若 10 分钟后仍未解除疲劳,则拨打司机电话。
规则通过 Pydantic v2 定义,生成 JSON Schema 与 TypeScript 类型,保证 UI、模拟器、评测等所有组件使用同一结构。
关键流程
- 写规则:管理者输入一句话,LangGraph 先检查阈值与通道是否完整,若缺失则中断并提示。
- 验证与回放:规则通过约 30 条语义检查后,在过去 7 天的历史数据上回放,返回“会触发 27 次,58 次被节流”。
- 审批与激活:审批仅保存草稿,激活需手动点击按钮,模型无法直接触发。
- 调用与跟进:拨打电话由通知器排队,模型不直接发起,所有后续跟进需人工关闭。
技术要点
- Postgres 16 + RLS,tenant_id 通过 JWT 强制,防止跨租户访问。
- Kafka 处理规则更新,aiokafka 读取压缩主题,重启后可从 Kafka 重新构建规则。
- 监控:Grafana、Prometheus、OpenTelemetry 追踪每条警报,p99 94 ms,99.9 % 无死信。
- 语言与框架:Python 3.12、FastAPI、React 18、Playwright、Docker Compose。
经验教训
- 规则阈值与通道必须在摘要中明确,避免“每小时最多一次”误解。
- 现场电话决策需避免全流程代理,单次 API 调用可在 1.2 s 内完成。
- 语音识别对司机说话不稳定,建议多轮确认并在通话后重新检查警报流。
如果你也在构建自然语言规则或带人工审核的代理,欢迎交流你如何放置“切换”点。
**Cloudflare 部署项目的静默失效问题
开发者部署了三个新的区块链工具端点,想检查使用情况,却发现统计端点本身已经崩溃。
问题出在生产环境中
修复绑定后,统计端点恢复,查到三周内已有 4852 次真实 API 调用,同时还发现所有端点的限流全程无效,因为它也采用了相同的静默降级策略。
接着检查反馈表单,又发现两处问题:反馈数据库是几周前创建的 D1 实例,但从未创建反馈表,所有提交都被静默丢弃,只有一条 8 月中旬的反馈留存下来;CSP 头部禁止了 challenges.cloudflare.com 加载,导致反机器人小部件一直被自身安全策略拦截;修复 CSP 后又发现密钥不匹配,复制时两次选错字段。
四个不同问题都有相同的失效模式:因为设计成“故障开放”,缺失绑定不会崩溃,只会静默失效,不主动检查根本发现不了。
故障开放对用户体验来说是正确设计,缺失分析绑定不应该影响正常流量的限流,但这意味着需要单独的定时检查来主动告警绑定缺失,而不是靠人工手动调用端点发现问题。
开发者目前还没有实现这样的检查,下一步计划补充,同时提问:如果在 Cloudflare Workers/Pages 上使用 KV 或 D1 绑定,大家都是怎么验证生产环境绑定正确的?有没有现成的标准方案?
开发者部署了三个新的区块链工具端点,想检查使用情况,却发现统计端点本身已经崩溃。
问题出在生产环境中
env.PRESEND_ANALYTICS 未定义,KV 命名空间存在但从未绑定到 Pages 项目,因为 wrangler.toml 配置覆盖了仪表盘 UI 设置。修复绑定后,统计端点恢复,查到三周内已有 4852 次真实 API 调用,同时还发现所有端点的限流全程无效,因为它也采用了相同的静默降级策略。
接着检查反馈表单,又发现两处问题:反馈数据库是几周前创建的 D1 实例,但从未创建反馈表,所有提交都被静默丢弃,只有一条 8 月中旬的反馈留存下来;CSP 头部禁止了 challenges.cloudflare.com 加载,导致反机器人小部件一直被自身安全策略拦截;修复 CSP 后又发现密钥不匹配,复制时两次选错字段。
四个不同问题都有相同的失效模式:因为设计成“故障开放”,缺失绑定不会崩溃,只会静默失效,不主动检查根本发现不了。
故障开放对用户体验来说是正确设计,缺失分析绑定不应该影响正常流量的限流,但这意味着需要单独的定时检查来主动告警绑定缺失,而不是靠人工手动调用端点发现问题。
开发者目前还没有实现这样的检查,下一步计划补充,同时提问:如果在 Cloudflare Workers/Pages 上使用 KV 或 D1 绑定,大家都是怎么验证生产环境绑定正确的?有没有现成的标准方案?

构建自动生成TikTok内容的机器人
这是一个全自动化流程,可自动抓取 Reddit 热门帖子,生成语音旁白,拼接音频和截图导出为视频,最后发布到 TikTok,全程无需人工干预。
预计整体搭建时间为 4-6 小时,包含测试和账号绑定。
这个流程是模块化的,可以替换不同的 TTS、编辑器或内容来源,控制好调用频率和成本,就可以持续自动产出内容。
这是一个全自动化流程,可自动抓取 Reddit 热门帖子,生成语音旁白,拼接音频和截图导出为视频,最后发布到 TikTok,全程无需人工干预。
预计整体搭建时间为 4-6 小时,包含测试和账号绑定。
用到的工具及各自作用:
• Reddit API(OAuth):免费额度,获取热门帖子
• Python 3.11+:免费开源,编排工作流
• ElevenLabs TTS API:免费试用额度,生成语音旁白
• CapCut Desktop (Windows):免费额度,视频剪辑导出
• TikTok API(第三方服务或手动上传):免费额度,发布最终视频
• n8n(可选):社区版自托管免费,或使用云方案,可视化编排和webhook触发
• GitHub:免费额度,版本控制
该流程共分为 10 步搭建:
1. 在 Reddit 创建脚本类型应用,获取 OAuth 所需的凭证。
2. 创建 Python 虚拟环境,安装依赖包:requests、python-dotenv、elevenlabs-sdk。
3. 在项目根目录创建 .env 文件存储密钥信息,避免凭证出现在源代码中。
4. 通过 Reddit API 认证后,拉取当日点赞最高的 5 篇帖子。
5. 清洗文本内容,去除链接和 Markdown,限制长度,转为短视频脚本。
6. 调用 ElevenLabs TTS 接口生成音频,保存为 MP3 文件。
7. 通过 puppeteer 调用无头 Chrome 对帖子网页截图,保存为图片文件。
8. 使用 CapCut 通过 JSON 项目文件拼接图片和音频,导出为适配 TikTok 的 MP4 视频。
9. 通过 n8n webhook 接收视频路径,调用第三方服务上传到 TikTok。
10. 将步骤 4 到 9 封装为 main 函数,通过定时任务每 4 小时执行一次,保证持续产出新内容。
常见故障及解决方法:
• Reddit OAuth 令牌过期(1小时),返回 401:每次运行刷新令牌,或使用新版 OAuth2 流程存储长时效刷新令牌。
• ElevenLabs 配额超限,返回 429 或空音频:通过 ElevenLabs 面板监控用量,添加指数退避,超限后切换到其他低价 TTS。
• CapCut CLI 在处理大图时卡住,没有输出 MP4:导入前将截图调整为 1080×1920,限制图片时长不超过 5 秒。
• 第三方上传工具拒绝文件,返回 HTTP 400:确保 MP4 使用 H.264 视频和 AAC 音频编码,可通过 ffmpeg 重新编码。
• n8n webhook 无法访问:将 n8n 部署到静态 IP 后,开发阶段可使用 ngrok 等隧道服务,添加健康检查告警。
• 产生意外账单:在脚本中设置每日生成视频数量上限,记录使用情况方便审计。
这个流程是模块化的,可以替换不同的 TTS、编辑器或内容来源,控制好调用频率和成本,就可以持续自动产出内容。