
PostgreSQL 19 新增计划建议与缓存插件
PostgreSQL 19 引入了 pg_plan_advice 与 pg_stash_advice 两个 contrib 模块,帮助开发者在查询计划变更后快速恢复旧计划。
- pg_plan_advice:可将查询计划导出为文本字符串,并在后续执行时强制使用该计划。
- pg_stash_advice:按查询 ID 存储这些字符串,并在查询执行时自动应用,支持跨会话持久化。
🔗 原文:postgr.es/p/9uC
PostgreSQL 19 引入了 pg_plan_advice 与 pg_stash_advice 两个 contrib 模块,帮助开发者在查询计划变更后快速恢复旧计划。
- pg_plan_advice:可将查询计划导出为文本字符串,并在后续执行时强制使用该计划。
- pg_stash_advice:按查询 ID 存储这些字符串,并在查询执行时自动应用,支持跨会话持久化。
使用方式简洁:
1. 在postgresql.conf中分别加入
```conf
session_preload_libraries = 'pg_plan_advice'
shared_preload_libraries = 'pg_stash_advice'
```
2. 对需要固定的查询执行
```sql
EXPLAIN (COSTS OFF, PLAN_ADVICE) SELECT …;
```
结果会在Generated Plan Advice块中给出四行建议,描述 join 顺序、join 方法、扫描方式和并行性。
3. 若想自动化恢复旧计划,只需CREATE EXTENSION pg_stash_advice;,插件会根据查询 ID 自动匹配并强制使用保存的计划。
此功能适用于任何需要在统计变化或版本升级后保持查询性能的场景,尤其在 PostgreSQL 16 与 19 之间进行升级前的计划对比时极为有用。
GitHub: GitHub
GitHub: GitHub
🔗 原文:postgr.es/p/9uC

SetrixDB:Go 编写的精确集合引擎
SetrixDB 是一个可嵌入的 Go 集合引擎,针对 uint64 ID 提供精确的成员判断与集合交集运算,核心思路是把集合当作位图、把交集当作 AND 操作。它面向电商筛选、权限检查、反欺诈、RAG 候选预过滤这类场景,数据本身留在原数据库,SetrixDB 作为索引或预过滤器旁路运行。
项目从零实现了最小完美哈希函数(CHD v2)做键生成,在 5000 万键上零冲突,约 4.03 bits/key,查找约 118 ns。位图 AND 内核通过 cgo 走 AVX-512,带运行时指令检测与标量回退,同一二进制可在任意 CPU 上运行。支持分片与集群模式,节点增删只重映射约 1/(N+1) 的 ID。
作者也明确列出了劣势:宇宙空间稀疏或超出内存时不如 Roaring;不支持范围查询、相似度与 join;MPHF 面向静态集合,频繁增删需要重建。当前为 v0.1.0 alpha,已在回环与双机间测试,3 节点集群在云端跑过但未经历多数据中心生产环境。
项目开源,Apache-2.0 许可,代码与可复现基准见 GitHub:GitHub
🔗 原文:点击查看
SetrixDB 是一个可嵌入的 Go 集合引擎,针对 uint64 ID 提供精确的成员判断与集合交集运算,核心思路是把集合当作位图、把交集当作 AND 操作。它面向电商筛选、权限检查、反欺诈、RAG 候选预过滤这类场景,数据本身留在原数据库,SetrixDB 作为索引或预过滤器旁路运行。
项目从零实现了最小完美哈希函数(CHD v2)做键生成,在 5000 万键上零冲突,约 4.03 bits/key,查找约 118 ns。位图 AND 内核通过 cgo 走 AVX-512,带运行时指令检测与标量回退,同一二进制可在任意 CPU 上运行。支持分片与集群模式,节点增删只重映射约 1/(N+1) 的 ID。
实测数据(2 vCPU AMD EPYC Zen4,AVX-512,Go 1.22,2026 年 9 月):
成员判断(100 万键):SetrixDB 结构占用 0.5 B/key,约 118 ns/次;Go map 为 22.3 B/key、133.3M ops/s;Bloom filter 1.2 B/key、23.6M ops/s,但有 1% 误报。
交集(A=B=100 万):AVX-512 位图 AND 6 µs,纯 Go 位图 29 µs,Roaring 148 µs(稠密 ID)/523 ms(随机 64 位 ID),排序归并 9.2 ms,hash join 91.6 ms。
真实数据集验证:Online Retail II 上 "UK AND Q4/2011 AND price ≥ 5" 返回 22,701 行、823 µs;Wikipedia 标题(1926 万条)上 "multi-word AND starts with s" 返回 1,408,399 条、9.5 ms;MovieLens 25M 上三组查询结果均与外部 sort+comm 校验一致。
同一 25M ID 宇宙、千万级集合上,排序列表归并 87.7 MB/80.4 ms,稠密位图(AVX-512)2 MB/227 µs,约快 350 倍、小 43 倍。
作者也明确列出了劣势:宇宙空间稀疏或超出内存时不如 Roaring;不支持范围查询、相似度与 join;MPHF 面向静态集合,频繁增删需要重建。当前为 v0.1.0 alpha,已在回环与双机间测试,3 节点集群在云端跑过但未经历多数据中心生产环境。
项目开源,Apache-2.0 许可,代码与可复现基准见 GitHub:GitHub
🔗 原文:点击查看

Google Doc 导入 Confluence Cloud 实操指南
Confluence Cloud 可以直接导入 Google Doc,无需下载转换再上传。在创建页面时,点 Share 旁的 More actions,选 Templates and import,打开 Import 标签,选 Google Doc 并授权账号,文档就会变成 Confluence 页面。短文档到此就结束了,麻烦出在共享盘、图片和长文档上。
对会议记录这类短文档,内置导入免费且够用;结构化长文档才需要额外方案。导入前先确认文档类型和规模,避免迁移后才发现问题。
🔗 原文:点击查看
Confluence Cloud 可以直接导入 Google Doc,无需下载转换再上传。在创建页面时,点 Share 旁的 More actions,选 Templates and import,打开 Import 标签,选 Google Doc 并授权账号,文档就会变成 Confluence 页面。短文档到此就结束了,麻烦出在共享盘、图片和长文档上。
导入入口只在创建页面时出现,编辑已有页面时找不到导入按钮,这是最常见的误解。支持 Word、Google Doc、OneDrive 文档,可一次导入多个文件。Atlassian 明确说明单文件与批量导入的要求不同,且因文档类型而异,迁移前最好用自己的文件测试。
内置导入的优点是直接与 Google 通信,文件不经过本地。正文、列表和多数表格能保留可用状态。但共享盘文档通常选不到,文件在个人 Drive 列表里不出现,Confluence 端没有设置可修复。图片多数正常,偶尔会变成占位符,删除源文件前务必检查导入后的页面。文档标题会成为页面标题,原有标题层级整体上移一级。Word 中的形状会被替换为占位符,图内绘制的图表不会保留。
遇到共享盘文件导入失败,标准绕行方案是在 Google Docs 里下载为 .docx,再通过同一导入入口作为 Word 文档导入,仅接受 .docx 扩展名。这也让你在导入前能编辑文件。
每个文件导入后成为单个页面。几十页的手册会变成一页无限滚动,没有分节导航,目录只是单页上的锚点列表。Data Center 版支持按标题层级拆成多页,Cloud 没有这个选项。手动拆分每节约需 6-8 分钟,25 节的手册约三小时,且下次修订还要重来。
长文档两条路:先在 Word 或 Docs 里按目标页面拆成多个文件再批量导入,繁琐但免费且结果可预期;或使用导入时自动拆分的应用,仅当这种情况频繁发生才值得。导入是一次性转换,之后 Google 与 Confluence 互不同步,需要保持原文档活跃时用 Google Drive 宏嵌入而非导入。PDF 不能作为页面内容导入,只能作为附件挂载。
对会议记录这类短文档,内置导入免费且够用;结构化长文档才需要额外方案。导入前先确认文档类型和规模,避免迁移后才发现问题。
🔗 原文:点击查看
Postgres扩展SBOM设计推倒重来
作者在CloudNativePG扩展容器项目中用AI Agent辅助构建SBOM(软件物料清单),一周后发现PGRX与上游的验证命令完全不同,用户验证安全与来源信息需要两套操作,过于混乱。于是放弃原设计,改用Docker自定义SBOM生成器方案重写。
🔗 原文:postgr.es/p/9uE
作者在CloudNativePG扩展容器项目中用AI Agent辅助构建SBOM(软件物料清单),一周后发现PGRX与上游的验证命令完全不同,用户验证安全与来源信息需要两套操作,过于混乱。于是放弃原设计,改用Docker自定义SBOM生成器方案重写。
重构后大部分逻辑集中在自定义的sbom-generator模块中,构建管线改动很小。作者也指出AI无法替他判断正确设计,仍需人来定义目标与优先级。
目前CNPG-Extensions项目已开放测试,Renovate全自动更新,新扩展版本会自动同步到镜像目录,支持PG-Cron、PG-Partman、PG-Hint-Plan、PG-Stat-KCache、PGSentinel、PLDebugger、PLProfiler及MySQL/MSSQL FDW等扩展。
GitHub
GitHub
🔗 原文:postgr.es/p/9uE

Enlace:浏览器端零信任 OpenAPI 调用链引擎
多步骤 API 调用一直是痛点:Swagger UI 的 Try it out 只适合单次请求,一旦要「建资源→取 id→调后续接口」,就得转投 Postman 环境变量、临时脚本或逐渐偏离 OpenAPI 规范的 collection。Enlace 的思路是去掉这层脚本:不写脚本、不建环境文件、没有服务端执行组件,直接把 OpenAPI 文档当画布,把响应字段接到后续请求参数上,整条链在浏览器里直连你的 API 运行。
Enlace 目前是 0.0.9 早期 beta,适配器覆盖 FastAPI、Express、NestJS、ASP.NET Core 和 Spring Boot。信任模型与 Swagger UI 的 Try it out 一致,只是从单次调用扩展到了整条链。
GitHub
🔗 原文:点击查看
多步骤 API 调用一直是痛点:Swagger UI 的 Try it out 只适合单次请求,一旦要「建资源→取 id→调后续接口」,就得转投 Postman 环境变量、临时脚本或逐渐偏离 OpenAPI 规范的 collection。Enlace 的思路是去掉这层脚本:不写脚本、不建环境文件、没有服务端执行组件,直接把 OpenAPI 文档当画布,把响应字段接到后续请求参数上,整条链在浏览器里直连你的 API 运行。
快速开始:适配器只做两件事——托管 UI 和托管 OpenAPI 文档。多数框架已能生成该文档(FastAPI 内置、@nestjs/swagger、swagger-jsdoc、Swashbuckle、springdoc 等),直接把这个对象交给 Enlace 即可,无需额外维护 openapi.json。FastAPI 用 pip install enlace-fastapi,注册路由后调用 app.openapi() 传入;NestJS 用 npm install @get-enlace/nest,通过 EnlaceModule.setSpec 传入 SwaggerModule.createDocument 的结果;Express 用 npm install @get-enlace/express,把 swagger-jsdoc 生成的 spec 传给 enlace({ spec })。ASP.NET Core 和 Spring Boot 适配器也已可用。现有 /docs、/redoc 不受影响。
画布上拖入端点、填写参数,用 JSONPath 把上一个响应的字段映射到下一个请求,带自动补全。独立分支并发执行,依赖步骤自动等待。
调试:双击连接线布设断点,用 Debug 模式暂停执行、在请求发出前检查;Run 模式会忽略断点,可保留断点做完整运行。失败重跑:链路中途失败时,Rerun failed 只重跑未完成部分,复用已成功结果;Debug failed 同样断点续跑。自动保存:浏览器记住上次会话的画布布局与状态,刷新不丢。导出导入:可导出 .enlace 文件,部分导出保留凭据结构但剥离密钥,完整凭据导出始终密码加密。
并发执行不依赖调度服务:Enlace 遍历依赖图,把就绪节点分组,在浏览器内逐层并发运行,无 worker、无队列、无外部调度器。
全程无代理:浏览器与适配器之间只传 UI 资源和 OpenAPI 文档,实际执行请求直连你的 API。适配器不代理流量,粘贴的 bearer token 只存在于该标签页的浏览器内存中,不进适配器日志、不落盘、不经过第三方。
Enlace 目前是 0.0.9 早期 beta,适配器覆盖 FastAPI、Express、NestJS、ASP.NET Core 和 Spring Boot。信任模型与 Swagger UI 的 Try it out 一致,只是从单次调用扩展到了整条链。
GitHub
🔗 原文:点击查看

停止使用 Zapier 连接 Contact Form 7 与 CRM
Contact Form 7(CF7)提交到 CRM 的常见做法是通过 Zapier。Zapier 方便、易上手,但按任务计费,成本随提交量激增。对单一 CF7‑CRM 连接,直接 API 集成可完全替代,且一次性插件费用在首月即可收回。
🔗 原文:点击查看
Contact Form 7(CF7)提交到 CRM 的常见做法是通过 Zapier。Zapier 方便、易上手,但按任务计费,成本随提交量激增。对单一 CF7‑CRM 连接,直接 API 集成可完全替代,且一次性插件费用在首月即可收回。
- 成本对比
- Zapier Starter:$19.99/月,750 任务;已超限。
- Zapier Professional:$49.99/月,2,000 任务;每月 1,000 次提交、两目标需 2,000 任务,年费 $599.88。
- Contact Form to API:免费版支持 5 个 API 连接;Pro 版一次性付费,插件在首月即可自付。
- 何时仍需 Zapier
- 复杂条件路由:不同字段值指向不同 CRM 或管道。
- 非 REST API 的工具:Google Calendar、Notion 等。
- 延时工作流:如 24 小时后发送跟进邮件。
- 已在其他自动化中使用 Zapier,且任务余量充足。
- 何时直接集成
- 仅将 CF7 提交发送至一至两 API 端点。
- 关注 GDPR:数据不离开 WordPress 服务器,避免第三方处理。
- 简化依赖:单点失败,日志集中在自己的服务器。
- 示例:CF7 → HubSpot
```
POST
Headers: Authorization: Bearer YOUR_PRIVATE_APP_TOKEN
Content-Type: application/json
Body:
{
"properties": {
"email": "[your-email]",
"firstname": "[your-name]",
"phone": "[your-phone]",
"hs_lead_status": "NEW",
"lifecyclestage": "lead"
}
}
```
只需在 WordPress 服务器上直接 POST,无 Zapier 账户、Webhook 或任务计数。
- 总结
对于大多数 CF7‑CRM 场景,直接 API 集成既省钱又合规。仅在需要高级路由、非 API 工具或延时逻辑时才保留 Zapier。
🔗 GitHub
🔗 PyPI
🔗 原文:点击查看
pg_migrate 1.0 发布:离线目录迁移 Oracle
PostgreSQL Migrator(CLI 名为 pg_migrate)1.0 稳定版于 9 月 4 日发布。这是 Dalibo 团队自 2024 年起与 Ora2Pg 作者合作开发的 Oracle 到 PostgreSQL 迁移工具,目标是超越其前身 Ora2Pg。
🔗 原文:postgr.es/p/9uH
PostgreSQL Migrator(CLI 名为 pg_migrate)1.0 稳定版于 9 月 4 日发布。这是 Dalibo 团队自 2024 年起与 Ora2Pg 作者合作开发的 Oracle 到 PostgreSQL 迁移工具,目标是超越其前身 Ora2Pg。
本次重点介绍离线目录(offline catalog)功能。传统上 Ora2Pg 每次运行都要重新连接 Oracle 读取系统视图,目录不跨运行持久化。pg_migrate 在首次检查时把远程目录序列化为 JSON 文件(Source.json),存放在 .pg_migrate 目录,之后可离线查询,无需重连 Oracle 实例。
离线目录衍生出多项能力:转换阶段把 Source.json 转为 Target.json 并应用通用与特定转换规则;审计阶段遍历每个节点打分并标注转换陷阱;SPA 网页界面可浏览源与目标模型;dump 命令可输出 Target.json 中对象的 DDL。
路线图方面,团队计划今年秋季开始下一阶段:过程化代码转换。工具用 Go 编写,1.0 使用 sonic 库做序列化。
🔗 原文:postgr.es/p/9uH
浏览器里的动效设计工作室 AtomCut
AtomCut 最初只是用来做文字动画的工具,如今已发展成浏览器端的无限画布加多轨时间线:可对任意元素打关键帧、用水彩笔刷绘制、跟踪运动、添加跟随语音的字幕,并导出 MP4、GIF、SVG 或 Lottie。免费、无需账号、支持离线使用。
作者分享了背后的架构思路:描述动画内容的部分放在不含 DOM 和 React 的纯包中,展示与编辑逻辑放在应用层。项目是单个 JSON 文档,用 zod 校验并带版本号,当前 schema 版本 71,所有迁移仍可运行,早期项目也能打开。渲染帧是纯函数,播放、拖动、MP4/PNG 序列/Lottie 导出都调用同一函数,不存在预览与导出渲染器分叉的问题。撤销基于补丁而非快照,成本与改动大小成正比。
局限在于浏览器渲染难以胜任两小时 4K 时间线,重度素材仍不如原生剪辑软件。免费版导出上限 720p,一次性付费 29 美元解除限制,非订阅制。后续计划包括实时协作、可操作时间线的编辑器内助手,以及开放插件 SDK。无需注册,打开 app.atomcut.net 即可使用。
🔗 原文:点击查看
AtomCut 最初只是用来做文字动画的工具,如今已发展成浏览器端的无限画布加多轨时间线:可对任意元素打关键帧、用水彩笔刷绘制、跟踪运动、添加跟随语音的字幕,并导出 MP4、GIF、SVG 或 Lottie。免费、无需账号、支持离线使用。
作者分享了背后的架构思路:描述动画内容的部分放在不含 DOM 和 React 的纯包中,展示与编辑逻辑放在应用层。项目是单个 JSON 文档,用 zod 校验并带版本号,当前 schema 版本 71,所有迁移仍可运行,早期项目也能打开。渲染帧是纯函数,播放、拖动、MP4/PNG 序列/Lottie 导出都调用同一函数,不存在预览与导出渲染器分叉的问题。撤销基于补丁而非快照,成本与改动大小成正比。
真正难的不是 36 种图层特效——特效本质是着色器加设置卡片,关键帧引擎已能驱动任意数量。难点在于两类正确事实互相冲突的场景:
裁剪视频时窗口与内部画面都可移动,若存成单一变换加四个内边距,关键帧间的重取景会明显漂移。修复方案是窗口与内容各用一套变换,内容变换不读取裁剪值。
镜像图层本质是负缩放。作者曾用 flipX 标志,标志加符号两个字段描述同一事实,跨翻转插值时互相矛盾,删除标志后相关 bug 一并消失。
帧率是网格而非时间。项目没有全局 fps,每个合成自带帧率,只做量化:标尺刻度、方向键步进、导出迭代都基于它。60 fps 合成里的 12 fps 翻页书每格停留 83.33 ms,无重采样就不会漂移。
每次改动须先在公开 changelog 写一行「用户现在能做什么以前做不到的事」,写不出就不发布。约一半已开始的改动因此被砍掉。
局限在于浏览器渲染难以胜任两小时 4K 时间线,重度素材仍不如原生剪辑软件。免费版导出上限 720p,一次性付费 29 美元解除限制,非订阅制。后续计划包括实时协作、可操作时间线的编辑器内助手,以及开放插件 SDK。无需注册,打开 app.atomcut.net 即可使用。
🔗 原文:点击查看
Go 爬虫 Cinder 更名 Tomoshibi 灯火
Go 爬虫工具 Cinder 正式更名为 Tomoshibi(灯火)。同名 API、同名爬虫,只是换了名字,旧 GitHub 链接自动重定向,star 数保留。
自托管、无按 token 计费,单二进制、低内存占用。后续路线图不变,继续改进 SPA 启发式与测试。
GitHub: GitHub
npm: npm
🔗 原文:点击查看
Go 爬虫工具 Cinder 正式更名为 Tomoshibi(灯火)。同名 API、同名爬虫,只是换了名字,旧 GitHub 链接自动重定向,star 数保留。
改名原因:原名难搜索,且与大量其他项目撞名。新名取自日语「灯火」,寓意把杂乱 HTML 转成 LLM 可读的干净 markdown。
结构变化:原先分散的 cinder、cinder-tmcp、cinder-sv 三个仓库合并为单一 monorepo,包含 Go API(Gin + Colly + Chromedp + SearXNG)、MCP 服务器(3 个工具,npm 包 tomoshi)和 Svelte 5 网页 playground。
无破坏性变更:/v1/scrape、/v1/crawl、/v1/search、/v1/map 接口不变;旧 CINDER_API_URL 环境变量仍作为回退读取;旧 Docker 标签暂时仍可拉取。
迁移:Docker Compose 一条命令起全套(api 7431 + mcp 7433 + web 7432 + redis 7434 + searxng 7435);MCP 配置改用 npx -y tomoshi;Go import 路径改为 github.com/Michael-Obele/tomoshibi。
性能基准不变:search-bench.py(10 workers/30s)约 560 req/s,p50 11ms。
自托管、无按 token 计费,单二进制、低内存占用。后续路线图不变,继续改进 SPA 启发式与测试。
GitHub: GitHub
npm: npm
🔗 原文:点击查看
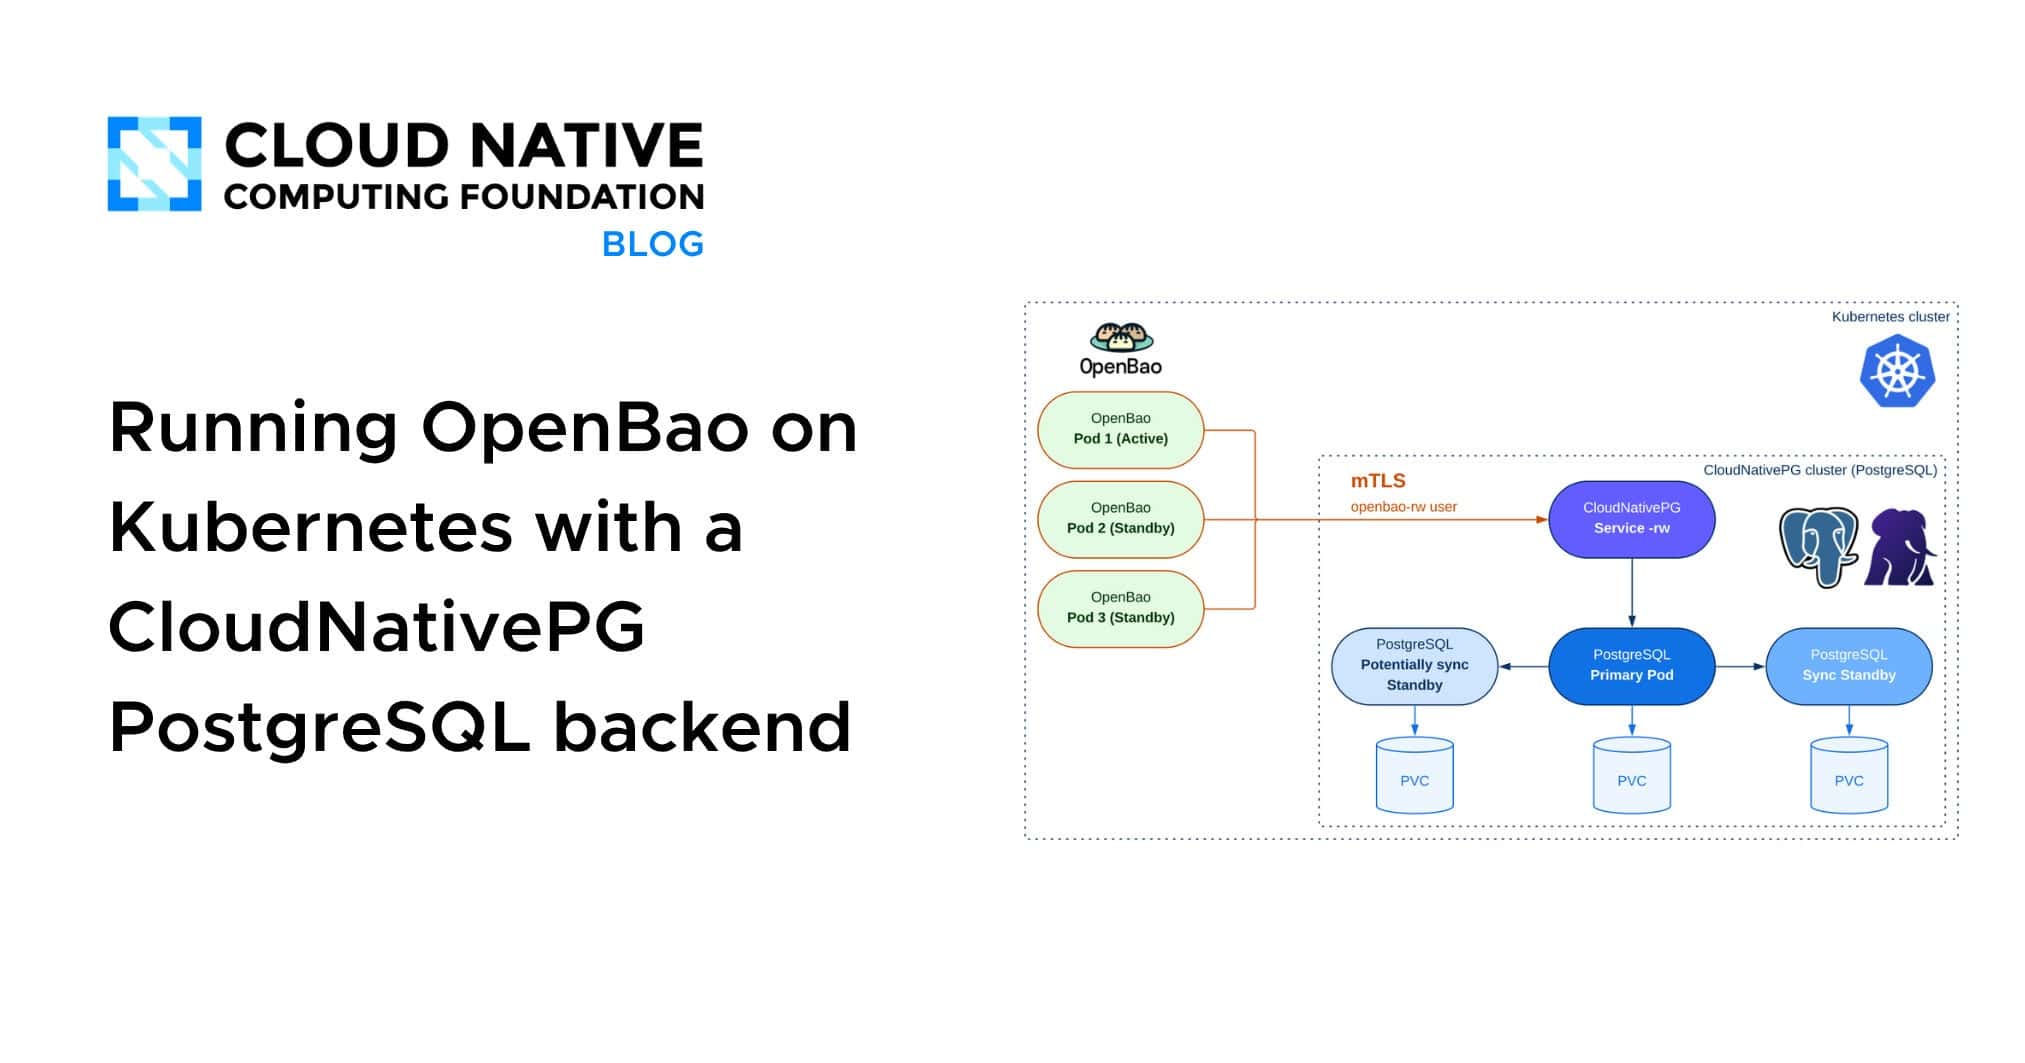
OpenBao + CloudNativePG:K8s 原生密钥管理全栈
OpenBao(HashiCorp Vault 的 Linux Foundation 开源分支)与 CloudNativePG(CNCF Sandbox 项目)组合,提供完全开源、无云依赖的密钥管理解决方案。通过 PostgreSQL 作为后端存储,CNPG 的三节点同步复制实现零数据丢失,OpenBao 的 mTLS 认证与 pg_hba 规则确保无密码安全。
1. 部署流程
- 使用 cnpg-playground 快速创建 Kind 集群。
- 部署 CloudNativePG、cert‑manager、Barman Cloud 插件,创建三节点 CNPG 集群。
- 通过 DatabaseRole CRD 为 OpenBao 生成 TLS 证书,配置 pg_hba 只允许证书认证。
2. 初始化与安全
- 运行一次性 Job 创建 OpenBao 所需的两张表(openbao_kv_store、openbao_ha_locks)。
- 通过 Job 重新授权,限制 PUBLIC 访问,仅授予 openbao‑rw 角色必要权限。
3. OpenBao 部署
- 使用官方 Helm chart,挂载证书与 CA,禁用本地持久化。
- 配置 anti‑affinity 与 tolerations,确保 OpenBao 与 PostgreSQL 节点分离。
4. 验证
- 初始化并逐个 unseal OpenBao 实例。
- 通过 OpenBao CLI 写入、读取 KV,确认数据已加密存储在 PostgreSQL。
5. 运维提示
- CNPG 证书 90 天有效,自动续期;OpenBao 需滚动重启以加载新证书。
- 可通过 Barman Cloud 插件实现 WAL 归档与定时备份,支持点时间恢复。
🔗 原文:点击查看
OpenBao(HashiCorp Vault 的 Linux Foundation 开源分支)与 CloudNativePG(CNCF Sandbox 项目)组合,提供完全开源、无云依赖的密钥管理解决方案。通过 PostgreSQL 作为后端存储,CNPG 的三节点同步复制实现零数据丢失,OpenBao 的 mTLS 认证与 pg_hba 规则确保无密码安全。
1. 部署流程
- 使用 cnpg-playground 快速创建 Kind 集群。
- 部署 CloudNativePG、cert‑manager、Barman Cloud 插件,创建三节点 CNPG 集群。
- 通过 DatabaseRole CRD 为 OpenBao 生成 TLS 证书,配置 pg_hba 只允许证书认证。
2. 初始化与安全
- 运行一次性 Job 创建 OpenBao 所需的两张表(openbao_kv_store、openbao_ha_locks)。
- 通过 Job 重新授权,限制 PUBLIC 访问,仅授予 openbao‑rw 角色必要权限。
3. OpenBao 部署
- 使用官方 Helm chart,挂载证书与 CA,禁用本地持久化。
- 配置 anti‑affinity 与 tolerations,确保 OpenBao 与 PostgreSQL 节点分离。
4. 验证
- 初始化并逐个 unseal OpenBao 实例。
- 通过 OpenBao CLI 写入、读取 KV,确认数据已加密存储在 PostgreSQL。
5. 运维提示
- CNPG 证书 90 天有效,自动续期;OpenBao 需滚动重启以加载新证书。
- 可通过 Barman Cloud 插件实现 WAL 归档与定时备份,支持点时间恢复。
GitHub: GitHub
Helm repo:
🔗 原文:点击查看
Kubernetes v1.37 新增容器存储硬化功能
Kubernetes v1.37 引入了 emptyDir 权限模式 与 bind‑mount 选项,让开发者能在容器内直接控制可写卷的执行与删除权限。
- noexec / nosuid / nodev:防止在可写卷中下载、chmod + x 并执行恶意二进制,提升工作负载安全。
- mode 01777:为共享 writable 目录(如 /tmp)设置粘性位,保证同一 Pod 内不同容器只能删除自己的文件。
- 这些特性目前为 Alpha,需在 API Server 与 kubelet 上开启 VolumeBindMountOptions 与 EmptyDirVolumeMode。
典型用例
- CI/CD 多容器 Pod 共享工作区时,使用
- 数据库 Pod 的临时存储可设
- 通过
使用示例
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-bindmount-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
securityContext:
readOnlyRootFilesystem: true
volumeMounts:
- name: temp
mountPath: /tmp
bindMountOptions: [noexec, nosuid]
volumes:
- name: temp
emptyDir: {}
```
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-emptydir-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
volumeMounts:
- name: shared
mountPath: /tmp
volumes:
- name: shared
emptyDir:
mode: 01777
```
验证方法
- 在挂载了
- 在
GitHub: GitHub
GitHub: GitHub
🔗 原文:点击查看
Kubernetes v1.37 引入了 emptyDir 权限模式 与 bind‑mount 选项,让开发者能在容器内直接控制可写卷的执行与删除权限。
- noexec / nosuid / nodev:防止在可写卷中下载、chmod + x 并执行恶意二进制,提升工作负载安全。
- mode 01777:为共享 writable 目录(如 /tmp)设置粘性位,保证同一 Pod 内不同容器只能删除自己的文件。
- 这些特性目前为 Alpha,需在 API Server 与 kubelet 上开启 VolumeBindMountOptions 与 EmptyDirVolumeMode。
典型用例
- CI/CD 多容器 Pod 共享工作区时,使用
mode: 01777 让各容器只能写入自己的文件。- 数据库 Pod 的临时存储可设
mode: 0750,仅限数据库用户访问。- 通过
bindMountOptions: [noexec, nosuid] 防止受损容器在 writable 卷中执行代码。使用示例
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-bindmount-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
securityContext:
readOnlyRootFilesystem: true
volumeMounts:
- name: temp
mountPath: /tmp
bindMountOptions: [noexec, nosuid]
volumes:
- name: temp
emptyDir: {}
```
```yaml
apiVersion: v1
kind: Pod
metadata:
name: hardened-emptydir-pod
spec:
containers:
- name: app
image: alpine:latest
command: ["sleep","3600"]
volumeMounts:
- name: shared
mountPath: /tmp
volumes:
- name: shared
emptyDir:
mode: 01777
```
验证方法
- 在挂载了
noexec 的卷中尝试执行脚本,系统会返回 Permission denied。- 在
mode: 01777 的卷中,非文件所有者无法删除他人文件,返回 Operation not permitted。详细文档请参阅官方 KEP‑5855 与 KEP‑5502。
这些功能适用于 Linux 节点,Windows 节点不受影响。
GitHub: GitHub
GitHub: GitHub
🔗 原文:点击查看
PostgreSQL 逻辑复制 worker 资源管理详解
在 PostgreSQL 10 起,
每个启用的订阅至少占用一个 worker slot,永久占用。若订阅使用
🔗 原文:postgr.es/p/9uK
在 PostgreSQL 10 起,
max_logical_replication_workers 控制逻辑复制的 worker 池大小。默认值为 4,范围 0‑262143。该参数只影响订阅端;发布端使用 max_wal_senders。当 worker 池耗尽时,订阅不会报错,而是停止进度,日志会每 5 秒输出一次警告。每个启用的订阅至少占用一个 worker slot,永久占用。若订阅使用
streaming = parallel,首次大事务后会保留额外的 slot;并且在同步表时会临时占用 max_sync_workers_per_subscription(默认 2)个 slot。整个集群共享 max_worker_processes(默认 8),该值还需为并行查询、扩展等后台工作预留空间。若发现日志中出现 “out of logical replication worker slots”,可通过增大 max_logical_replication_workers 或 max_worker_processes 并重启解决;或者临时禁用不需要的订阅释放 slot。通过调整这些参数,能避免订阅卡住、日志噪声和 WAL 滞留,保持复制链路的稳定与高效。
🔗 原文:postgr.es/p/9uK
PostgreSQL 19 迟发:关键功能被撤回
PostgreSQL 19 计划在 2026 年 9 月 24 日发布 Beta 4,但实际发布时间已推迟数周甚至数月。
主要原因是 beta 期间出现大量功能回退,团队将重点放在质量与时间窗口内的交付上,缩减发布范围。
核心回退概览
结论
PostgreSQL 19 的发布延迟是对质量的坚持。虽然部分预期功能被推迟,但最终版本仍将包含多项性能改进和新特性。
PostgreSQL 19 计划在 2026 年 9 月 24 日发布 Beta 4,但实际发布时间已推迟数周甚至数月。
主要原因是 beta 期间出现大量功能回退,团队将重点放在质量与时间窗口内的交付上,缩减发布范围。
核心回退概览
- SQL/PGQ(属性图查询)
- ALTER TABLE MERGE/SPLIT PARTITION
- UPDATE/DELETE FOR PORTION(时间范围列)
- GROUP BY ALL(ORDER BY 处理错误)
- 默认 TOAST 压缩改为 lz4(构建支持不足)
- pg_dumpall 的非文本输出格式
- JSON_TABLE ON ERROR 级联
- 非易失性约束域的快速默认值
- 逻辑复制数据库特定快照(REPACK 限制)
- pg_stat_statements 的嵌套查询跟踪
- 在线数据校验和
影响与后续
- 53 项回退已在 beta 开始后出现。
- 许多大功能因设计缺陷、错误结果或兼容性问题被撤回,计划在 PostgreSQL 20 重新尝试。
- 仍有部分功能(如 pg_plan_advice、并行 autovacuum、ON CONFLICT DO SELECT、窗口函数 IGNORE NULLS 等)保留。
- AI 工具在发现缺陷和生成可复现测试用例方面发挥作用,导致更多回退。
结论
PostgreSQL 19 的发布延迟是对质量的坚持。虽然部分预期功能被推迟,但最终版本仍将包含多项性能改进和新特性。
突破 DynamoDB 向量搜索 TopK=100 限制
DynamoDB 在 2026 年 8 月正式支持向量数据,但单次查询最多返回 100 条结果,限制了 RAG 方案中“先广泛检索再重排”的实现。
通过把分区键拆成多值(分片)并并行查询,每个分片返回 100 条,再合并排序,可实现等价于 TopK=500 的效果。
- 分片方案:使用
- 查询流程:并行发起 5 次查询 → 合并去重 → 按距离排序。
- 效果:单次查询 500 条候选块,源文档数从 1 增至 10。
- 成本:单查询 112 KB,5 分片 367 KB,月 1 M 次查询成本从 0.24 USD 提升至 0.78 USD。
- 注意:分片数变更需重新导入;并行查询受调用方 CPU 限制,单线程 CPU 低时并行无效。
此方法将分区键从“限制搜索范围”转为“扩展结果数量”,为想用 DynamoDB 进行 RAG、重排且不想额外管理 S3 Vectors 的开发者提供了可行方案。
DynamoDB 在 2026 年 8 月正式支持向量数据,但单次查询最多返回 100 条结果,限制了 RAG 方案中“先广泛检索再重排”的实现。
通过把分区键拆成多值(分片)并并行查询,每个分片返回 100 条,再合并排序,可实现等价于 TopK=500 的效果。
- 分片方案:使用
hash(chunk_id) % N_SHARDS 将数据均匀分配到 5 个分片。- 查询流程:并行发起 5 次查询 → 合并去重 → 按距离排序。
- 效果:单次查询 500 条候选块,源文档数从 1 增至 10。
- 成本:单查询 112 KB,5 分片 367 KB,月 1 M 次查询成本从 0.24 USD 提升至 0.78 USD。
- 注意:分片数变更需重新导入;并行查询受调用方 CPU 限制,单线程 CPU 低时并行无效。
此方法将分区键从“限制搜索范围”转为“扩展结果数量”,为想用 DynamoDB 进行 RAG、重排且不想额外管理 S3 Vectors 的开发者提供了可行方案。